核心要点
- Kimi K3.1 Pro 拥有 100 万 Token 的上下文窗口,专为编程、3D 创作、金融研究以及长时间运行的智能体任务而设计。
- 其 API 价格为 输入每百万 Token 2 美元 和 输出每百万 Token 10 美元,缓存输入享有 90% 的折扣。
- Kimi 在 Terminal-Bench 4.0 上的得分为 65.7%,接近 Claude Opus 5.5 的 66.4%,并领先于 GPT-6 Astra 的 58.2%。
- Kimi 在多个长上下文和金融基准测试中处于领先地位,包括 SWE-Marathon v1.1 和 OfficeQA Pro v2。
- GPT-6 Astra 在 Terminal-Bench Science 0.1 上的表现要好得多,这表明它在科学和研究智能体工作流方面可能更具优势。
- Kimi 较低的 Token 价格并不总是意味着最终账单更低,因为智能体任务可能会消耗大量的输出 Token。
- ChatGOAT AI 允许用户在同一个界面中访问 Kimi K3.1 Pro,以及 Claude Opus 5.5、GPT-6 Astra、Gemini、Grok、DeepSeek 等其他模型。
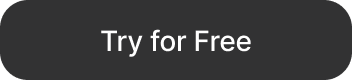
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra:你应该使用哪个 AI 模型?
选择 AI 模型不再只是挑选“最聪明”的一个。最好的模型取决于你正在构建的内容:编程智能体、金融研究助手、3D 原型、研究工作流,还是成本敏感型生产应用。
本对比从真实世界的任务、基准测试结果、定价和实际优势等方面,对 Kimi K3.1 Pro、Claude Opus 5.5 和 GPT-6 Astra 进行了评估。
什么是 Kimi K3.1 Pro?
Kimi K3.1 Pro 是 Moonshot AI(月之暗面)K3.1 系列中的首款模型,也是该公司迄今为止能力最强的模型。它是一个拥有 3 万亿参数的模型,具有 100 万 Token 的上下文窗口,非常适合大型代码库、冗长的报告、多步骤智能体任务以及复杂的研究项目。
Moonshot 围绕四大主要改进对 K3.1 Pro 进行了定位:
- 编程
- 3D 创作
- 金融研究
- 长视野智能体能力
它还支持 Unity、Unreal、Godot 和 Three.js 等工具,这使得它对构建游戏、互动网站和 3D 体验的开发者极具吸引力。
Kimi K3.1 Pro 定价
| 计划 / 访问权限 | 价格 | 备注 |
|---|---|---|
| API 输入 | 每百万 Token 2 美元 | 低于 Kimi K3 之前的 3 美元输入价格。 |
| API 输出 | 每百万 Token 10 美元 | 低于 Kimi K3 之前的 15 美元输出价格。 |
| 缓存输入 | 约每百万 Token 0.20 美元 | 基于 90% 的缓存折扣。 |
| 高速版本 | 约为标准定价的 2 倍 | 在保持相似智能水平的同时,提供约 2-3 倍的更快输出。 |
低廉的标价很有吸引力,但跟踪实际的 Token 使用量至关重要。在某次 Artificial Analysis 测试中,Kimi 消耗了约 1.5 亿个输出 Token,高于 8700 万的中位数,这可能会增加长智能体任务的总成本。
Kimi K3.1 Pro 基准测试
Kimi K3.1 Pro 在编程智能体、长视野软件工程、网络研究和金融文档分析方面表现尤为出色。然而,它并不是所有任务的最佳模型。
| 基准测试 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | 含义 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | Kimi 在终端编程智能体工作方面几乎与 Claude 持平。 |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | Kimi 在长视野软件工程方面处于领先地位。 |
| HLE-Full with tools | 70.0% | 67.7% | 57.2% | Kimi 在带工具的困难知识推理方面表现强劲。 |
| BrowseComp | 92.1% | 90.8% | 91.5% | 三者在网络研究方面都很强。 |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | Kimi 在金融和办公文档分析方面表现强劲。 |
| Terminal-Bench Science 0.1 | 38.1 | 63.3 | 68.1 | GPT-6 Astra 在科学导向的终端工作流方面领先。 |
主要的启示很简单:Kimi 不仅仅是“更便宜的 Claude”。它在智能体编程和文档繁重的工作中极具竞争力,但对于科学研究工作流,GPT-6 Astra 可能是更好的选择。
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra
1. 修复真实代码库中的 Bug
任务:向每个模型提供包含几个隐藏 Bug 的相同代码仓库。要求其定位问题、编写修复方案、添加测试并解释更改。
衡量指标:
- 是否找到根本原因
- 重试次数
- 测试是否通过
- 代码质量
- 总 Token 数与成本
预期结果:Kimi 在长视野工程基准测试中表现良好,但独立的真实代码库测试表明,它在遗留 Bug 修复方面可能并不总是领先。一项第三方测试发现,Kimi 在真实世界 Bug 修复评估中得分为 36,低于 Claude Opus 5.5 的 41.7。
最佳选择:用于困难的遗留代码调试时选择 Claude Opus 5.5;用于大型重构和智能体驱动的开发时选择 Kimi K3.1 Pro。
2. 将 PRD(产品需求文档)转化为可用的 Web 应用
任务:提供产品需求文档,并要求每个模型构建一个可用的 Web 应用程序,包括前端、后端、数据库架构和部署说明。
衡量指标:
- 功能完整性
- 代码组织
- UI 质量
- 处理项目中期需求变更的能力
- 应用是否能在无需手动修复的情况下运行
预期结果:Kimi 专为智能体编程而设计,支持前端和 3D 导向的工作流,但独立评估表明,它在视觉打磨、动画和网站创建方面可能仍然落后于某些西方旗舰模型。
最佳选择:用于快速工程原型时选择 Kimi;如果视觉质量和迭代设计是首要任务,则选择 Claude 或 GPT-6 Astra。
3. 分析冗长的金融报告
任务:上传一份 300 页的年报、行业报告和电子表格。要求模型提取财务指标、识别风险、构建三年预测,并为每一项陈述引述页码。
衡量指标:
- 提取数字的准确性
- 引文质量
- 跨文档连接数据的能力
- 财务模型质量
- 幻觉率
预期结果:这是 Kimi 最强大的用例之一。它在 OfficeQA Pro v2 上的得分为 64.4,领先于 Claude Opus 5.5 的 62.2 和 GPT-6 Astra 的 54.4。
最佳选择:用于长金融文档、电子表格分析和研究繁重的商业工作时选择 Kimi K3.1 Pro。
4. 构建 3D 原型
任务:要求每个模型根据简短的简介创建一个交互式 Three.js 场景、Godot 小游戏或 Unity 原型。
衡量指标:
- 资产质量
- 交互完整性
- 工具使用情况
- 视觉打磨度
- 根据反馈进行修改的能力
预期结果:Kimi 在这一类别中表现强劲,因为 Moonshot 专门改进了 3D 创作和工具集成。然而,它并不是自动成为最好的创意模型;独立测试发现它在某些 3D 和网站生成任务中存在差距。
最佳选择:用于快速可玩原型时选择 Kimi;根据您的测试结果,如果追求更高打磨度的创意输出,则选择 Claude 或 GPT-6 Astra。
5. 多步骤在线研究
任务:要求每个模型研究一个市场,识别 10 家重要公司,验证声明,并生成一份附带来源的报告。
衡量指标:
- 来源质量
- 事实准确性
- 避免重复的能力
- 分析深度
- 引文可靠性
预期结果:Kimi 在 BrowseComp 上的得分为 92.1%,略领先于 Claude Opus 5.5 和 GPT-6 Astra。这表明它在基于网络的的信息检索方面能力极强。
最佳选择:一般网络研究选择 Kimi;科学研究和技术调查选择 GPT-6 Astra。
6. 成本与速度测试
任务:在每个模型上运行相同的 10 步骤智能体工作流,并比较总成本、延迟、输出 Token 数、重试次数和最终质量。
| 指标 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| API 输入价格 | $2 / 百万 Token | 更高 | 因提供商和计划而异。 |
| API 输出价格 | $10 / 百万 Token | 更高 | 因提供商和计划而异。 |
| Artificial Analysis 任务成本 | $2.11 | $5.98 | $3.26 |
| 输出 Token 使用量 | 在某些智能体测试中较高 | 在引用的测试中较低 | 在引用的测试中适中 |
| 最适合 | 长上下文、编程智能体、金融 | 要求严苛的软件工程 | 研究和科学智能体 |
Kimi 较低的价格是真实的,但您的最终账单取决于模型使用的 Token 数量。对于重复的提示词,缓存可以带来重大改变。
你应该选择哪个模型?
| 用例 | 最佳模型 | 原因 |
|---|---|---|
| 长金融文档 | Kimi K3.1 Pro | 强劲的 OfficeQA 性能和 1M Token 上下文。 |
| 智能体编程 | Kimi K3.1 Pro 或 Claude Opus 5.5 | Kimi 领跑部分长视野编程测试;Claude 在终端编程中依然极佳。 |
| 遗留 Bug 修复 | Claude Opus 5.5 | 在某些独立的真实代码库 Bug 修复测试中更强。 |
| 科学研究智能体 | GPT-6 Astra | 在 Terminal-Bench Science 0.1 中大幅领先。 |
| 成本敏感型 API 应用 | Kimi K3.1 Pro | 更低的标称输入/输出定价和强劲的基准测试价值。 |
| 3D 与游戏原型 | Kimi K3.1 Pro | 专为 3D 创作以及 Unity、Unreal、Godot 和 Three.js 等工具构建。 |
| 通用网络研究 | Kimi K3.1 Pro | 在 BrowseComp 上略微领先。 |
如何亲自测试这些模型
不要只依赖基准测试图表。在每个模型中运行相同的提示词并为结果评分。
使用这个简单的测试框架:
- 选择一项你每周实际都在做的任务。
- 编写一份带有清晰交付成果的详细提示词。
- 在 Kimi K3.1 Pro、Claude Opus 5.5 和 GPT-6 Astra 上运行它。
- 记录完成质量、所需的修改、延迟和 Token 使用量。
- 重复测试三次。
- 计算可用结果的成本,而不仅仅是每百万 Token 的成本。
这种方法可以帮助你避免最常见的错误:选择一个模型是因为它赢了一个基准测试,而不是因为它在你的工作流中表现最好。
在 ChatGOAT AI 上试用 Kimi K3.1 Pro
你不需要单独的账户或 API 密钥来对比这些模型。ChatGOAT AI 是一个多合一的 AI 平台,在一个工作区中提供对多个领先模型的访问,包括 Kimi K3.1 Pro、Claude Opus 5.5、GPT-6 Astra、Gemini 4 Carbon、Grok 4.7 和 DeepSeek。
使用 ChatGOAT AI,你可以:
- 直接在浏览器中与 Kimi K3.1 Pro 聊天。
- 使用相同的提示词对比 Kimi 与 Claude Opus 5.5 和 GPT-6 Astra。
- 将 AI 用于编程、研究、写作、电子表格、演示文稿、图像和多步骤智能体任务。
- 切换模型,而无需重建工作流或管理多个订阅。
例如,如果你正在分析一份财务报告,你可以让 Kimi K3.1 Pro 提取指标并构建模型,然后让 Claude Opus 5.5 审查逻辑,或者让 GPT-6 Astra 研究市场风险。这种“模型切换”工作流通常比绑定单一 AI 提供商更有用。
常见问题解答
Kimi K3.1 Pro 比 Claude Opus 5.5 更好吗?
这取决于任务。Kimi 在某些长视野编程、金融分析和检索基准测试中处于领先地位,而 Claude Opus 5.5 在 Terminal-Bench 4.0 中仍然略微领先,并且在某些真实的调试任务中可能更强。
Kimi K3.1 Pro 比 GPT-6 Astra 更好吗?
对于长上下文编程、金融文档和通用网络研究,Kimi 具有极强的竞争力。对于科学终端工作流,根据 Terminal-Bench Science 0.1 的结果,GPT-6 Astra 具有明显的优势。
Kimi K3.1 Pro 多少钱?
通过 API 使用时,Kimi K3.1 Pro 的价格为 输入每百万 Token 2 美元 和 输出每百万 Token 10 美元。缓存输入的费用约为每百万 Token 0.20 美元。
Kimi K3.1 Pro 真的有 100 万上下文吗?
是的。Moonshot 表示 K3.1 Pro 支持 100 万 Token 的上下文窗口,这对于大型代码库、长报告和多文档分析非常有用。
我可以将 Kimi K3.1 Pro 用于编程吗?
可以。编程是其主要优势之一,尤其是智能体编程、长视野软件工程和基于终端的开发任务。
我可以在 ChatGOAT AI 上使用 Kimi K3.1 Pro 吗?
可以。ChatGOAT AI 将 Kimi K3.1 Pro 列在其可用模型中,同时还提供 Claude Opus 5.5、GPT-6 Astra、Gemini、Grok 和 DeepSeek。
哪个模型最适合初学者?
对于初学者,建议从 ChatGOAT AI 开始,因为它允许你在一个地方试用多个模型。长文档和编程使用 Kimi,严谨的软件工程使用 Claude,研究繁重的任务使用 GPT-6 Astra。
因为 Kimi 更便宜,所以我应该选择它吗?
不一定。Kimi 的 Token 价格较低,但智能体任务可能会生成大量的输出 Token。请测试完整的工作流并比较最终成本,而不仅仅是公布的费率。