การแข่งขันระหว่าง Gemini 4 Argon, GPT-6 Astra และ Claude Opus 5.5 สะท้อนให้เห็นถึงการเปลี่ยนแปลงครั้งสำคัญในวงการปัญญาประดิษฐ์ โมเดลชั้นนำในปัจจุบันไม่ได้ถูกตัดสินแค่เพียงว่าตอบคำถามได้ดีแค่ไหนอีกต่อไป แต่นักพัฒนา นักวิจัย และผู้ใช้งานทั่วไปต่างต้องการ AI ที่สามารถแก้ปัญหาที่ซับซ้อน เข้าใจโครงการขนาดใหญ่ เขียนโค้ดที่เชื่อถือได้ วิเคราะห์เอกสาร และทำงานหลายขั้นตอนได้โดยใช้การกำกับดูแลที่น้อยลง
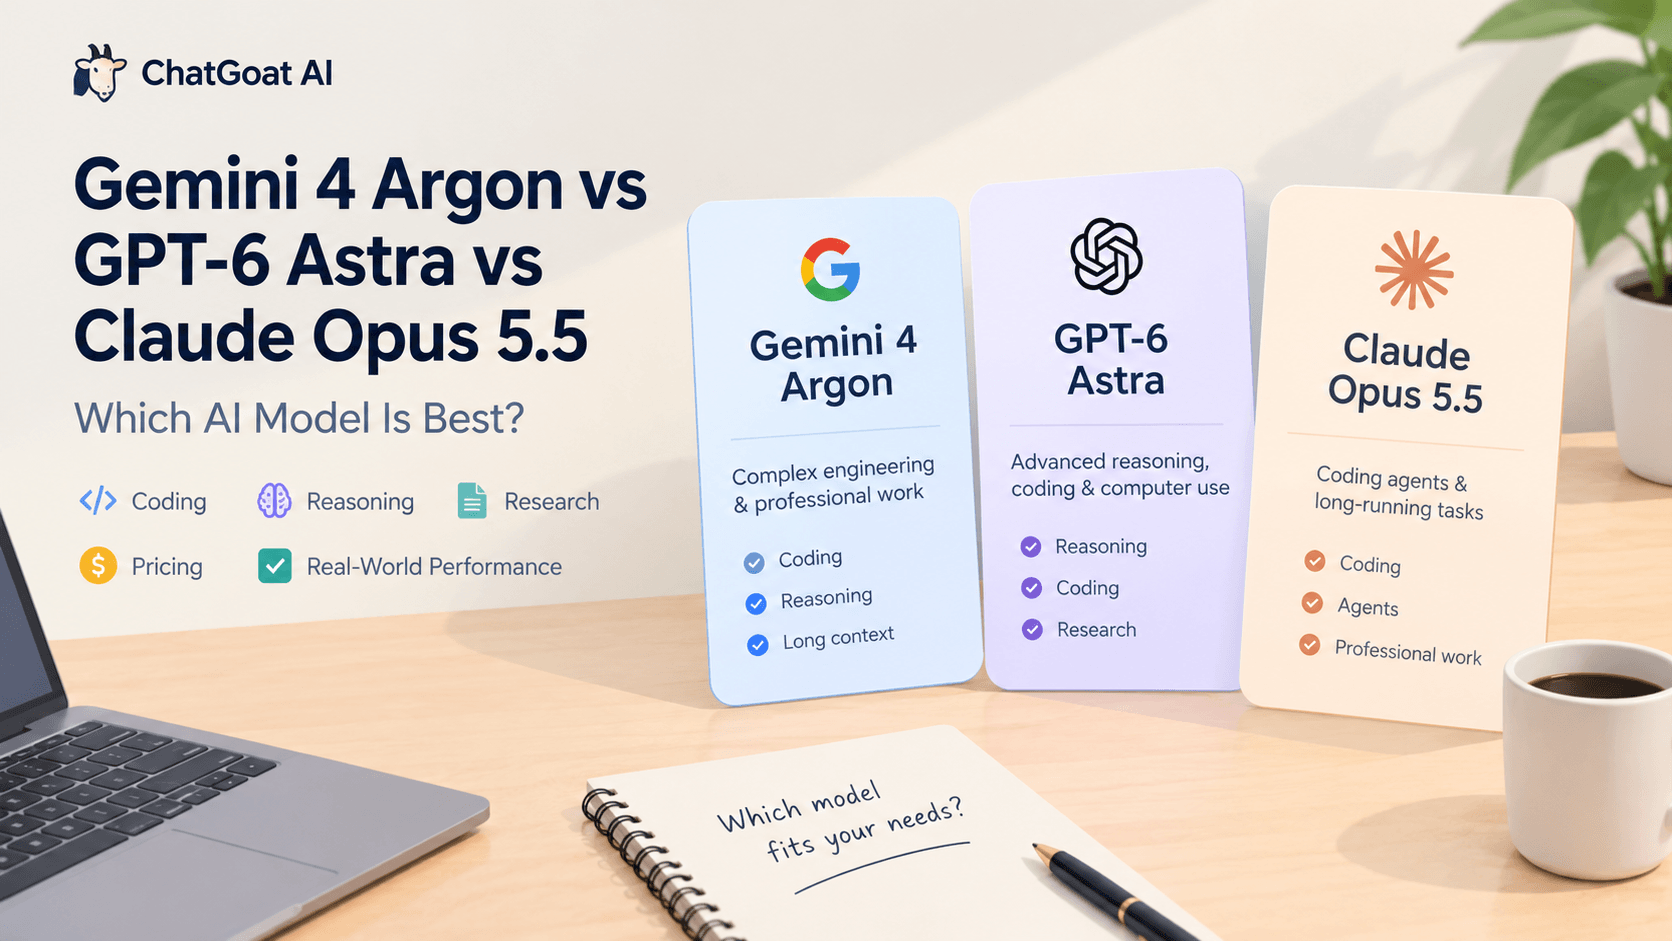
แต่ละโมเดลมีจุดแข็งที่แตกต่างกัน Google วางตำแหน่ง Gemini 4 Argon ไว้สำหรับงานวิศวกรรมที่ซับซ้อน งานสายความรู้ระดับมืออาชีพ และการป้องกันความปลอดภัยทางไซเบอร์ OpenAI นำเสนอ GPT-6 Astra ในฐานะโมเดลสำหรับงานที่ต้องใช้การเหตุผลขั้นสูง การเขียนโค้ด งานวิจัย และงานควบคุมคอมพิวเตอร์ ส่วน Anthropic เน้นย้ำความสามารถของ Claude Opus 5.5 ในด้านวิศวกรรมซอฟต์แวร์ เอเจนต์ที่ทำงานระยะยาว และงานระดับมืออาชีพ
แต่คุณควรเลือกโมเดลไหน? Gemini 4 Argon เก่งเรื่องการเขียนโค้ดมากกว่าจริงหรือไม่? GPT-6 Astra คุ้มค่ากับราคา API ที่สูงกว่าหรือไม่? Claude Opus 5.5 สามารถทำโครงการที่ซับซ้อนให้สำเร็จโดยใช้คำสั่งที่น้อยลงได้หรือไม่?
การเปรียบเทียบนี้จะพิจารณาผลการทดสอบเกณฑ์มาตรฐานอย่างเป็นทางการ ราคา ความพร้อมใช้งาน กรณีการใช้งานจริง และการอภิปรายจาก Reddit นอกจากนี้ยังอธิบายวิธีประเมินโมเดลเหล่านี้สำหรับการทำงานจริง และการสำรวจเวิร์กโฟลว์ที่ขับเคลื่อนด้วย AI ผ่าน ChatGOAT AI
ข้อสรุปสั้นๆ: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
ไม่มีโมเดลใดที่เป็นผู้ชนะเด็ดขาดสำหรับทุกงาน ตัวเลือกที่ดีที่สุดขึ้นอยู่กับงานที่คุณต้องทำ งบประมาณของคุณ และความสามารถในการเข้าถึงโมเดลผ่านแพลตฟอร์มที่คุณต้องการ
| การเปรียบเทียบ | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| การวางตำแหน่งหลัก | งานวิศวกรรมที่ซับซ้อนและเวิร์กโฟลว์ระดับมืออาชีพ | การใช้เหตุผลขั้นสูง การเขียนโค้ด งานวิจัย และการควบคุมคอมพิวเตอร์ | เอเจนต์เขียนโค้ดและงานระดับมืออาชีพที่ทำงานระยะยาว |
| การเขียนโค้ด | ผลลัพธ์ที่แข็งแกร่งในการทดสอบเกณฑ์มาตรฐานวิศวกรรมซอฟต์แวร์ที่ได้รับเลือก | แข็งแกร่งในงานเขียนโค้ดและงานทางเทคนิคที่ต้องใช้การเหตุผลเข้มข้น | ออกแบบมาสำหรับการเขียนโค้ดที่ซับซ้อนและเวิร์กโฟลว์เอเจนต์ |
| การใช้เหตุผล | ออกแบบมาสำหรับการแก้ปัญหาที่ซับซ้อนและหลายขั้นตอน | สร้างขึ้นสำหรับการใช้เหตุผลที่ท้าทายและงานระดับมืออาชีพ | แข็งแกร่งในการทำตามคำสั่งที่ซับซ้อนและการทำงานอย่างต่อเนื่อง |
| งานบริบทยาว | ประกาศการส่งออกสูงสุดถึง 1 ล้านโทเค็น | หน้าต่างบริบทขนาด 1.05 ล้านโทเค็น | เวิร์กโฟลว์เอเจนต์ที่ทำงานระยะยาวและโครงการขนาดใหญ่ |
| ราคา API ขาเข้ามาตรฐาน | $2 ต่อ 1 ล้านโทเค็น | $10 ต่อ 1 ล้านโทเค็น | $4 ต่อ 1 ล้านโทเค็น |
| ราคา API ขาออกมาตรฐาน | $10 ต่อ 1 ล้านโทเค็น | $50 ต่อ 1 ล้านโทเค็น | $20 ต่อ 1 ล้านโทเค็น |
| ความพร้อมใช้งาน | ในช่วงแรกจำกัดเฉพาะผู้ปกป้องความปลอดภัยไซเบอร์ที่ได้รับความไว้วางใจ | พร้อมใช้งานผ่านผลิตภัณฑ์และ API ที่รองรับของ OpenAI | พร้อมใช้งานผ่านแพลตฟอร์ม Claude และแพลตฟอร์มนักพัฒนาที่รองรับ |
แหล่งที่มา: ประกาศ Gemini 4 Argon ของ Google, เอกสารโมเดล GPT-6 Astra ของ OpenAI และ เอกสาร Claude Opus ของ Anthropic
โมเดลเหล่านี้ไม่ควรได้รับการจัดอันดับโดยใช้ราคาหรือเกณฑ์มาตรฐานเพียงอย่างเดียว โมเดลที่มีราคาต่อโทเค็นถูกกว่าอาจต้องลองใหม่หลายครั้งเพื่อทำงานให้เสร็จ ในขณะที่โมเดลที่มีคะแนนเกณฑ์มาตรฐานน่าประทับใจอาจไม่สามารถเข้าถึงได้สำหรับผู้ใช้ทั่วไป
ข้อสรุปที่นำไปใช้ได้จริง: เปรียบเทียบคุณภาพของผลลัพธ์สุดท้าย เวลาที่ใช้ จำนวนครั้งในการแก้ไข และค่าใช้จ่ายจริงในการทำภารกิจของคุณให้เสร็จสิ้น
Gemini 4 Argon: สร้างขึ้นสำหรับงานวิศวกรรมที่ซับซ้อนและงานสายความรู้
Google ประกาศเปิดตัว Gemini 4 Argon เมื่อวันที่ 30 กันยายน 2026 โดยวางตำแหน่งให้เป็นโมเดลชั้นนำสำหรับงานวิศวกรรมซอฟต์แวร์ในโลกแห่งความเป็นจริง งานสายความรู้ในองค์กร และการป้องกันความปลอดภัยทางไซเบอร์
ต่างจากโมเดลที่ออกแบบมาสำหรับการสนทนาทั่วไปในชีวิตประจำวัน Argon ถูกนำเสนอในฐานะระบบที่สามารถจัดการงานที่ยาวและเชื่อมโยงกันอย่างซับซ้อน สิ่งเหล่านี้อาจรวมถึงการตรวจสอบข้อมูลทางเทคนิคจำนวนมาก การระบุปัญหา การวางแผนลำดับขั้นตอน และการสร้างผลลัพธ์สุดท้าย
จุดแข็งสำคัญ
งานวิศวกรรมซอฟต์แวร์ที่ซับซ้อน
Argon แสดงผลลัพธ์ที่แข็งแกร่งในการทดสอบเกณฑ์มาตรฐานวิศวกรรมซอฟต์แวร์ที่ได้รับเลือก ประกาศของ Google เน้นย้ำถึงงานวิศวกรรมระยะยาว ซึ่งระบบ AI ต้องรักษาบริบทไว้ในขณะที่ทำงานผ่านปัญหาที่ซับซ้อน
การประเมินการใช้งานที่เป็นไปได้ ได้แก่ การตรวจสอบโค้ดเบสขนาดใหญ่ การระบุต้นตอของบั๊ก การวางแผนย้ายระบบ และการประเมินว่าการเปลี่ยนแปลงที่เสนอสามารถแก้ปัญหาดั้งเดิมได้หรือไม่
งานวิจัยระดับมืออาชีพและการวิเคราะห์เอกสาร
Google ยังเน้นย้ำถึงงานด้านกฎหมาย การเงิน และงานสายความรู้อื่นๆ ในองค์กร ทำให้งานที่ต้องใช้เอกสารจำนวนมากเป็นพื้นที่สำคัญในการประเมิน โดยเฉพาะอย่างยิ่งเมื่อโมเดลต้องเชื่อมโยงข้อมูลจากไฟล์หลายๆ ไฟล์เข้าด้วยกัน
ตัวอย่างเช่น นักวิเคราะห์ธุรกิจสามารถใช้เวิร์กโฟลว์ AI เพื่อสรุปรายงาน ดึงตัวเลขทางการเงิน เปรียบเทียบข้อสันนิษฐาน และจัดเตรียมสรุปข้อมูลที่มีโครงสร้างสำหรับการตรวจสอบโดยมนุษย์
การส่งออกข้อมูลแบบยาว
Google ประกาศขีดจำกัดการส่งออกสูงสุดไม่เกินหนึ่งล้านโทเค็นสำหรับ Argon นี่คือโควตาการส่งออกผลลัพธ์ ซึ่งไม่ใช่สิ่งเดียวกับหน้าต่างบริบท ความแตกต่างนี้มีความสำคัญเมื่อเปรียบเทียบโมเดล เนื่องจากปริมาณข้อมูลที่โมเดลสามารถรับได้และปริมาณข้อมูลที่สามารถสร้างได้นั้นเป็นความสามารถคนละส่วนกัน
ข้อจำกัดคืออะไร?
ข้อจำกัดในทางปฏิบัติที่ใหญ่ที่สุดคือการเข้าถึง ในช่วงเปิดตัว Google กำลังทยอยเปิดให้ใช้งาน Argon แก่ผู้ปกป้องความปลอดภัยไซเบอร์ที่ได้รับความไว้วางใจผ่านโครงการ Fairwind Program โดยมีแผนจะเปิดให้ใช้งานในวงกว้างในระยะต่อไป
นั่นหมายความว่าผลลัพธ์ที่เผยแพร่ไม่ควรถูกมองโดยอัตโนมัติว่าผู้ใช้ทั่วไปจะสามารถทดสอบซ้ำได้อย่างเป็นอิสระ
นอกจากนี้ คะแนนเกณฑ์มาตรฐานที่สูงก็ไม่ได้การันตีว่า Argon จะทำงานได้ดีกว่าโมเดลอื่นในทุกภาษาโปรแกรม งานวิจัย หรือโครงการในโลกจริง
สำหรับข้อมูลเพิ่มเติม ดูที่ ประกาศอย่างเป็นทางการของ Google เกี่ยวกับ Gemini 4 Argon
GPT-6 Astra: การใช้เหตุผลขั้นสูง การเขียนโค้ด และการควบคุมคอมพิวเตอร์
OpenAI อธิบายว่า GPT-6 Astra เป็นโมเดลสำหรับงานระดับมืออาชีพที่ท้าทาย รวมถึงการใช้เหตุผลที่ซับซ้อน การพัฒนาซอฟต์แวร์ งานวิจัย การสร้างเอกสาร และการควบคุมคอมพิวเตอร์
คุณค่าของมันไม่ได้จำกัดอยู่แค่การให้คำตอบที่ดีในการโต้ตอบเพียงครั้งเดียว สำหรับเวิร์กโฟลว์ที่เหมาะสม เป้าหมายคือการใช้เหตุผลเพื่อแก้ปัญหา ใช้เครื่องมือที่มีอยู่ และทำงานเพื่อมุ่งสู่ผลลัพธ์ที่กำหนดไว้อย่างชัดเจน
จุดแข็งสำคัญ
การใช้เหตุผลขั้นสูง
GPT-6 Astra ออกแบบมาสำหรับปัญหาที่ต้องการมากกว่าการค้นหาข้อเท็จจริงหรือการสร้างคำตอบสั้นๆ สามารถประเมินได้จากการใช้เหตุผลทางคณิตศาสตร์ การวางแผน คำถามทางเทคนิคที่ซับซ้อน และภารกิจที่มีข้อจำกัดหลายประการ
ตัวอย่างเช่น ผู้จัดการผลิตภัณฑ์สามารถขอให้โมเดลเปรียบเทียบกลยุทธ์ผลิตภัณฑ์ของคู่แข่ง ระบุความเสี่ยง สร้างกรอบการตัดสินใจ และจัดทำแผนการดำเนินงาน
การพัฒนาซอฟต์แวร์และการแก้ไขบั๊ก
Astra สามารถช่วยนักพัฒนาสร้างโค้ด ตรวจสอบการใช้งานที่มีอยู่ วินิจฉัยข้อผิดพลาด และทำงานผ่านภารกิจทางวิศวกรรมที่ซับซ้อนยิ่งขึ้น
การทดสอบที่มีประโยชน์ ได้แก่ การแก้ไขบั๊กในโครงการที่ไม่คุ้นเคย การแก้ไขไฟล์หลายไฟล์ การสร้าง Unit test และการตรวจสอบว่าการทำงานสุดท้ายตรงตามความต้องการหรือไม่
การควบคุมคอมพิวเตอร์และเวิร์กโฟลว์เอเจนต์
OpenAI ยังได้ระบุความสามารถที่เกี่ยวข้องกับการควบคุมคอมพิวเตอร์ อย่างไรก็ตาม ระบบอัตโนมัติที่แท้จริงนั้นขึ้นอยู่กับเครื่องมือ สิทธิ์การใช้งาน และมาตรการความปลอดภัยที่จัดไว้ในสภาพแวดล้อมที่โมเดลทำงาน
ความสามารถของโมเดลในการวางแผนงานไม่ได้หมายความว่าทุกอินเทอร์เฟซแชทจะอนุญาตให้โมเดลท่องเว็บไซต์ ใช้งานแอปพลิเคชัน หรือรันโค้ดได้โดยอัตโนมัติ
ข้อจำกัดคืออะไร?
GPT-6 Astra มีราคาโทเค็น API มาตรฐานสูงกว่าอีกสองโมเดลในการเปรียบเทียบนี้ อัตราที่ประกาศไว้คือ $10 ต่อ 1 ล้านโทเค็นขาเข้า และ $50 ต่อ 1 ล้านโทเค็นขาออก ก่อนรวมส่วนลด Caching ค่าธรรมเนียมเครื่องมือ และค่าบริการอื่นๆ
สำหรับผู้ใช้ที่รันการสนทนาที่ยาวนานหลายครั้งหรือเวิร์กโฟลว์อัตโนมัติขนาดใหญ่ ค่าใช้จ่ายอาจเพิ่มขึ้นอย่างรวดเร็ว
ดังนั้น โมเดลนี้จึงควรได้รับการประเมินจากคุณภาพของงานที่สำเร็จ ไม่ใช่แค่สติปัญญาดิบของมัน หากทางเลือกที่มีราคาถูกกว่าให้ผลลัพธ์ที่เชื่อถือได้เท่ากันสำหรับงานประจำ การจ่ายเงินสำหรับโมเดลที่มีราคาแพงกว่าก็อาจไม่มีความจำเป็น
อ่านเพิ่มเติมใน เอกสาร GPT-6 Astra ของ OpenAI
Claude Opus 5.5: เอเจนต์เขียนโค้ดและงานที่ทำงานระยะยาว
Claude Opus 5.5 วางตำแหน่งไว้สำหรับงานวิศวกรรมซอฟต์แวร์ที่ท้าทาย เวิร์กโฟลว์เอเจนต์ที่ทำงานระยะยาว และงานระดับมืออาชีพ สิ่งที่ดึงดูดใจนักพัฒนาหลายคนคือความเป็นไปได้ในการมอบหมายงานที่ซับซ้อน โดยที่โมเดลยังคงรักษาข้อกำหนดดั้งเดิมไว้ตลอดกระบวนการ
สิ่งนี้มีความสำคัญเป็นพิเศษเมื่อโครงการเกี่ยวข้องกับหลายไฟล์ ส่วนประกอบที่เกี่ยวเนื่องกันหลายรายการ หรือลำดับการตัดสินใจที่ยาวนาน
จุดแข็งสำคัญ
ความเข้าใจในโค้ดเบส
โมเดลการเขียนโค้ดที่มีประโยชน์ต้องเข้าใจว่าส่วนต่างๆ ของโครงการมีปฏิสัมพันธ์กันอย่างไร ควรจะสามารถระบุสาเหตุของบั๊ก กำหนดว่าไฟล์ใดบ้างที่ต้องแก้ไข และหลีกเลี่ยงการสร้างข้อผิดพลาดใหม่ในส่วนอื่น
Claude Opus 5.5 เป็นตัวเลือกที่แข็งแกร่งในการประเมินสำหรับเวิร์กโฟลว์เหล่านี้ โดยเฉพาะอย่างยิ่งเมื่อภารกิจต้องใช้ความใส่ใจอย่างต่อเนื่องต่อโครงสร้างและข้อกำหนดของโครงการ
คำสั่งที่ซับซ้อนและการเขียน
งานระดับมืออาชีพหลายอย่างเกี่ยวข้องกับคำสั่งโดยละเอียดที่ไม่สามารถลดทอนเหลือเพียงคำถามเดียวได้ ผู้ใช้อาจระบุกลุ่มเป้าหมาย น้ำเสียง ข้อจำกัดทางเทคนิค กฎการจัดรูปแบบ และรายการผลลัพธ์ที่ต้องการ
Claude สามารถได้รับการประเมินว่าปฏิบัติตามข้อจำกัดเหล่านั้นได้ดีเพียงใด รักษาความสม่ำเสมอ และสร้างผลงานที่ต้องแก้ไขเพิ่มเติมเพียงเล็กน้อย
เวิร์กโฟลว์เอเจนต์ที่ทำงานระยะยาว
สำหรับทีมพัฒนา เอเจนต์ AI อาจจำเป็นต้องตรวจสอบโครงการ ทำการเปลี่ยนแปลง รันการทดสอบ ตีความข้อผิดพลาด และปรับปรุงการทำงาน
จำนวนขั้นตอนที่ทำสำเร็จมักจะมีความหมายมากกว่าคุณภาพของคำตอบแรก
ข้อจำกัดคืออะไร?
โมเดลที่มีความสามารถสูงยังคงอาจทำให้งานซับซ้อนเกินความจำเป็น สร้างข้อสันนิษฐานที่ผิดพลาด หรือใช้โควตาการใช้งานไปจำนวนมากในระหว่างเซสชันที่ยาวนาน
ขีดจำกัดการเข้าถึงและกฎการสมัครสมาชิกก็มีความสำคัญเช่นกัน การอภิปรายในชุมชนมักกล่าวถึงขีดจำกัดการใช้งาน แม้ว่าผู้ใช้จะพึงพอใจกับคุณภาพของโมเดลก็ตาม
อัตรา API มาตรฐานที่ประกาศไว้ของ Claude Opus 5.5 คือ $4 ต่อ 1 ล้านโทเค็นขาเข้า และ $20 ต่อ 1 ล้านโทเค็นขาออก ซึ่งต่ำกว่าอัตรามาตรฐานของ Astra แม้ว่าค่าใช้จ่ายจริงจะขึ้นอยู่กับรูปแบบการใช้งาน การทำ Caching และบริการเพิ่มเติมก็ตาม
ดู เอกสารอย่างเป็นทางการของ Claude Opus จาก Anthropic สำหรับข้อมูลผลิตภัณฑ์และราคาปัจจุบัน
ผลการทดสอบเกณฑ์มาตรฐานบอกอะไรเราบ้างจริง?
คะแนนเกณฑ์มาตรฐานมีประโยชน์ในการเข้าใจความสามารถของโมเดล แต่ไม่ได้บอกเรื่องราวทั้งหมด
การทดสอบที่แตกต่างกันจะวัดทักษะที่แตกต่างกัน โมเดลที่ทำผลงานได้ดีในการทดสอบเกณฑ์มาตรฐานวิศวกรรมซอฟต์แวร์ระยะยาว อาจไม่ใช่ตัวเลือกที่ดีที่สุดสำหรับการวิจัยข้อเท็จจริง การเขียน หรือการวิเคราะห์ด้วยภาพ
ประกาศ Argon ของ Google และผลการประเมิน GPT-6 Astra ที่เผยแพร่ ให้ประเด็นการเปรียบเทียบที่มีประโยชน์หลายประการ
ผลการทดสอบเกณฑ์มาตรฐานการเขียนโค้ดที่ได้รับเลือก
| เกณฑ์มาตรฐาน | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | ประมาณ 78% | 74.1% | ประมาณ 74% |
| FrontierSWE v2 | ดูการประเมินที่เผยแพร่ของ Google | มีรายงานข้อได้เปรียบในการเปรียบเทียบที่มีอยู่ | ดูการประเมินที่เผยแพร่ของ Google |
| Terminal-Bench 4.0 | ดูการประเมินที่เผยแพร่ของ Google | 57.9% ในผลลัพธ์ที่เผยแพร่ของ OpenAI | อาจใช้ผลการประเมินที่แตกต่างกัน |
แหล่งที่มา: ประกาศ Argon ของ Google, เอกสารโมเดล Astra ของ OpenAI และ การเปรียบเทียบ Argon กับคู่แข่งในเดือนตุลาคม 2026
สำคัญ: ตัวเลขเหล่านี้ควรได้รับการพิจารณาในฐานะผลลัพธ์ที่มีการรายงาน ไม่ใช่การเปรียบเทียบที่เป็นอิสระและได้รับการควบคุมอย่างสมบูรณ์ ผลลัพธ์อาจแตกต่างกันไปตามเวอร์ชันของโมเดล เครื่องมือทดสอบ การเข้าถึงเครื่องมือ การตั้งค่าการใช้เหตุผล และวันที่ประเมิน ในกรณีที่แหล่งที่มาดั้งเดิมไม่ได้ระบุตัวเลขที่เปรียบเทียบกันได้โดยตรง ตารางจะหลีกเลี่ยงการสร้างตัวเลขขึ้นมาเองโดยเจตนา
ผลลัพธ์ที่มีอยู่ยังแสดงให้เห็นว่าเหตุใดการจัดอันดับแบบครอบจักรวาลจึงอาจทำให้เข้าใจผิด มีรายงานว่า Argon เป็นผู้นำใน DeepSWE v1.1 ในขณะที่ Astra และ Opus สามารถทำผลงานได้แตกต่างกันในการประเมินวิศวกรรมซอฟต์แวร์อื่นๆ
แนวทางที่ดีกว่าคือการถามว่าเกณฑ์มาตรฐานใดที่มีลักษณะคล้ายกับปริมาณงานจริงของคุณ
- สำหรับการบำรุงรักษาโค้ด ให้ความสำคัญกับงานในคลังเก็บโค้ดจริงและอัตราการผ่านการทดสอบ
- สำหรับงานวิจัย ให้วัดความถูกต้องของข้อเท็จจริงและดูว่าการอ้างอิงสนับสนุนข้อกล่าวอ้างหรือไม่
- สำหรับเวิร์กโฟลว์เอเจนต์ ให้วัดการเสร็จสมบูรณ์แบบครบวงจรและการกู้คืนจากข้อผิดพลาด
- สำหรับการเขียนเชิงธุรกิจ ให้ประเมินความถูกต้อง การปฏิบัติตามคำสั่ง และเวลาที่ใช้ในการแก้ไข
เกณฑ์มาตรฐานเป็นเพียงจุดเริ่มต้น ภารกิจของคุณเองคือการทดสอบขั้นสุดท้าย
ผู้ใช้ Reddit พูดอย่างไรเกี่ยวกับโมเดลเหล่านี้?
Reddit ให้มุมมองที่แตกต่างจากประกาศอย่างเป็นทางการ ผู้ใช้จะหารือเกี่ยวกับประสิทธิภาพของโมเดลที่สังเกตเห็นระหว่างการทำงานในชีวิตประจำวัน รวมถึงคุณภาพโค้ด ความคิดสร้างสรรค์ ความเร็ว ขีดจำกัดการใช้งาน และจำนวนคำแนะนำที่โมเดลต้องการ
การอภิปรายเหล่านี้เป็นหลักฐานที่มีประโยชน์เกี่ยวกับความสำคัญสำหรับผู้ใช้ แต่มักเป็นประสบการณ์ส่วนบุคคล โพสต์ใดโพสต์หนึ่งไม่ได้พิสูจน์ว่าโมเดลหนึ่งจะดีกว่าสำหรับผู้ใช้ทุกคนอย่างเป็นรูปธรรม
Gemini 4 Argon: คะแนนน่าประทับใจ แต่การเข้าถึงยังคงน่ากังวล
ในการอภิปรายใน r/singularity เกี่ยวกับเกณฑ์มาตรฐานของ Gemini 4 Argon ผู้ใช้ได้พูดคุยเกี่ยวกับผลลัพธ์ที่มีการรายงานของ Google ครอบคลุมการเขียนโค้ด ความปลอดภัยทางไซเบอร์ และงานระดับมืออาชีพ
คำถามที่เกิดขึ้นซ้ำๆ คือ ประสิทธิภาพของโมเดลจะแปลงเป็นประโยชน์ในทางปฏิบัติได้จริงหรือไม่ และการเข้าถึงที่กว้างขึ้นจะมีขึ้นเมื่อใด
สิ่งนี้สร้างข้อแตกต่างที่มีประโยชน์สำหรับบทความเปรียบเทียบ: การเป็นผู้นำด้านเกณฑ์มาตรฐานไม่ใช่สิ่งเดียวกับประโยชน์ในการใช้งานประจำวัน ผู้ใช้ต้องการวิธีทดสอบโมเดลกับงานของตนเองก่อนที่จะตัดสินใจว่าจะคุ้มค่าที่จะนำมาใช้หรือไม่
GPT-6 Astra vs Claude Opus 5.5: คุณภาพ ความเร็ว และขีดจำกัดการใช้งาน
การอภิปรายใน r/ClaudeAI ที่เปรียบเทียบ Opus 5.5 กับ GPT-6 Astra แสดงให้เห็นว่าความชอบของชุมชนสามารถเปลี่ยนแปลงได้รวดเร็วเพียงใดระหว่างการเปิดตัวโมเดลแต่ละรุ่น
ผู้เข้าร่วมได้อธิบายประสบการณ์ที่แตกต่างกันกับโมเดล บางคนชอบ Astra ในขณะที่บางคนชื่นชมความสามารถของ Opus 5.5 แต่วิพากษ์วิจารณ์ปริมาณคำแนะนำที่บางครั้งจำเป็นต้องจัดหาให้
บทเรียนในวงกว้างคือ คุณภาพของโมเดลขึ้นอยู่กับภารกิจและเวิร์กโฟลว์ของผู้ใช้ด้วยส่วนหนึ่ง โมเดลที่ทำงานได้ดีสำหรับนักพัฒนาคนหนึ่งอาจเหมาะสมน้อยกว่าสำหรับข้อกำหนดของอีกโครงการหนึ่ง
ขีดจำกัดการใช้งานเป็นอีกข้อกังวลหนึ่ง ในการอภิปรายบน Reddit เกี่ยวกับการเลือกระหว่าง Opus 5.5 และ Astra ผู้ใช้รายหนึ่งได้ตั้งคำถามเกี่ยวกับการใช้งานจนหมดโควตา และดูว่าการเปลี่ยนแพ็กเกจสมัครสมาชิกจะให้คุ้มค่ากว่าหรือไม่
สำหรับผู้ใช้งานประจำ ค่าใช้จ่ายในการทำงานอย่างต่อเนื่องอาจมีความสำคัญพอๆ กับคุณภาพของคำตอบแต่ละคำตอบ
ภารกิจสร้างสรรค์ง่ายๆ สามารถให้ผลลัพธ์ที่แตกต่างกันได้
ในการเปรียบเทียบบน Reddit ของ Opus 5.5, GPT-6 Astra และโมเดลอื่นๆ ผู้ใช้ได้พูดคุยเกี่ยวกับการให้คำสั่งเดียวกันแก่โมเดลหลายตัว เพื่อสร้างอนิเมชันเครื่องบินกระดาษสั้นๆ
คำตอบสะท้อนถึงความชอบที่แตกต่างกัน: ผู้ใช้บางคนชอบคุณภาพของอนิเมชัน ในขณะที่คนอื่นๆ ชอบการตีความหรือทิศทางสร้างสรรค์ของอีกโมเดลหนึ่ง
นี่เป็นสิ่งเตือนใจที่มีประโยชน์ว่าการเปรียบเทียบโมเดลไม่ได้จำกัดอยู่แค่การเขียนโค้ดและการใช้เหตุผล สำหรับงานสร้างสรรค์ คุณภาพของผลลัพธ์อาจขึ้นอยู่กับมุมมองส่วนบุคคล และโมเดลที่เหมาะสมที่สุดจะขึ้นอยู่กับผลลัพธ์ที่ผู้ใช้ต้องการ
เราสามารถเรียนรู้อะไรจากการอภิปรายเหล่านี้?
จากกระทู้เหล่านี้ มี 4 ประเด็นหลักที่โดดเด่น:
- ประสิทธิภาพในโลกจริงมีความสำคัญมากกว่าคะแนนหัวข้อข่าว ผู้ใช้ต้องการโมเดลที่แก้ปัญหาเฉพาะของตนเองได้
- การปฏิบัติตามคำสั่งส่งผลต่อผลิตภาพ โมเดลที่แข็งแกร่งจะมีประโยชน์มากกว่าเมื่อเข้าใจข้อจำกัดโดยไม่ต้องอธิบายซ้ำซ้อน
- ขีดจำกัดการใช้งานส่งผลต่อประสบการณ์โดยรวม ผลลัพธ์คุณภาพสูงจะมีค่าน้อยลงหากผู้ใช้ไม่สามารถรักษาเวิร์กโฟลว์ของตนให้ต่อเนื่องได้
- งานที่แตกต่างกันให้ผลตอบแทนกับจุดแข็งที่แตกต่างกัน ผลลัพธ์เชิงสร้างสรรค์ การเขียนโค้ด งานวิจัย และระบบอัตโนมัติ ไม่ควรได้รับการประเมินด้วยเกณฑ์เดียวกัน
ข้อสังเกตเหล่านี้ควรนำมาประกอบการทดสอบในบทความนี้ มากกว่าที่จะนำมาทดแทนการทดสอบ
วิธีเปรียบเทียบทั้งสามโมเดลในงานโลกแห่งความเป็นจริง
การเปรียบเทียบที่มีประโยชน์ที่สุดคือการมอบหมายภารกิจเดียวกัน วัสดุขาเข้าเดียวกัน และเกณฑ์การประเมินเดียวกันให้แก่ทั้งสามโมเดล
หากคุณสามารถเข้าถึงโมเดลทั้งสามตัวได้ การทดสอบต่อไปนี้สามารถช่วยระบุได้ว่าโมเดลใดเหมาะสมกับเวิร์กโฟลว์ของคุณ
การทดสอบที่ 1: การเขียนโค้ดและการแก้ไขบั๊ก
มอบโค้ดเบสขนาดเล็กเดียวกันที่มีบั๊กที่สามารถสร้างซ้ำได้ให้แก่แต่ละโมเดล ขอให้โมเดลระบุปัญหา ดำเนินการแก้ไข เขียนการทดสอบ และอธิบายการเปลี่ยนแปลง
เกณฑ์การวัด:
- บั๊กดั้งเดิมได้รับการแก้ไขหรือไม่
- การทดสอบที่มีอยู่เดิมยังคงผ่านหรือไม่
- มีการสร้างบั๊กใหม่ขึ้นมาหรือไม่
- ต้องใช้คำสั่งติดตามผลกี่ครั้ง
- เวลาและปริมาณโทเค็นที่ใช้ทั้งหมด
โมเดลที่สร้างคำอธิบายที่ดูสมเหตุสมผลแต่สอบตกการทดสอบ ไม่ควรได้รับการพิจารณาว่าเป็นผู้ชนะ
การทดสอบที่ 2: งานวิจัยและการวิเคราะห์เอกสาร
จัดหาชุดรายงาน ตาราง และเอกสารต้นทางชุดเดียวกัน ขอให้แต่ละโมเดลสรุปหลักฐาน ดึงตัวเลขที่สำคัญ ระบุข้อขัดแย้ง และจัดทำรายงานสั้นๆ พร้อมเอกสารอ้างอิง
วัดความถูกต้องของข้อเท็จจริง คุณภาพการอ้างอิง ความครอบคลุมของข้อมูลสำคัญ และปริมาณการแก้ไขด้วยตนเองที่จำเป็น
การทดสอบนี้มีประโยชน์อย่างยิ่งสำหรับนักวิเคราะห์ นักเรียน ที่ปรึกษา และทีมสร้างคอนเทนต์
การทดสอบที่ 3: การดำเนินโครงการหลายขั้นตอน
มอบหมายภารกิจที่ต้องการผลลัพธ์หลายอย่างให้แก่แต่ละโมเดล เช่น การวิเคราะห์ไอเดียผลิตภัณฑ์ การพัฒนาแผนงานโครงการ การสร้างตารางภารกิจ และการจัดทำรายงานขั้นสุดท้าย
ประเมินว่าโมเดลปฏิบัติตามลำดับขั้นตอนที่ต้องการ รักษาความสม่ำเสมอระหว่างผลลัพธ์ และตรวจสอบผลลัพธ์สุดท้ายหรือไม่
หากสภาพแวดล้อมมีเครื่องมือให้ ให้บันทึกว่าโมเดลใช้เครื่องมือเหล่านั้นอย่างถูกต้องหรือไม่ แยกสติปัญญาของโมเดลออกจากความสามารถของแพลตฟอร์มที่รันโมเดลนั้น
การทดสอบที่ 4: การเขียนและการปฏิบัติตามคำสั่ง
จัดหาบรีฟการเขียนโดยละเอียดพร้อมระบุกลุ่มเป้าหมาย น้ำเสียง ประเด็นที่ต้องการ ความยาว และข้อจำกัด
เปรียบเทียบผลลัพธ์ในด้านความถูกต้องของข้อเท็จจริง ความอ่านง่าย โครงสร้าง ความเป็นออริจินัล และการปฏิบัติตามบรีฟ
สำหรับทีมการตลาด สิ่งนี้สามารถเปิดเผยได้ว่าโมเดลใดสร้างร่างแรกที่นำไปใช้งานได้จริง และโมเดลใดต้องการการแก้ไขเพิ่มเติมมากกว่า
ใช้กรอบการให้คะแนนที่สม่ำเสมอ
การประเมินแบบ 100 คะแนนง่ายๆ สามารถทำให้เปรียบเทียบผลลัพธ์ได้ง่ายขึ้น
| เกณฑ์การประเมิน | น้ำหนักที่แนะนำ |
|---|---|
| ความถูกต้องและแม่นยำ | 30 |
| การเสร็จสมบูรณ์ของภารกิจ | 25 |
| การปฏิบัติตามคำสั่ง | 15 |
| คุณภาพของผลลัพธ์ | 15 |
| ความเร็วและประสิทธิภาพ | 10 |
| ต้นทุน | 5 |
| รวม | 100 |
น้ำหนักควรปรับเปลี่ยนตามลักษณะภารกิจ ตัวอย่างเช่น การทดสอบการเขียนโค้ดควรเน้นที่โค้ดที่ใช้งานได้และการผ่านการทดสอบ ในขณะที่การทดสอบงานวิจัยควรให้ความสำคัญกับความถูกต้องของข้อเท็จจริงและคุณภาพของแหล่งที่มา
อย่าเผยแพร่คะแนนการทดสอบอิสระเว้นแต่คุณจะได้ลงมือทำการทดลองจริง หากการเข้าถึง Argon ยังคงถูกจำกัด ให้ใช้การเปรียบเทียบผลลัพธ์ที่เผยแพร่ซึ่งระบุป้ายกำกับไว้อย่างชัดเจน และเว้นส่วนการทดสอบอิสระไว้สำหรับโมเดลที่คุณสามารถประเมินได้จริง
การเปรียบเทียบราคา: โมเดลใดให้ความคุ้มค่ามากกว่ากัน?
อัตรา API มาตรฐานที่เผยแพร่สำหรับโมเดลเหล่านี้ให้จุดเริ่มต้นที่มีประโยชน์
| โมเดล | ขาเข้าต่อ 1 ล้านโทเค็น | ขาออกต่อ 1 ล้านโทเค็น |
|---|---|---|
| Gemini 4 Argon | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
แหล่งที่มา: Google, OpenAI และ Anthropic
จากอัตรามาตรฐานที่ประกาศไว้เหล่านี้ Argon มีราคาโทเค็นที่ถูกที่สุด รองลงมาคือ Opus 5.5 และ Astra อย่างไรก็ตาม สิ่งนี้ไม่ได้ทำให้ Argon เป็นตัวเลือกในทางปฏิบัติที่ถูกที่สุดสำหรับผู้ใช้ทุกคนโดยอัตโนมัติ โดยเฉพาะในขณะที่การเข้าถึงยังคงถูกจำกัด
ตัวอย่าง: ภารกิจที่ใช้โทเค็นขาเข้า 100,000 โทเค็น และโทเค็นขาออก 20,000 โทเค็น
สมมติว่าใช้อัตราที่ประกาศไว้ โดยไม่มีส่วนลด Caching ค่าธรรมเนียมเครื่องมือ หรือค่าบริการอื่นๆ:
- Gemini 4 Argon: ขาเข้า $0.20 + ขาออก $0.20 = $0.40
- GPT-6 Astra: ขาเข้า $1.00 + ขาออก $1.00 = $2.00
- Claude Opus 5.5: ขาเข้า $0.40 + ขาออก $0.40 = $0.80
นี่เป็นเพียงตัวอย่างต้นทุนโทเค็น ไม่ใช่การอ้างว่าโมเดลเหล่านี้ใช้จำนวนโทเค็นเท่ากันในการทำภารกิจเดียวกันให้เสร็จ
สำหรับการเปรียบเทียบที่เป็นธรรมยิ่งขึ้น ให้คำนวณต้นทุนในการสร้างผลลัพธ์ที่สำเร็จหนึ่งครั้ง หากโมเดลหนึ่งต้องลองใหม่ 5 ครั้ง และอีกโมเดลหนึ่งทำภารกิจเสร็จภายในครั้งเดียว ต้นทุนจริงของโมเดลอาจแตกต่างจากอัตราส่วนราคาโทเค็นมาตรฐานอย่างมีนัยสำคัญ
แผนการสมัครสมาชิกยังมีราคา ขีดจำกัด และกฎการใช้งานของตนเอง อย่าเปรียบเทียบราคา API โดยตรงกับค่าธรรมเนียมการสมัครสมาชิกเสมือนว่าเทียบเท่ากัน
โมเดล AI ใดดีที่สุดสำหรับความต้องการของคุณ?
โมเดลที่เหมาะสมขึ้นอยู่กับสิ่งที่คุณทำ ความถี่ในการใช้ AI และลักษณะของผลลัพธ์ที่ประสบความสำเร็จ
สำหรับนักพัฒนาซอฟต์แวร์
พิจารณาทดสอบ GPT-6 Astra และ Claude Opus 5.5 กับโค้ดเบสจริงของคุณ ทั้งสองตัวถูกวางตำแหน่งสำหรับงานวิศวกรรมที่ท้าทาย แต่ประสิทธิภาพสัมพัทธ์จะขึ้นอยู่กับภาษา เครื่องมือ และความซับซ้อนของโครงการของคุณ
Gemini 4 Argon ก็เป็นตัวที่น่าจับตามองสำหรับผลลัพธ์วิศวกรรมซอฟต์แวร์ที่มีการรายงาน ขึ้นอยู่กับการเข้าถึงและการตรวจสอบที่เป็นอิสระ
สำหรับนักวิจัยและนักวิเคราะห์
ให้ความสำคัญกับการดึงข้อมูลที่ถูกต้อง การอ้างอิงที่เชื่อถือได้ การจัดการเอกสารยาว และความสามารถในการแยกแยะข้อเท็จจริงออกจากข้อสันนิษฐาน
สำหรับงานที่เกี่ยวข้องกับชุดไฟล์ขนาดใหญ่ ให้ทดสอบว่าโมเดลสามารถค้นหาลายละเอียดที่เกี่ยวข้องโดยไม่ละเลยหลักฐานที่ขัดแย้งกันได้หรือไม่
สำหรับผู้สร้างคอนเทนต์และนักการตลาด
เปรียบเทียบว่าแต่ละโมเดลปฏิบัติตามบรีฟคอนเทนต์ รักษาน้ำเสียงที่สม่ำเสมอ จัดระเบียบข้อมูล และสร้างร่างที่ต้องแก้ไขน้อยที่สุดได้ดีเพียงใด
เวิร์กโฟลว์ในทางปฏิบัติอาจรวมถึงการวิจัยคีย์เวิร์ด การทำโครงร่าง การยกร่าง การตรวจสอบข้อเท็จจริง และการปรับแต่งคอนเทนต์สำหรับกลุ่มเป้าหมายที่แตกต่างกัน การตรวจสอบโดยมนุษย์ยังคงมีความสำคัญ โดยเฉพาะสำหรับข้อกล่าวอ้างข้อเท็จจริงและคอนเทนต์ SEO
สำหรับผู้ใช้ระดับธุรกิจ
มุ่งเน้นไปที่การทำภารกิจให้สำเร็จ การวิเคราะห์เอกสาร เวิร์กโฟลว์สเปรดชีต การทำรายงาน และความน่าเชื่อถือของผลลัพธ์
สำหรับงานที่ทำซ้ำๆ แม้การลดเวลาการตรวจสอบด้วยตนเองลงเพียงเล็กน้อย ก็อาจมีความสำคัญมากกว่าคะแนนเกณฑ์มาตรฐานที่เพิ่มขึ้นเล็กน้อย
สำหรับผู้ใช้ที่ใส่ใจเรื่องงบประมาณ
เปรียบเทียบต้นทุนจริงในการทำภารกิจทั่วไปของคุณให้เสร็จ มากกว่าที่จะเลือกโมเดลตามโฆษณาสติปัญญาเพียงอย่างเดียว
หากโมเดลที่มีราคาถูกกว่าสามารถตอบสนองความต้องการของคุณได้อย่างสม่ำเสมอ โมเดลนั้นอาจเป็นตัวเลือกประจำวันที่ดีกว่า สงวนโมเดลที่แพงกว่าไว้สำหรับงานที่ความสามารถเพิ่มเติมของพวกมันสร้างความแตกต่างที่วัดผลได้
วิธีสำรวจโมเดล AI และทำภารกิจให้เสร็จสิ้นบน ChatGOAT AI
การเปรียบเทียบโมเดลเป็นสิ่งที่มีประโยชน์ แต่ประโยชน์ที่แท้จริงของ AI มาจากการนำไปปรับใช้กับการทำงานของคุณเอง
ChatGOAT AI มอบพื้นที่ทำงาน AI สำหรับโมเดลและเครื่องมือที่รองรับ ช่วยให้ผู้ใช้สำรวจการเขียน การวิจัย การวิเคราะห์ และเวิร์กโฟลว์สร้างสรรค์ที่ช่วยเหลือด้วย AI โดยไม่ต้องมองว่าทุกภารกิจคือการทดลองที่แยกจากกัน
ในจุดที่ Gemini 4 Argon, GPT-6 Astra และ Claude Opus 5.5 เปิดใช้งานในตัวเลือกโมเดลปัจจุบันของ ChatGOAT ผู้ใช้สามารถสำรวจคำตอบของโมเดลเหล่านั้นภายในแพลตฟอร์ม และประเมินว่าแนวทางใดทำงานได้ดีที่สุดสำหรับความต้องการของตน ความพร้อมใช้งานอาจแตกต่างกันไปตามโมเดลและการเชื่อมต่อ ดังนั้นให้ตรวจสอบรายการโมเดลสดก่อนเริ่มต้น
คุณสามารถทำอะไรกับ AI บน ChatGOAT AI ได้บ้าง?
ใช้ AI เพื่อระดมความคิดสำหรับไอเดียบทความ สร้างโครงร่าง ยกร่างโพสต์บล็อก เรียบเรียงย่อหน้าใหม่ สรุปเนื้อหาที่ยาว หรือปรับแต่งคอนเทนต์สำหรับกลุ่มเป้าหมายต่างๆ
ตัวอย่างเช่น ผู้เชี่ยวชาญด้าน SEO สามารถพัฒนาโครงร่างบล็อก ยกร่างบทความเปรียบเทียบ จัดเตรียมคำตอบสำหรับ FAQ และปรับปรุงเนื้อหาเพื่อความชัดเจนและเจตนาการค้นหา
วิเคราะห์ข้อมูลและเอกสาร
AI สามารถช่วยดึงประเด็นสำคัญจากเอกสารที่จัดหาให้ เปรียบเทียบรายงาน จัดระเบียบผลการวิจัย และเปลี่ยนบันทึกที่ไม่มีโครงสร้างให้เป็นสรุปที่ชัดเจนยิ่งขึ้น
ตัวอย่างเช่น ผู้ใช้ในสายธุรกิจสามารถเปลี่ยนบันทึกการประชุมให้เป็นแผนการดำเนินงาน สร้างตารางเปรียบเทียบ และจัดเตรียมสรุปสำหรับผู้บริหารแบบกระชับ
สร้างตารางที่มีโครงสร้างและแผนงานโครงการ
ใช้ AI จัดระเบียบการเปรียบเทียบผลิตภัณฑ์ จัดเตรียมรายการภารกิจ สร้างเมทริกซ์การวิจัย และสร้างแผนงานโครงการที่มีโครงสร้าง
ทีมการตลาดสามารถใช้เวิร์กโฟลว์นี้เพื่อเปรียบเทียบฟีเจอร์ของคู่แข่ง จับคู่คีย์เวิร์ดกับแลนดิ้งเพจ และจัดระเบียบปฏิทินคอนเทนต์
สนับสนุนการเขียนโค้ดและการแก้ปัญหา
สำหรับเวิร์กโฟลว์การเขียนโค้ดที่รองรับ AI สามารถอธิบายโค้ดที่ไม่คุ้นเคย เสนอขั้นตอนการแก้ไขบั๊ก ยกร่างฟังก์ชัน และช่วยจัดระเบียบเอกสารทางเทคนิค
ทดสอบโค้ดที่สร้างขึ้นและตรวจสอบการเปลี่ยนแปลงเสมอก่อนนำไปใช้ในสภาพแวดล้อมจริง
ChatGOAT AI ยังมอบความสามารถในการสร้างรูปภาพด้วย AI ผ่านเครื่องมือรูปภาพและโมเดลที่รองรับ สิ่งเหล่านี้สามารถช่วยให้ผู้ใช้สร้างภาพประกอบ แนวคิดภาพ กราฟิกโซเชียลมีเดีย และทรัพย์สินทางปัญญาเชิงสร้างสรรค์อื่นๆ
การสร้างรูปภาพเป็นความสามารถที่แยกจากการใช้เหตุผลของโมเดลข้อความ อย่าสมมติว่าทุกโมเดลในการเปรียบเทียบนี้สามารถสร้างรูปภาพได้โดยตรงเพียงเพราะพื้นที่ทำงานมีเครื่องมือรูปภาพ
สร้างเวิร์กโฟลว์ที่มีประสิทธิภาพยิ่งขึ้น
แทนที่จะมองทุกภารกิจเป็นคำสั่งที่แยกจากกัน ผู้ใช้สามารถย่อยโครงการออกเป็นขั้นตอนต่างๆ: การวิจัย การวางแผน การยกร่าง การตรวจสอบ และการส่งมอบขั้นสุดท้าย
เวิร์กโฟลว์ที่มีประโยชน์ที่สุดคือเวิร์กโฟลว์ที่ให้ผลลัพธ์ที่ถูกต้องโดยมีการทำงานซ้ำซ้อนน้อยลง ไม่จำเป็นต้องเป็นเวิร์กโฟลว์ที่ใช้โมเดลขั้นสูงที่สุดสำหรับทุกขั้นตอน
สำรวจ ChatGOAT AI เพื่อดูโมเดลและเครื่องมือ AI ที่รองรับในปัจจุบันซึ่งมีให้สำหรับเวิร์กโฟลว์ของคุณ
FAQ (คำถามที่พบบ่อย)
Gemini 4 Argon ดีกว่า GPT-6 Astra หรือไม่?
ไม่เสมอไปในทุกสถานการณ์ Google ได้รายงานผลลัพธ์ที่แข็งแกร่งสำหรับ Argon ในการทดสอบเกณฑ์มาตรฐานวิศวกรรมและงานระดับมืออาชีพที่ได้รับเลือก ในขณะที่ OpenAI เผยแพร่ผลลัพธ์ที่แข็งแกร่งสำหรับ Astra ในการประเมินที่ท้าทายหลายรายการ ข้อจำกัดในการเข้าถึงและความแตกต่างในวิธีการทดสอบทำให้การจัดอันดับแบบครอบจักรวาลยังคงเร็วเกินไป
Claude Opus 5.5 ดีกว่า GPT-6 Astra ในการเขียนโค้ดหรือไม่?
ทั้งคู่ได้รับการออกแบบมาสำหรับงานวิศวกรรมซอฟต์แวร์ที่ท้าทาย ตัวเลือกที่ดีกว่าขึ้นอยู่กับโค้ดเบส ภาษาโปรแกรม เครื่องมือที่มีอยู่ และคุณภาพของการใช้งานจริงขั้นสุดท้าย ให้เปรียบเทียบอัตราการผ่านการทดสอบ ความเสี่ยงของข้อผิดพลาดใหม่ จำนวนรอบการทำงาน และต้นทุนรวมในภารกิจเดียวกัน
โมเดลใดดีที่สุดสำหรับการใช้เหตุผลที่ซับซ้อน?
GPT-6 Astra และ Gemini 4 Argon ถูกวางตำแหน่งสำหรับการใช้เหตุผลที่ซับซ้อนและการทำงานหลายขั้นตอน ในขณะที่ Claude Opus 5.5 ออกแบบมาสำหรับเวิร์กโฟลว์ระดับมืออาชีพและเอเจนต์ที่ท้าทาย ใช้การทดสอบเฉพาะภารกิจเพื่อระบุว่าโมเดลใดทำงานได้ดีที่สุดสำหรับความต้องการของคุณ
โมเดลใดถูกที่สุด?
ตามอัตรา API มาตรฐานที่ระบุไว้ข้างต้น Gemini 4 Argon มีราคาโทเค็นต่ำที่สุด รองลงมาคือ Claude Opus 5.5 และ GPT-6 Astra อย่างไรก็ตาม การเข้าถึงที่จำกัดของ Argon ส่งผลต่อการที่ผู้ใช้ส่วนใหญ่จะสามารถใช้ราคานั้นได้จริงหรือไม่ ต้นทุนภารกิจทั้งหมดขึ้นอยู่กับการใช้โทเค็น การลองใหม่ การทำ Caching และเครื่องมือที่ใช้ด้วย
ฉันสามารถใช้ Gemini 4 Argon ได้ในตอนนี้หรือไม่?
ในตอนแรก Google ประกาศเปิดตัว Argon สำหรับผู้ปกป้องความปลอดภัยทางไซเบอร์ที่ได้รับความไว้วางใจผ่านโครงการ Fairwind Program โดยมีแผนจะขยายการเข้าถึงให้กว้างขึ้น โปรดตรวจสอบประกาศอย่างเป็นทางการล่าสุดของ Google สำหรับการเปลี่ยนแปลงความพร้อมใช้งานก่อนที่จะพึ่งพาโมเดลนี้สำหรับโครงการ
ฉันสามารถเปรียบเทียบโมเดลเหล่านี้บน ChatGOAT AI ได้หรือไม่?
คุณสามารถสำรวจโมเดลและเครื่องมือที่รองรับโดยพื้นที่ทำงานปัจจุบันของ ChatGOAT AI ได้ หากต้องการเปรียบเทียบทั้งสามตัวโดยตรง ให้ตรวจสอบว่า Gemini 4 Argon, GPT-6 Astra และ Claude Opus 5.5 มีให้เลือกในตัวเลือกโมเดลปัจจุบัน หากมีโมเดลใดไม่พร้อมใช้งาน ให้เปรียบเทียบเอกสารที่เผยแพร่ของโมเดลนั้นกับผลลัพธ์จากการใช้งานจริงของโมเดลที่เข้าถึงได้แทน
โมเดลใดดีที่สุดสำหรับงานประจำวัน?
ไม่มีคำตอบแบบครอบจักรวาล ให้พิจารณาภารกิจที่คุณทำบ่อยที่สุด ความแม่นยำของผลลัพธ์ที่ต้องการ ปริมาณการแก้ไขที่จำเป็น งบประมาณของคุณ และขีดจำกัดการใช้งานของแพลตฟอร์มที่คุณต้องการ การทดสอบภารกิจที่เป็นตัวแทนสักสองสามงานจะมีประโยชน์มากกว่าการเลือกโดยอิงจากชื่อเสียงเพียงอย่างเดียว
ข้อสรุปสุดท้าย: เลือกโมเดลที่ทำงานของคุณได้ดีที่สุด
Gemini 4 Argon, GPT-6 Astra และ Claude Opus 5.5 เป็นตัวแทนของแนวทางที่แตกต่างกันในการช่วยเหลือด้วย AI ขั้นสูง Argon มีจุดแข็งที่มีการรายงานในการประเมินวิศวกรรมและงานระดับมืออาชีพที่ได้รับเลือก Astra มุ่งเป้าไปที่การใช้เหตุผลที่ท้าทายและการควบคุมคอมพิวเตอร์ ส่วน Opus 5.5 มุ่งเน้นไปที่เอเจนต์เขียนโค้ดและเวิร์กโฟลว์ระดับมืออาชีพที่ทำงานระยะยาว
โมเดลที่ดีที่สุดไม่จำเป็นต้องเป็นโมเดลที่มีคะแนนสูงสุดหรือมี API ที่แพงที่สุด แต่เป็นโมเดลที่ทำภารกิจของคุณสำเร็จได้อย่างน่าเชื่อถือ ปปฏิบัติตามคำสั่งของคุณ เหมาะสมกับงบประมาณของคุณ และต้องการการแทรกแซงที่ไม่จำเป็นน้อยที่สุด
ใช้เกณฑ์มาตรฐานอย่างเป็นทางการเพื่อบีบตัวเลือกของคุณให้แคบลง ใช้การอภิปรายบน Reddit เพื่อเข้าใจคำถามที่ผู้ใช้จริงกำลังถาม และใช้การทดสอบภาคปฏิบัติที่สม่ำเสมอเพื่อตัดสินใจขั้นสุดท้าย
ด้วย ChatGOAT AI คุณสามารถสำรวจโมเดลและเครื่องมือ AI ที่รองรับสำหรับการเขียน การวิจัย การวิเคราะห์ และงานสร้างสรรค์ในพื้นที่ทำงานเดียว เริ่มต้นด้วยภารกิจที่คุณต้องทำจริง เปรียบเทียบคุณภาพของผลลัพธ์ และเลือกเวิร์กโฟลว์ที่ทำให้งานของคุณง่ายขึ้น