Konkurrensen mellan Gemini 4 Argon, GPT-6 Astra och Claude Opus 5.5 belyser en viktig fr¦ndring inom artificiell intelligens. Dagens ledande modeller bedms inte l¦ngre bara utifr¥n hur v¦l de svarar p¥ fr¥gor. Utvecklare, forskare och vanliga anv¦ndare vill ocks¥ ha AI som kan lsa komplexa problem, frst¥ stora projekt, skriva p¥litlig kod, analysera dokument och slutfra flerstegsuppgifter med mindre vervakning.
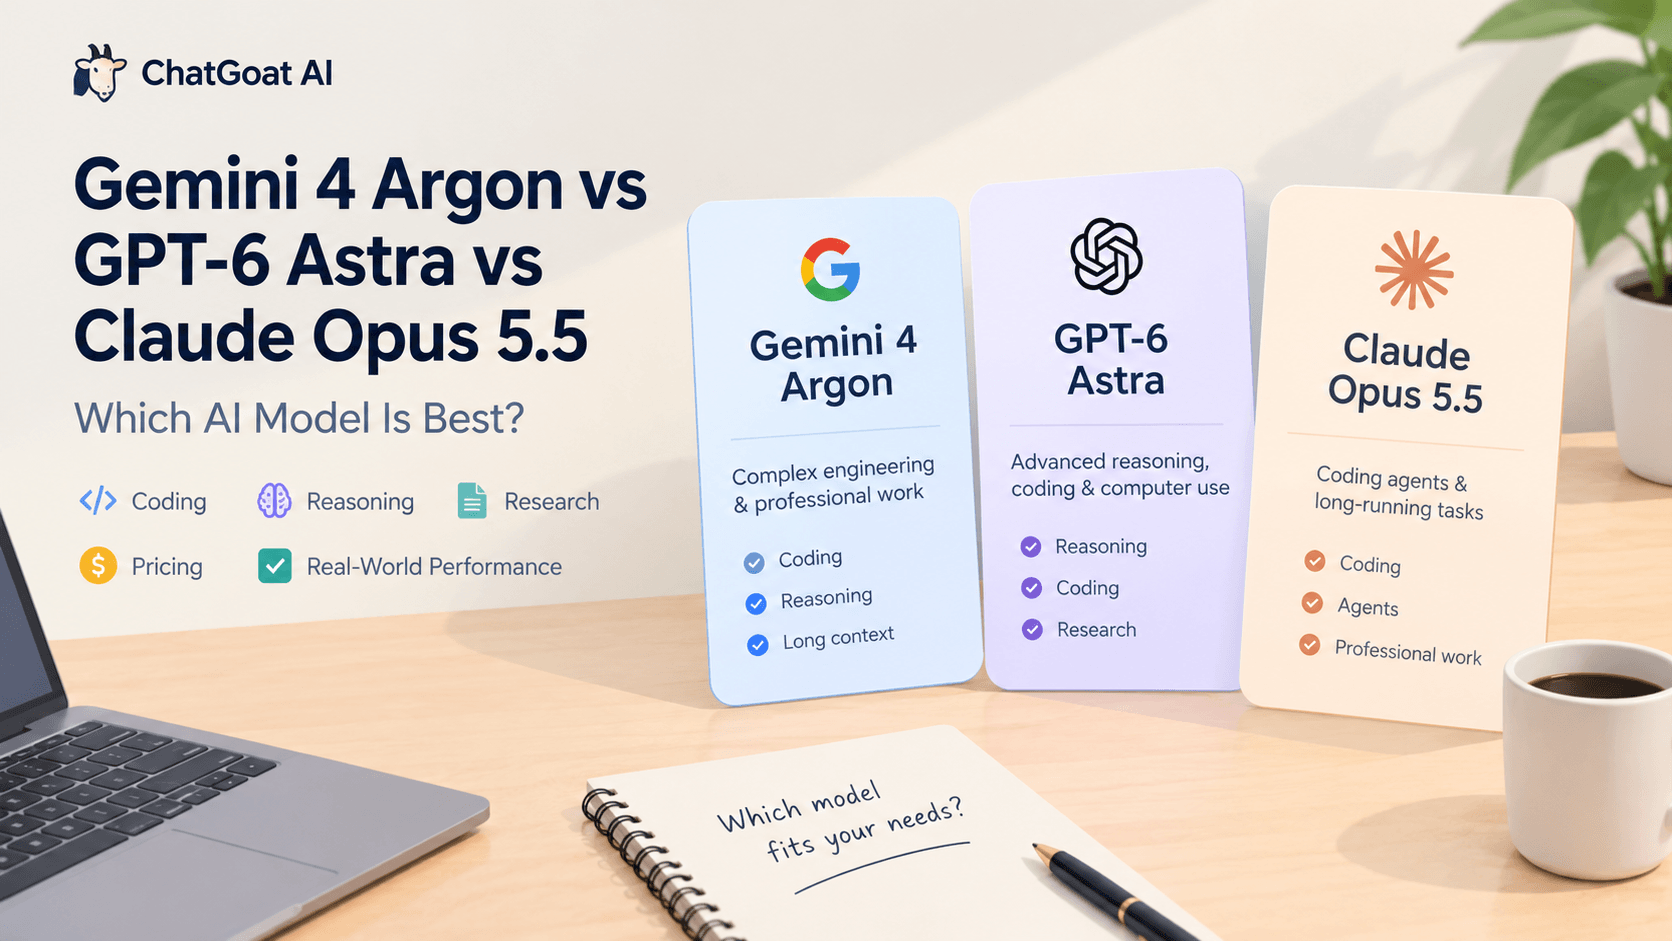
Varje modell har sin egen upps¦ttning styrkor. Google positionerar Gemini 4 Argon kring komplex teknisk utveckling, professionellt kunskapsarbete och cybers¦kerhetsfrsvar. OpenAI presenterar GPT-6 Astra som en modell fr kr¦vande resonemang, kodning, forskning och datoranv¦ndningsuppgifter. Anthropic betonar Claude Opus 5.5:s frm¥gor inom mjukvaruutveckling, l¥ngkrande agenter och professionellt arbete.
Men vilken modell ska du v¦lja? ᅣr Gemini 4 Argon faktiskt b¦ttre p¥ kodning? Motiverar GPT-6 Astra sitt hgre API-pris? Kan Claude Opus 5.5 slutfra komplicerade projekt med f¦rre instruktioner?
Denna j¦mfrelse granskar officiella benchmark-resultat, priss¦ttning, tillg¦nglighet, praktiska anv¦ndningsomr¥den och diskussioner fr¥n Reddit. Den frklarar ocks¥ hur du utv¦rderar dessa modeller fr verkligt arbete och utforskar AI-drivna arbetsflden via ChatGOAT AI.
Snabbdom: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
Det finns ingen enskild vinnare fr varje uppgift. Det b¦sta valet beror p¥ det arbete du behver utfra, din budget och om du kan komma ¥t modellen via din fredragna plattform.
| J¦mfrelse | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Prim¦r positionering | Komplex teknisk utveckling och professionella arbetsflden | Avancerat resonemang, kodning, forskning och datoranv¦ndning | Kodningsagenter och l¥ngkrande professionella uppgifter |
| Kodning | Starka resultat p¥ utvalda benchmarks fr mjukvaruutveckling | Stark inom resonemangsintensiv kodning och tekniska uppgifter | Utformad fr komplex kodning och agentarbetsflden |
| Resonemang | Utformad fr komplex, flerstegs problemlsning | Byggd fr kr¦vande resonemang och professionellt arbete | Stark p¥ komplexa instruktioner och l¥ngvarigt arbete |
| Arbete med l¥ng kontext | Upp till 1 miljon utdata-tokens meddelat | Kontextfnster p¥ 1,05 miljoner tokens | L¥ngkrande agentarbetsflden och stora projekt |
| Standardpris fr API-indata | $2 per miljon tokens | $10 per miljon tokens | $4 per miljon tokens |
| Standardpris fr API-utdata | $10 per miljon tokens | $50 per miljon tokens | $20 per miljon tokens |
| Tillg¦nglighet | Inledningsvis begr¦nsad till betrodda cybers¦kerhetsfrsvarare | Tillg¦nglig via OpenAI:s produkter som stds samt API | Tillg¦nglig via Claude- och utvecklarplattformar som stds |
K¦llor: Googles tillk¦nnagivande av Gemini 4 Argon, OpenAI:s modelldokumentation fr GPT-6 Astra och Anthropics Claude Opus-dokumentation.
Dessa modeller br inte rankas enbart utifr¥n pris eller ett enskilt benchmark. En modell som kostar mindre per token kan behva fler frsk fr att slutfra en uppgift, medan en modell med ett imponerande benchmark-resultat kanske inte ¦r tillg¦nglig fr den genomsnittliga anv¦ndaren.
Den praktiska slutsatsen: J¦mfr kvaliteten p¥ det slutliga resultatet, tiden som kr¦vs, antalet korrigeringar och den faktiska kostnaden fr att slutfra din uppgift.
Gemini 4 Argon: Byggd fr komplex teknisk utveckling och kunskapsarbete
Google tillk¦nnagav Gemini 4 Argon den 30 september 2026 och positionerade den som en spetsmodell fr verklig mjukvaruutveckling, kunskapsarbete inom fretag och cybers¦kerhetsfrsvar.
Till skillnad fr¥n en modell som fr¦mst ¦r utformad fr vardagliga konversationer presenteras Argon som ett system som kan hantera l¥nga, sammankopplade uppgifter. Dessa kan innefatta att granska omfattande teknisk information, identifiera problem, planera en sekvens av ¥tg¦rder och ta fram ett slutgiltigt resultat.
Viktiga styrkor
Komplex mjukvaruutveckling
Argon har visat starka resultat p¥ utvalda benchmarks fr mjukvaruutveckling. Googles tillk¦nnagivande betonar l¥ngsiktiga tekniska uppgifter, d¦r ett AI-system m¥ste beh¥lla kontexten medan det arbetar sig igenom ett komplicerat problem.
Mjliga anv¦ndningsomr¥den inkluderar att granska en stor kodbas, identifiera k¦llan till en bugg, planera en migrering och utv¦rdera om freslagna ¦ndringar lser det ursprungliga problemet.
Professionell forskning och dokumentanalys
Google lyfter ocks¥ fram juridiskt, finansiellt och annat kunskapsarbete fr fretag. Detta gr dokumenttunga uppgifter till ett viktigt omr¥de att utv¦rdera, s¦rskilt n¦r modellen m¥ste koppla samman information fr¥n flera filer.
Exempelvis kan en aff¦rsanalytiker anv¦nda ett AI-arbetsflde fr att sammanfatta rapporter, extrahera finansiella siffror, j¦mfra antaganden och frbereda en strukturerad genomg¥ng fr m¦nsklig granskning.
L¥nga utdata
Google meddelade en maximal utdatagr¦ns p¥ upp till en miljon tokens fr Argon. Detta ¦r en utdatakvot, inte samma sak som ett kontextfnster. Skillnaden ¦r viktig n¦r man j¦mfr modeller eftersom m¦ngden information en modell kan ta emot och m¦ngden den kan generera ¦r olika frm¥gor.
Vilka ¦r begr¦nsningarna?
Den strsta praktiska begr¦nsningen ¦r tillg¥ngen. Vid tillk¦nnagivandet rullade Google ut Argon till betrodda cybers¦kerhetsfrsvarare via sitt Fairwind-program, med bredare tillg¦nglighet planerad till ett senare skede.
Det inneb¦r att de publicerade resultaten inte automatiskt ska betraktas som oberoende reproducerbara av vanliga anv¦ndare.
Ett hgt benchmark-resultat inneb¦r inte heller att Argon kommer att vertr¦ffa andra modeller i varje programmeringsspr¥k, forskningsuppgift eller verkligt projekt.
Fr mer bakgrund, se Googles officiella tillk¦nnagivande av Gemini 4 Argon.
GPT-6 Astra: Avancerat resonemang, kodning och datoranv¦ndning
OpenAI beskriver GPT-6 Astra som sin modell fr kr¦vande professionella uppgifter, inklusive komplexa resonemang, mjukvaruutveckling, forskning, dokumentskapande och datoranv¦ndning.
Dess v¦rde ¦r inte begr¦nsat till att ge ett bra svar i ett enskilt utbyte. Fr l¦mpliga arbetsflden ¦r m¥let att resonera sig igenom ett problem, anv¦nda tillg¦ngliga verktyg och arbeta mot ett tydligt definierat resultat.
Viktiga styrkor
Avancerat resonemang
GPT-6 Astra ¦r avsedd fr problem som kr¦ver mer ¦n att h¦mta ett faktum eller generera ett kort svar. Den kan utv¦rderas p¥ matematiska resonemang, planering, komplexa tekniska fr¥gor och uppgifter med flera begr¦nsningar.
Till exempel kan en produktchef be den j¦mfra konkurrerande produktstrategier, identifiera risker, bygga ett beslutsramverk och ta fram en genomfrandeplan.
Mjukvaruutveckling och felskning
Astra kan hj¦lpa utvecklare att generera kod, inspektera befintliga implementeringar, diagnostisera fel och arbeta sig igenom mer komplicerade tekniska uppgifter.
Anv¦ndbara tester inkluderar att felska ett ok¦nt projekt, ¦ndra flera filer, generera enhetstester och verifiera om den slutliga implementeringen uppfyller kraven.
Datoranv¦ndning och agentarbetsflden
OpenAI dokumenterar ocks¥ frm¥gor relaterade till datoranv¦ndning. Faktisk automatisering beror dock p¥ verktyg, behrigheter och skydds¥tg¦rder som tillhandah¥lls av miljn d¦r modellen krs.
En modells frm¥ga att planera en uppgift inneb¦r inte att varje chattgr¦nssnitt automatiskt till¥ter den att surfa p¥ webbplatser, anv¦nda applikationer eller kra kod.
Vilka ¦r begr¦nsningarna?
GPT-6 Astra har ett hgre standardpris fr API-tokens ¦n de andra tv¥ modellerna i denna j¦mfrelse. Dess publicerade priser ¦r $10 per miljon indata-tokens och $50 per miljon utdata-tokens, fre till¦mpliga rabatter fr cachning, verktygsavgifter och andra avgifter.
Fr anv¦ndare som kr m¥nga l¥nga konversationer eller stora automatiserade arbetsflden kan kostnaderna snabbt plocka iv¦g.
Modellen br d¦rfr utv¦rderas utifr¥n kvaliteten p¥ det slutfrda arbetet, inte bara dess rena intelligens. Om ett billigare alternativ ger lika p¥litliga resultat fr en rutinuppgift kanske det inte ¦r ndv¦ndigt att betala fr den dyrare modellen.
L¦s mer i OpenAI:s dokumentation fr GPT-6 Astra.
Claude Opus 5.5: Kodningsagenter och l¥ngkrande uppgifter
Claude Opus 5.5 ¦r positionerad kring kr¦vande mjukvaruutveckling, l¥ngkrande agentarbetsflden och professionellt arbete. Dess lockrop fr m¥nga utvecklare ¦r mjligheten att delegera en komplicerad uppgift och samtidigt bibeh¥lla de ursprungliga kraven under hela processen.
Detta ¦r s¦rskilt viktigt n¦r ett projekt involverar flera filer, flera beroenden eller en l¥ng sekvens av beslut.
Viktiga styrkor
Frst¥else fr kodbasen
En anv¦ndbar kodningsmodell m¥ste frst¥ hur olika delar av ett projekt samverkar. Den br kunna identifiera orsaken till en bugg, avgra vilka filer som behver ¦ndras och undvika att infra nya fel p¥ andra st¦llen.
Claude Opus 5.5 ¦r en stark kandidat att utv¦rdera fr dessa arbetsflden, s¦rskilt n¦r uppgiften kr¦ver ih¥llande uppm¦rksamhet p¥ ett projekts struktur och krav.
Komplexa instruktioner och skrivande
M¥nga professionella uppgifter involverar detaljerade instruktioner som inte kan reduceras till en enda fr¥ga. En anv¦ndare kan ange m¥lgrupp, ton, tekniska begr¦nsningar, formateringsregler och en lista ver obligatoriska leverabler.
Claude kan utv¦rderas p¥ hur v¦l den fljer dessa begr¦nsningar, uppr¦tth¥ller konsekvens och producerar arbete som kr¦ver minimal redigering.
L¥ngkrande agentarbetsflden
Fr utvecklingsteam kan en AI-agent behva inspektera ett projekt, gra ¦ndringar, kra tester, tolka fel och revidera sin implementering.
Antalet framg¥ngsrikt slutfrda steg ¦r ofta mer meningsfullt ¦n kvaliteten p¥ det frsta svaret.
Vilka ¦r begr¦nsningarna?
En kapabel modell kan fortfarande verkomplicera en uppgift, gra felaktiga antaganden eller frbruka avsev¦rda anv¦ndningskvoter under en l¥ng session.
Tillg¥ngsbegr¦nsningar och prenumerationsregler spelar ocks¥ roll. Diskussioner i gemenskapen n¦mner ofta anv¦ndningsgr¦nser, ¦ven n¦r anv¦ndarna ¦r njda med modellens kvalitet.
Claude Opus 5.5:s publicerade standard-API-priser ¦r $4 per miljon indata-tokens och $20 per miljon utdata-tokens. Dessa ¦r l¦gre ¦n Astras standardpriser, ¦ven om den faktiska kostnaden beror p¥ anv¦ndningsmnster, cachning och ytterligare tj¦nster.
Se Anthropics officiella Claude Opus-dokumentation fr aktuell produkt- och prisinformation.
Vad s¦ger egentligen benchmark-resultaten?
Benchmark-resultat ¦r anv¦ndbara fr att frst¥ modellernas frm¥gor, men de ber¦ttar inte hela historien.
Olika tester m¦ter olika f¦rdigheter. En modell som presterar v¦l i ett l¥ngt benchmark fr mjukvaruutveckling kanske inte ¦r det b¦sta valet fr faktabaserad forskning, skrivande eller visuell analys.
Googles tillk¦nnagivande av Argon och de publicerade utv¦rderingsresultaten fr GPT-6 Astra ger flera anv¦ndbara j¦mfrelsepunkter.
Utvalda benchmark-resultat fr kodning
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Cirka 78 % | 74,1 % | Cirka 74 % |
| FrontierSWE v2 | Se Googles publicerade utv¦rdering | Rapporterad frdel i tillg¦ngliga j¦mfrelser | Se Googles publicerade utv¦rdering |
| Terminal-Bench 4.0 | Se Googles publicerade utv¦rdering | 57,9 % i OpenAI:s publicerade resultat | Olika utv¦rderingsresultat kan g¦lla |
K¦llor: Googles tillk¦nnagivande av Argon, OpenAI:s modelldokumentation fr Astra och j¦mfrelsen fr¥n oktober 2026 av Argon och dess konkurrenter.
Viktigt: Dessa siffror br betraktas som rapporterade resultat, inte som en helt kontrollerad oberoende j¦mfrelse. Resultaten kan skilja sig ¥t beroende p¥ modellversion, testramverk, verktygstillg¥ng, resonemangsinst¦llningar och utv¦rderingsdatum. D¦r de ursprungliga k¦llorna inte fastst¦ller en direkt j¦mfrbar siffra undviker tabellen medvetet att hitta p¥ en.
De tillg¦ngliga resultaten visar ocks¥ varfr en universell rankning ¦r missvisande. Argon har rapporterats leda p¥ DeepSWE v1.1, medan Astra och Opus kan prestera annorlunda p¥ andra utv¦rderingar fr mjukvaruutveckling.
Ett b¦ttre tillv¦gag¥ngss¦tt ¦r att fr¥ga vilket benchmark som liknar din faktiska arbetsbrda.
- Fr kodunderh¥ll: prioriterade uppgifter i verkliga kodarkiv och andelen godk¦nda tester.
- Fr forskning: m¦t faktaenlighet och om k¦llh¦nvisningar stdjer p¥st¥endena.
- Fr agentarbetsflden: m¦t fullst¦ndigt slutfrande fr¥n brjan till slut samt ¥terh¦mtning fr¥n fel.
- Fr aff¦rsskrivande: utv¦rdera korrekthet, efterlevnad av instruktioner och redigeringstid.
Riktm¦rket (benchmark) ¦r en startpunkt. Din egen uppgift ¦r det slutliga testet.
Vad s¦ger Reddit-anv¦ndare om dessa modeller?
Reddit ger ett annat perspektiv ¦n officiella tillk¦nnagivanden. Anv¦ndare diskuterar de delar av modellens prestanda som de l¦gger m¦rke till under det dagliga arbetet, inklusive kodkvalitet, kreativitet, hastighet, anv¦ndningsgr¦nser och hur mycket v¦gledning en modell behver.
Dessa diskussioner ger anv¦ndbara bevis p¥ anv¦ndarnas prioriteringar, men de ¦r anekdotiska. Ett inl¦gg bevisar inte att en modell ¦r objektivt b¦ttre fr varje anv¦ndare.
Gemini 4 Argon: Imponerande resultat, men tillg¥ngen ¦r fortfarande ett problem
I r/singularity-diskussionen om Gemini 4 Argon-benchmarks diskuterade anv¦ndarna Googles rapporterade resultat inom kodning, cybers¦kerhet och professionella uppgifter.
En ¥terkommande fr¥ga var om modellens prestanda skulle oms¦ttas i praktiska frdelar och n¦r en bredare tillg¥ng skulle bli tillg¦nglig.
Detta skapar en anv¦ndbar distinktion fr en j¦mfrelseartikel: ledarskap i benchmarks ¦r inte detsamma som vardaglig anv¦ndbarhet. Anv¦ndare behver ett s¦tt att testa modellen p¥ sina egna uppgifter innan de best¦mmer om den ¦r v¦rd att ta i bruk.
GPT-6 Astra vs Claude Opus 5.5: Kvalitet, hastighet och anv¦ndningsgr¦nser
r/ClaudeAI-diskussionen som j¦mfr Opus 5.5 med GPT-6 Astra illustrerar hur snabbt gemenskapens preferenser kan ¦ndras mellan modelllanseringar.
Deltagarna beskrev olika erfarenheter av modellerna. Vissa fredrog Astra, medan andra bermde Opus 5.5:s frm¥gor men kritiserade den m¦ngd v¦gledning som de ibland behvde ge.
Den bredare l¦rdomen ¦r att modellkvaliteten delvis beror p¥ uppgiften och anv¦ndarens arbetsflde. En modell som fungerar bra fr en utvecklare kan vara mindre l¦mplig fr kraven i ett annat projekt.
Anv¦ndningsgr¦nser ¦r ett annat bekymmer. I en Reddit-diskussion om att v¦lja mellan Opus 5.5 och Astra reste en anv¦ndare fr¥gor om att frbruka sin kvot och om att byta prenumeration skulle ge b¦ttre v¦rde.
Fr frekventa anv¦ndare kan kostnaden fr l¥ngvarigt arbete spela lika stor roll som kvaliteten p¥ enskilda svar.
En enkel kreativ uppgift kan ge olika resultat
I en Reddit-j¦mfrelse av Opus 5.5, GPT-6 Astra och andra modeller diskuterade anv¦ndare att ge flera modeller samma prompt fr att skapa en kort pappersflygplansanimation.
Svaren ¥terspeglade olika preferenser: vissa anv¦ndare fredrog animationskvaliteten, medan andra fredrog tolkningen eller den kreativa riktningen hos en annan modell.
Detta ¦r en anv¦ndbar p¥minnelse om att modellj¦mfrelser inte ¦r begr¦nsade till kodning och resonemang. Fr kreativt arbete kan utdatakvaliteten vara subjektiv, och den mest l¦mpliga modellen beror p¥ det resultat anv¦ndaren vill ha.
Vad kan vi l¦ra oss av diskussionerna?
Tv¦rs ver dessa tr¥dar sticker fyra teman ut:
- Prestanda i den verkliga v¦rlden betyder mer ¦n ett rubrikresultat. Anv¦ndare vill ha modeller som lser deras specifika problem.
- Frm¥gan att flja instruktioner p¥verkar produktiviteten. En stark modell ¦r mer anv¦ndbar n¦r den frst¥r begr¦nsningar utan upprepade frtydliganden.
- Anv¦ndningsgr¦nser p¥verkar den totala upplevelsen. Hgkvalitativa resultat ¦r mindre v¦rdefulla om anv¦ndare inte kan uppr¦tth¥lla sitt arbetsflde.
- Olika uppgifter belnar olika styrkor. Kreativa utdata, kodning, forskning och automatisering br inte utv¦rderas med samma kriterier.
Dessa observationer br informera testerna i den h¦r artikeln, snarare ¦n att ers¦tta dem.
Hur man j¦mfr de tre modellerna i verkliga uppgifter
Den mest anv¦ndbara j¦mfrelsen skulle ge alla tre modeller samma uppgift, samma indatamaterial och samma utv¦rderingskriterier.
Om alla tre modeller ¦r tillg¦ngliga fr dig kan fljande tester hj¦lpa till att avgra vilken som passar ditt arbetsflde.
Test 1: Kodning och felskning
Ge varje modell samma lilla kodbas som inneh¥ller en reproducerbar bugg. Be den identifiera problemet, implementera en korrigering, skriva tester och frklara ¦ndringarna.
M¦t:
- Om den ursprungliga buggen har ¥tg¦rdats
- Om befintliga tester fortfarande blir godk¦nda
- Om nya buggar har infrts
- Hur m¥nga uppfljningsprompter som behvs
- Total tid och tokenanv¦ndning
En modell som ger en rimlig frklaring men misslyckas i testerna br inte anses vara vinnaren.
Test 2: Forskning och dokumentanalys
Tillhandah¥ll samma upps¦ttning rapporter, tabeller och k¦lldokument. Be varje modell att sammanfatta bevisen, extrahera viktiga siffror, identifiera mots¦gelser och frbereda en kort rapport med referenser.
M¦t faktaenlighet, kvalitet p¥ k¦llh¦nvisningar, t¦ckning av viktig information och m¦ngden manuell korrigering som kr¦vs.
Detta test ¦r s¦rskilt anv¦ndbart fr analytiker, studenter, konsulter och inneh¥llsteam.
Test 3: Genomfrande av flerstegsprojekt
Ge varje modell en uppgift som kr¦ver flera leverabler, som att analysera en produktid←, utveckla en projektplan, skapa en uppgiftstabell och frbereda en slutrapport.
Utv¦rdera om den fljer den ndv¦ndiga sekvensen, uppr¦tth¥ller konsekvens mellan leverablerna och kontrollerar det slutliga resultatet.
Om miljn tillhandah¥ller verktyg, registrera om modellen anv¦nder dem korrekt. Skilj modellens intelligens fr¥n funktionerna i plattformen som kr den.
Test 4: Skrivande och instruktionsfljning
Tillhandah¥ll en detaljerad skrivbrief med m¥lgrupp, ton, obligatoriska punkter, l¦ngd och begr¦nsningar.
J¦mfr resultaten avseende korrekthet, l¦sbarhet, struktur, originalitet och efterlevnad av briefen.
Fr marknadsfringsteam kan detta avslja vilken modell som producerar anv¦ndbara frsta utkast och vilken som kr¦ver mer redigering.
Anv¦nd ett konsekvent po¦ngramverk
En enkel utv¦rdering p¥ 100 po¦ng kan gra resultaten l¦ttare att j¦mfra.
| Kriterium | Freslagen vikt |
|---|---|
| Exakthet och korrekthet | 30 |
| Slutfrande av uppgift | 25 |
| Efterlevnad av instruktioner | 15 |
| Utdatakvalitet | 15 |
| Hastighet och effektivitet | 10 |
| Kostnad | 5 |
| Totalt | 100 |
Viktningen br ¦ndras beroende p¥ uppgiften. Till exempel br kodningstester l¦gga strre vikt vid fungerande kod och godk¦nda tester, medan forskningstester br prioritera faktaenlighet och k¦llkvalitet.
Publicera inte po¦ng som ett oberoende test med mindre ¦n att du faktiskt har krt experimentet. Om tillg¥ngen till Argon ¦r begr¦nsad, anv¦nd en tydligt m¦rkt j¦mfrelse av publicerade resultat och reservera avsnittet fr oberoende tester fr modeller som du verkligen kan utv¦rdera.
J¦mfrelse av priser: Vilken modell ger b¦st v¦rde?
De standard-API-priser som publicerats fr dessa modeller ger en anv¦ndbar utg¥ngspunkt.
| Modell | Indata per 1M tokens | Utdata per 1M tokens |
|---|---|---|
| Gemini 4 Argon | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
K¦llor: Google, OpenAI och Anthropic.
Med dessa publicerade standardpriser har Argon det l¦gsta angivna token-priset, fljt av Opus 5.5 och Astra. Det gr dock inte automatiskt Argon till det billigaste praktiska alternativet fr varje anv¦ndare, s¦rskilt inte s¥ l¦nge tillg¥ngen frblir begr¦nsad.
Exempel: En uppgift som anv¦nder 100 000 indata-tokens och 20 000 utdata-tokens
Antag att de publicerade priserna g¦ller, utan cachningsrabatter, verktygsavgifter eller andra avgifter:
- Gemini 4 Argon: $0,20 indata + $0,20 utdata = $0,40
- GPT-6 Astra: $1,00 indata + $1,00 utdata = $2,00
- Claude Opus 5.5: $0,40 indata + $0,40 utdata = $0,80
Detta ¦r ett exempel p¥ tokenkostnad, inte ett p¥st¥ende om att modellerna anv¦nder samma antal tokens fr att slutfra samma uppgift.
Fr en r¦ttvisare j¦mfrelse br du ber¦kna kostnaden fr att producera ett framg¥ngsrikt resultat. Om en modell behver fem omfrsk och en annan slutfr uppgiften p¥ ett frsk kan deras effektiva kostnader skilja sig avsev¦rt fr¥n det vanliga token-prisfrh¥llandet.
Prenumerationsplaner har ocks¥ sin egen priss¦ttning, sina egna gr¦nser och anv¦ndningsregler. J¦mfr inte API-priser direkt med prenumerationsavgifter som om de vore likv¦rdiga.
Vilken AI-modell ¦r b¦st fr dina behov?
R¦tt modell beror p¥ vad du gr, hur ofta du anv¦nder AI och hur ett framg¥ngsrikt resultat ser ut.
Fr mjukvaruutvecklare
ᅱverv¦g att testa GPT-6 Astra och Claude Opus 5.5 p¥ din faktiska kodbas. B¥da ¦r positionerade fr kr¦vande tekniskt arbete, men deras relativa prestanda beror p¥ ditt spr¥k, dina verktyg och projektets komplexitet.
Gemini 4 Argon ¦r ocks¥ v¦rd att h¥lla gonen p¥ fr sina rapporterade resultat inom mjukvaruutveckling, med frbeh¥ll fr tillg¥ng och oberoende verifiering.
Fr forskare och analytiker
Prioritera exakt informationsextraktion, p¥litliga k¦llh¦nvisningar, hantering av l¥nga dokument och frm¥gan att skilja fakta fr¥n antaganden.
Fr arbete som involverar stora samlingar av filer, testa om modellen kan hitta relevanta detaljer utan att frbise motstridiga bevis.
Fr inneh¥llsskapare och marknadsfrare
J¦mfr hur v¦l varje modell fljer en inneh¥llsbrief, uppr¦tth¥ller en konsekvent ton, organiserar information och producerar utkast som kr¦ver minimal redigering.
Ett praktiskt arbetsflde kan inkludera skordsresearch, disposition, utkast, faktagranskning och anpassning av inneh¥ll fr olika m¥lgrupper. M¦nsklig granskning ¦r fortfarande avgrande, s¦rskilt fr faktap¥st¥enden och SEO-inneh¥ll.
Fr aff¦rsanv¦ndare
Fokusera p¥ slutfrande av uppgifter, dokumentanalys, kalkylbladsarbetsflden, rapportering och tillfrlitlighet i utdata.
Fr ¥terkommande uppgifter kan ¦ven en liten minskning av tiden fr manuell granskning spela strre roll ¦n en m¥ttlig frb¦ttring i benchmark-resultat.
Fr budgetmedvetna anv¦ndare
J¦mfr den faktiska kostnaden fr att slutfra dina vanliga uppgifter snarare ¦n att v¦lja en modell enbart baserat p¥ dess annonserade intelligens.
Om en billigare modell konsekvent uppfyller dina krav kan den vara det b¦ttre vardagsalternativet. Reservera dyrare modeller fr arbete d¦r deras ytterligare frm¥gor gr en m¦tbar skillnad.
Hur du utforskar AI-modeller och slutfr uppgifter p¥ ChatGOAT AI
Att j¦mfra modeller ¦r anv¦ndbart, men den verkliga nyttan med AI kommer fr¥n att till¦mpa den i ditt eget arbete.
ChatGOAT AI tillhandah¥ller en AI-arbetsyta fr modeller och verktyg som stds, vilket hj¦lper anv¦ndare att utforska AI-assisterat skrivande, forskning, analys och kreativa arbetsflden utan att behandla varje uppgift som ett separat experiment.
D¦r Gemini 4 Argon, GPT-6 Astra och Claude Opus 5.5 ¦r aktiverade i den aktuella modellv¦ljaren p¥ ChatGOAT kan anv¦ndare utforska deras svar inom plattformen och utv¦rdera vilket tillv¦gag¥ngss¦tt som fungerar b¦st fr deras behov. Tillg¦ngligheten kan variera beroende p¥ modell och integration, s¥ kontrollera den aktuella modellistan innan du brjar.
Vad kan du gra med AI p¥ ChatGOAT AI?
Anv¦nd AI fr att brainstorma artikelid←er, bygga dispositioner, skriva utkast till blogginl¦gg, omformulera stycken, sammanfatta l¥ngt material eller anpassa inneh¥ll fr olika m¥lgrupper.
Till exempel kan en SEO-specialist utveckla en bloggdisposition, skriva ett utkast till en j¦mfrelseartikel, frbereda FAQ-svar och revidera inneh¥llet fr tydlighet och skavsikt.
Analysera information och dokument
AI kan hj¦lpa till att extrahera nyckelpunkter fr¥n tillhandah¥llna material, j¦mfra rapporter, organisera forskningsresultat och omvandla ostrukturerade anteckningar till en tydligare sammanfattning.
Till exempel kan en aff¦rsanv¦ndare omvandla mtesanteckningar till en handlingsplan, skapa en j¦mfrelsetabell och frbereda en koncis sammanfattning fr ledningen.
Skapa strukturerade tabeller och projektplaner
Anv¦nd AI fr att organisera produktj¦mfrelser, frbereda uppgiftslistor, bygga forskningsmatriser och skapa strukturerade projektplaner.
Ett marknadsfringsteam kan anv¦nda detta arbetsflde fr att j¦mfra konkurrenters funktioner, koppla skord till landningssidor och organisera en inneh¥llskalender.
Stdja kodning och problemlsning
Fr kodningsarbetsflden som stds kan AI frklara ok¦nd kod, fresl¥ felskningssteg, skriva utkast till funktioner och hj¦lpa till att organisera teknisk dokumentation.
Testa alltid genererad kod och granska ¦ndringar innan du anv¦nder dem i produktion.
ChatGOAT AI tillhandah¥ller ocks¥ funktioner fr AI-bildgenerering via sina bildverktyg och modeller som stds. Dessa kan hj¦lpa anv¦ndare att skapa illustrationer, visuella koncept, grafik fr sociala medier och andra kreativa tillg¥ngar.
Bildgenerering ¦r en separat frm¥ga fr¥n textmodellernas resonemang. Anta inte att varje modell i denna j¦mfrelse kan generera bilder direkt bara fr att arbetsytan inneh¥ller bildverktyg.
Bygg ett mer effektivt arbetsflde
Ist¦llet fr att behandla varje uppgift som en isolerad prompt kan anv¦ndare dela upp ett projekt i steg: forskning, planering, utkast, kontroll och slutleverans.
Det mest anv¦ndbara arbetsfldet ¦r det som ger exakta resultat med mindre repetitivt arbete, inte ndv¦ndigtvis det som anv¦nder den mest avancerade modellen fr varje steg.
Utforska ChatGOAT AI fr att se vilka modeller och AI-verktyg som fr n¦rvarande stds fr ditt arbetsflde.
FAQ
ᅣr Gemini 4 Argon b¦ttre ¦n GPT-6 Astra?
Inte i alla situationer. Google har rapporterat starka resultat fr Argon p¥ utvalda benchmarks fr teknik och professionellt arbete, medan OpenAI publicerar starka resultat fr Astra p¥ flera kr¦vande utv¦rderingar. Tillg¥ngsbegr¦nsningar och skillnader i testmetoder gr en universell rankning frhastad.
ᅣr Claude Opus 5.5 b¦ttre ¦n GPT-6 Astra p¥ kodning?
B¥da ¦r utformade fr kr¦vande mjukvaruutvecklingsuppgifter. Det b¦ttre alternativet beror p¥ kodbasen, programmeringsspr¥ket, tillg¦ngliga verktyg och kvaliteten p¥ den slutliga implementeringen. J¦mfr andelen godk¦nda tester, regressionsrisker, antalet iterationer och totalkostnaden fr samma uppgift.
Vilken modell ¦r b¦st fr komplexa resonemang?
GPT-6 Astra och Gemini 4 Argon ¦r b¥da positionerade fr komplexa resonemang och flerstegsarbete, medan Claude Opus 5.5 ¦r utformad fr kr¦vande professionella och agentbaserade arbetsflden. Anv¦nd uppgiftsspecifika tester fr att avgra vilken modell som presterar b¦st fr dina behov.
Vilken modell ¦r billigast?
Baserat p¥ de publicerade standard-API-priserna ovan har Gemini 4 Argon det l¦gsta tokenpriset, fljt av Claude Opus 5.5 och GPT-6 Astra. Argons begr¦nsade tillg¦nglighet p¥verkar dock om de flesta anv¦ndare faktiskt kan utnyttja den priss¦ttningen. Den totala kostnaden fr en uppgift beror ocks¥ p¥ tokenanv¦ndning, omfrsk, cachning och verktyg.
Kan jag anv¦nda Gemini 4 Argon just nu?
Google tillk¦nnagav inledningsvis Argon fr betrodda cybers¦kerhetsfrsvarare via Fairwind-programmet, med planerad bredare tillg¥ng. Kontrollera Googles senaste officiella tillk¦nnagivande fr ¦ndringar i tillg¦nglighet innan du frlitar dig p¥ den i ett projekt.
Kan jag j¦mfra dessa modeller p¥ ChatGOAT AI?
Du kan utforska modeller och verktyg som stds av den aktuella ChatGOAT AI-arbetsytan. Fr att j¦mfra alla tre direkt, verifiera att Gemini 4 Argon, GPT-6 Astra och Claude Opus 5.5 finns tillg¦ngliga i den aktuella modellv¦ljaren. Om n¥gon inte ¦r tillg¦nglig kan du ist¦llet j¦mfra dess publicerade dokumentation med praktiska resultat fr¥n tillg¦ngliga modeller.
Vilken modell ¦r b¦st fr vardagligt arbete?
Det finns inget universellt svar. ᅱverv¦g de uppgifter du utfr oftast, hur exakta resultaten behver vara, m¦ngden redigering som kr¦vs, din budget och anv¦ndningsgr¦nserna p¥ din fredragna plattform. Att testa n¥gra representativa uppgifter ¦r mer anv¦ndbart ¦n att v¦lja enbart efter rykte.
Slutgiltig dom: V¦lj den modell som utfr ditt arbete b¦st
Gemini 4 Argon, GPT-6 Astra och Claude Opus 5.5 representerar olika tillv¦gag¥ngss¦tt fr avancerad AI-assistans. Argon har rapporterade styrkor i utvalda utv¦rderingar av teknik och professionellt arbete, Astra riktar in sig p¥ kr¦vande resonemangs- och datoranv¦ndningsuppgifter, och Opus 5.5 fokuserar p¥ kodningsagenter och l¥ngkrande professionella arbetsflden.
Den b¦sta modellen ¦r inte ndv¦ndigtvis den med hgst po¦ng eller det dyraste API:et. Det ¦r den som tillfrlitligt slutfr dina uppgifter, fljer dina instruktioner, passar din budget och kr¦ver minst ondigt ingripande.
Anv¦nd officiella benchmarks fr att sn¦va av dina alternativ, Reddit-diskussioner fr att frst¥ fr¥gorna som verkliga anv¦ndare st¦ller och konsekvent praktisk testning fr att fatta det slutliga beslutet.
Med ChatGOAT AI kan du utforska AI-modeller och verktyg som stds fr skrivande, forskning, analys och kreativt arbete i en och samma arbetsyta. Brja med en uppgift som du faktiskt behver slutfra, j¦mfr kvaliteten p¥ resultaten och v¦lj det arbetsflde som gr ditt arbete enklare.