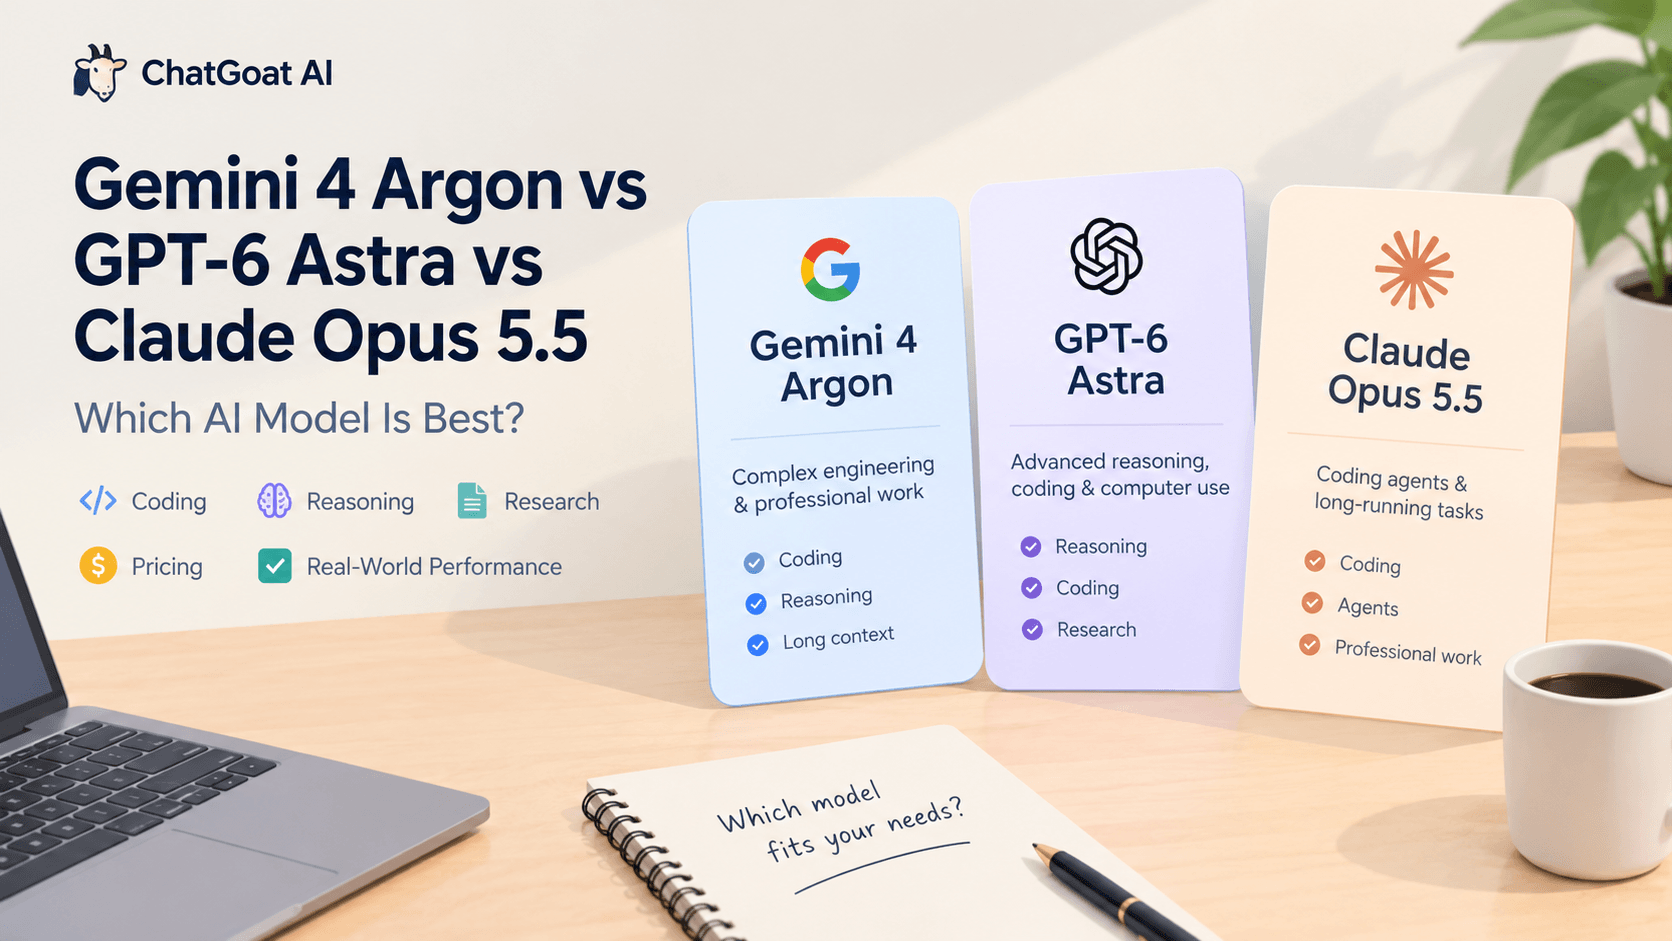
Конкуренция между Gemini 4 Argon, GPT-6 Astra и Claude Opus 5.5 подчеркивает важный сдвиг в области искусственного интеллекта. Сегодня ведущие модели оценивают не только по тому, насколько хорошо они отвечают на вопросы. Разработчики, исследователи и обычные пользователи также хотят получить ИИ, способный решать сложные задачи, понимать крупные проекты, писать надежный код, анализировать документы и выполнять многоэтапные поручения с меньшим контролем.
Каждая модель обладает своим набором сильных сторон. Google позиционирует Gemini 4 Argon как решение для сложного инжиниринга, профессиональной работы с знаниями и защиты в сфере кибербезопасности. OpenAI представляет GPT-6 Astra как модель для сложных задач на рассуждение, написание кода, исследования и управление компьютером. Anthropic делает акцент на возможностях Claude Opus 5.5 в области разработки программного обеспечения, долгоживущих агентов и профессиональной деятельности.
Но какую модель выбрать именно вам? Действительно ли Gemini 4 Argon лучше справляется с написанием кода? Оправдывает ли GPT-6 Astra более высокую стоимость API? Способна ли Claude Opus 5.5 выполнять сложные проекты с меньшим количеством инструкций?
В этом сравнении рассматриваются официальные результаты бенчмарков, цены, доступность, практические сценарии использования и обсуждения на Reddit. Также в нем объясняется, как оценить эти модели для реальной работы и изучить рабочие процессы на базе ИИ с помощью ChatGOAT AI.
Краткий вердикт: Gemini 4 Argon против GPT-6 Astra против Claude Opus 5.5
Единого победителя для всех задач не существует. Оптимальный выбор зависит от характера выполняемой работы, вашего бюджета и возможности доступа к модели через предпочитаемую платформу.
| Сравнение | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Основное позиционирование | Сложный инжиниринг и профессиональные рабочие процессы | Продвинутые рассуждения, написание кода, исследования и управление компьютером | Кодинг-агенты и долгоживущие профессиональные задачи |
| Написание кода | Высокие результаты на отдельных бенчмарках по разработке ПО | Высокие показатели в сложных технических задачах и кодинге, требующем рассуждений | Разработана для сложного кодинга и агентских рабочих процессов |
| Рассуждение | Создана для решения сложных многоэтапных задач | Спроектирована для сложных рассуждений и профессиональной работы | Отлично справляется со сложными инструкциями и длительной работой |
| Работа с большим контекстом | Заявлено до 1 миллиона выходных токенов | Контекстное окно в 1,05 миллиона токенов | Долгоживущие агентские процессы и крупные проекты |
| Стандартная цена за входные токены API | $2 за миллион токенов | $10 за миллион токенов | $4 за миллион токенов |
| Стандартная цена за выходные токены API | $10 за миллион токенов | $50 за миллион токенов | $20 за миллион токенов |
| Доступность | Изначально ограничена кругом доверенных специалистов по кибербезопасности | Доступна через поддерживаемые продукты и API OpenAI | Доступна через поддерживаемые платформы Claude и платформы для разработчиков |
Источники: Анонс Google Gemini 4 Argon, Документация модели OpenAI GPT-6 Astra и Документация Anthropic Claude Opus.
Не следует ранжировать эти модели только по цене или одному бенчмарку. Модели с меньшей стоимостью токена может потребоваться больше повторных попыток для завершения задачи, в то время как модель с впечатляющим результатом в бенчмарке может быть недоступна рядовому пользователю.
Практический вывод: сравнивайте качество финального результата, затраченное время, количество исправлений и фактическую стоимость выполнения вашей задачи.
Gemini 4 Argon: создана для сложного инжиниринга и работы с знаниями
Google анонсировала Gemini 4 Argon 30 сентября 2026 года, позиционируя ее как передовую модель для реальной разработки ПО, корпоративной работы с знаниями и защиты в сфере кибербезопасности.
В отличие от моделей, предназначенных преимущественно для повседневного общения, Argon представлена как система, способная справляться с длинными взаимосвязанными задачами. Они могут включать в себя изучение обширной технической информации, выявление проблем, планирование последовательности действий и получение итогового результата.
Ключевые преимущества
Сложная разработка ПО
Argon продемонстрировала высокие результаты в отдельных бенчмарках по разработке ПО. В анонсе Google акцентируется внимание на долгосрочных инженерных задачах, где система ИИ должна удерживать контекст во время работы над сложной проблемой.
Среди возможных сфер применения — анализ крупной кодовой базы, поиск источника ошибки, планирование миграции и оценка того, решают ли предлагаемые изменения исходную проблему.
Профессиональные исследования и анализ документов
Google также выделяет юридическую, финансовую и другую корпоративную работу с знаниями. Это делает задачи с большим объемом документов важной областью для оценки, особенно когда модели необходимо сопоставлять информацию из нескольких файлов.
Например, бизнес-аналитик может использовать процесс на базе ИИ для обобщения отчетов, извлечения финансовых показателей, сравнения допущений и подготовки структурированного отчета для проверки человеком.
Генерирование длинных текстов
Google заявила о максимальном лимите вывода для Argon — до одного миллиона токенов. Это допустимый объем генерируемого ответа, а не контекстное окно. Это различие важно при сравнении моделей, поскольку объем информации, который модель может принять, и объем, который она может сгенерировать — это разные возможности.
Каковы ограничения?
Самое большое практическое ограничение — это доступ. На момент анонса Google развертывала Argon только для доверенных специалистов по кибербезопасности в рамках программы Fairwind, а более широкий доступ планировался на более позднем этапе.
Это означает, что опубликованные результаты не следует автоматически считать независимо воспроизводимыми обычными пользователями.
Высокий балл в бенчмарке также не гарантирует, что Argon превзойдет другие модели в каждом языке программирования, исследовательской задаче или реальном проекте.
Для получения подробной информации см. официальный анонс Gemini 4 Argon от Google.
GPT-6 Astra: продвинутые рассуждения, кодинг и управление компьютером
OpenAI описывает GPT-6 Astra как модель для сложных профессиональных задач, включая глубинное рассуждение, разработку ПО, исследования, создание документов и управление компьютером.
Ее ценность не ограничивается формированием хорошего ответа за один диалог. В подходящих рабочих процессах цель состоит в том, чтобы продумать проблему, использовать доступные инструменты и двигаться к четко определенному результату.
Ключевые преимущества
Продвинутые рассуждения
GPT-6 Astra предназначена для задач, требующих большего, чем просто поиск факта или генерация краткого ответа. Ее можно оценивать по математическим рассуждениям, планированию, сложным техническим вопросам и задачам со множеством ограничений.
Например, продакт-менеджер может попросить ее сравнить конкурирующие продуктовые стратегии, выявить риски, построить структуру принятия решений и составить план реализации.
Разработка ПО и отладка
Astra может помогать разработчикам генерировать код, инспектировать существующие реализации, диагностировать ошибки и решать более сложные инженерные задачи.
Полезные тесты включают отладку незнакомого проекта, изменение нескольких файлов, генерацию юнит-тестов и проверку того, соответствует ли итоговая реализация требованиям.
Управление компьютером и агентские процессы
OpenAI также документирует возможности, связанные с управлением компьютером. Однако фактическая автоматизация зависит от инструментов, прав доступа и средств защиты, предоставляемых средой, в которой работает модель.
Способность модели планировать задачу не означает, что любой чат-интерфейс автоматически позволяет ей просматривать веб-сайты, работать с приложениями или выполнять код.
Каковы ограничения?
GPT-6 Astra имеет более высокую стандартную цену токенов API, чем две другие модели в этом сравнении. Ее опубликованные тарифы составляют $10 за миллион входных токенов и $50 за миллион выходных токенов до применения скидок на кэширование, платы за инструменты и других сборов.
Для пользователей, проводящих много длительных сессий или запускающих крупные автоматизированные процессы, расходы могут быстро вырасти.
Поэтому модель следует оценивать по качеству выполненной работы, а не только по ее «чистому интеллекту». Если более дешевая альтернатива дает столь же надежные результаты в рутинной задаче, переплачивать за более дорогую модель может не потребоваться.
Подробнее читайте в документации OpenAI по GPT-6 Astra.
Claude Opus 5.5: кодинг-агенты и долгоживущие задачи
Claude Opus 5.5 позиционируется в области сложного инжиниринга ПО, долгоживущих агентских процессов и профессиональной работы. Ее привлекательность для многих разработчиков заключается в возможности делегировать сложную задачу со сохранением исходных требований на протяжении всего процесса.
Это особенно важно, когда проект включает в себя несколько файлов, множественные зависимости или длинную цепочку решений.
Ключевые преимущества
Понимание кодовой базы
Эффективная модель для кодинга должна понимать, как взаимодействуют различные части проекта. Она должна уметь определять причину ошибки, выявлять, в какие файлы нужно внести изменения, и избегать появления регрессий в других местах.
Claude Opus 5.5 — отличный кандидат для оценки таких рабочих процессов, особенно когда задача требует постоянного внимания к структуре и требованиям проекта.
Сложные инструкции и составление текстов
Многие профессиональные задачи включают подробные инструкции, которые нельзя свести к одному вопросу. Пользователь может указать аудиторию, тон, технические ограничения, правила форматирования и список необходимых результатов.
Claude можно оценить по тому, насколько хорошо она соблюдает эти ограничения, сохраняет последовательность и выдает результат, требующий минимальной правки.
Долгоживущие агентские процессы
Командам разработки может потребоваться ИИ-агент для анализа проекта, внесения изменений, запуска тестов, интерпретации ошибок и корректировки реализации.
Количество успешно выполненных шагов часто оказывается важнее, чем качество первого ответа.
Каковы ограничения?
Даже продвинутая модель может усложнить задачу, сделать неверные предположения или израсходовать значительный лимит использования во время длительной сессии.
Ограничения доступа и правила подписки также имеют значение. В обсуждениях сообщества часто упоминаются лимиты использования, даже когда пользователи довольны качеством работы модели.
Опубликованные стандартные тарифы API для Claude Opus 5.5 составляют $4 за миллион входных токенов и $20 за миллион выходных токенов. Это ниже стандартных тарифов Astra, хотя фактическая стоимость зависит от характера использования, кэширования и дополнительных услуг.
См. официальную документацию Anthropic по Claude Opus для получения актуальной информации о продукте и ценах.
О чем нам в действительности говорят бенчмарки?
Баллы в бенчмарках полезны для понимания возможностей моделей, но они не отражают всей картины.
Различные тесты измеряют разные навыки. Модель, показывющая отличные результаты в бенчмарке по разработке ПО, может оказаться не лучшим выбором для фактических исследований, написания текстов или визуального анализа.
Анонс Argon от Google и опубликованные результаты оценки GPT-6 Astra дают несколько полезных ориентиров для сравнения.
Отдельные результаты бенчмарков по кодингу
| Бенчмарк | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Около 78% | 74.1% | Около 74% |
| FrontierSWE v2 | См. опубликованную оценку Google | Заявленное преимущество в доступных сравнениях | См. опубликованную оценку Google |
| Terminal-Bench 4.0 | См. опубликованную оценку Google | 57,9% в опубликованных результатах OpenAI | Могут применяться другие результаты оценки |
Источники: Анонс Argon от Google, документация модели Astra от OpenAI и сравнение Argon и ее конкурентов за октябрь 2026 года.
Важно: эти цифры следует рассматривать как заявленные результаты, а не как полностью контролируемое независимое сравнение. Результаты могут различаться в зависимости от версии модели, тестовой среды, доступа к инструментам, настроек рассуждения и даты оценки. Там, где исходные источники не дают напрямую сравнимых показателей, таблица намеренно избегает их сочинения.
Доступные результаты также иллюстрируют, почему универсальный рейтинг вводит в заблуждение. По имеющимся данным, Argon лидирует в DeepSWE v1.1, тогда как Astra и Opus могут показывать иные результаты в других тестах по разработке ПО.
Лучший подход — спросить себя, какой бенчмарк ближе всего к вашей реальной рабочей нагрузке.
- Для обслуживания кода отдавайте приоритет задачам в реальных репозиториях и проценту прохождения тестов.
- Для исследований оценивайте фактическую точность и соответствие цитат заявленным утверждениям.
- Для агентских процессов измеряйте сквозное выполнение задач и способность восстанавливаться после ошибок.
- Для деловой переписки и текстов оценивайте точность, следование инструкциям и время на редактирование.
Бенчмарк — это лишь отправная точка. Финальным тестом станет ваша собственная задача.
Что говорят пользователи Reddit об этих моделях?
Reddit предлагает взгляд, отличный от официальных анонсов. Пользователи обсуждают аспекты работы моделей, замечаемые в ежедневной деятельности: качество кода, креативность, скорость, лимиты использования и объем необходимых инструкций.
Эти обсуждения ценны как отражение приоритетов пользователей, однако они носят субъективный характер. Отдельная публикация не доказательство того, что одна модель объективно лучше для всех.
Gemini 4 Argon: впечатляющие результаты, но доступ вызывает вопросы
В обсуждении бенчмарков Gemini 4 Argon на r/singularity пользователи анализировали результаты Google в области кодинга, кибербезопасности и профессиональных задач.
Одним из главных вопросов было то, перерастут ли высокие показатели модели в практическую пользу и когда откроется более широкий доступ.
Это создает важное разграничение для сравнительной статьи: лидерство в бенчмарке — не то же самое, что повседневная польза. Пользователям нужна возможность протестировать модель на собственных задачах, прежде чем решать, стоит ли ее внедрять.
GPT-6 Astra против Claude Opus 5.5: качество, скорость и лимиты использования
Обсуждение на r/ClaudeAI, где сравниваются Opus 5.5 и GPT-6 Astra, показывает, как быстро меняются предпочтения сообщества между релизами моделей.
Участники делились разным опытом. Одни отдавали предпочтение Astra, другие хвалили возможности Opus 5.5, но критиковали объем вводных инструкций, которые иногда приходилось давать.
Главный вывод состоит в том, что качество работы модели частично зависит от задачи и рабочего процесса пользователя. Модель, отлично подходящая одному разработчику, может уступать при иных требованиях проекта.
Еще одна проблема — лимиты использования. В обсуждении на Reddit выбора между Opus 5.5 и Astra пользователь поднял вопрос об исчерпании лимитов и о том, станет ли смена подписки более выгодным решением.
Для активных пользователей стоимость продолжительной работы может иметь такое же значение, как и качество отдельных ответов.
Простая творческая задача может дать разные результаты
В сравнении Opus 5.5, GPT-6 Astra и других моделей на Reddit пользователи обсудили результаты отправки одинакового промпта для создания короткой анимации бумажного самолетика.
Ответы отражали разницу во вкусах: одни оценили качество анимации, другие предпочли интерпретацию или творческий подход иной модели.
Это наглядное напоминание о том, что сравнение моделей не ограничивается кодингом и рассуждениями. В творческой работе качество вывода может быть субъективным, и подходящая модель зависит от желаемого результата.
Чему нас учат эти обсуждения?
Во всех этих ветках выделяются четыре ключевые темы:
- Производительность в реальных условиях важнее громких цифр. Пользователям нужны модели, решающие их конкретные проблемы.
- Точность следования инструкциям влияет на продуктивность. Мощная модель более полезна, когда она понимает ограничения без повторных уточнений.
- Лимиты использования влияют на общее впечатление. Высокое качество теряет ценность, если пользователь не может поддерживать непрерывный рабочий процесс.
- Разные задачи требуют разных сильных сторон. Креатив, кодинг, исследования и автоматизацию нельзя оценивать по единым критериям.
Эти наблюдения должны дополнять тесты в данной статье, а не заменять их.
Как сравнить три модели в реальных задачах
Наиболее полезное сравнение предполагает предоставление всем трем моделям одинаковой задачи, одинаковых исходных материалов и единых критериев оценки.
Если вам доступны все три модели, следующие тесты помогут определить, какая из них лучше подходит для вашего рабочего процесса.
Тест 1: Написание и отладка кода
Передайте каждой модели одну и ту же небольшую кодовую базу с воспроизводимой ошибкой. Попросите ее определить проблему, внести исправление, написать тесты и объяснить изменения.
Оцените:
- Устранена ли исходная ошибка
- Проходят ли существующие тесты
- Не появились ли новые ошибки
- Сколько потребовалось дополнительных промптов
- Общее время и расход токенов
Модель, давшую правдоподобное объяснение, но провалившую тесты, не следует считать победителем.
Тест 2: Исследования и анализ документов
Предоставьте одинаковый набор отчетов, таблиц и исходных документов. Попросите каждую модель обобщить данные, извлечь ключевые цифры, выявить противоречия и подготовить краткий отчет со ссылками.
Оцените фактическую точность, качество цитирования, полноту охвата важной информации и объем требуемой ручной правки.
Этот тест особенно полезен для аналитиков, студентов, консультантов и контент-команд.
Тест 3: Выполнение многоэтапного проекта
Дайте каждой модели задачу, требующую нескольких результатов, например: анализ идеи продукта, разработку плана проекта, создание таблицы задач и подготовку итогового отчета.
Оцените, соблюдает ли она требуемую последовательность, сохраняет ли логику между материалами и проверяет ли итоговый результат.
Если среда предоставляет инструменты, зафиксируйте, корректно ли модель их использует. Отделяйте интеллект модели от возможностей платформы, на которой она запущена.
Тест 4: Написание текстов и следование инструкциям
Предоставьте подробное ТЗ на написание текста с указанием целевой аудитории, тона, обязательных пунктов, объема и ограничений.
Сравните результаты по фактической точности, читаемости, структуре, оригинальности и соответствию ТЗ.
Для маркетинговых команд это покажет, какая модель выдает готовые к использованию черновики, а какая требует глубокой редактуры.
Используйте единую систему оценки
Простая 100-балльная система оценки облегчит сравнение результатов.
| Критерий | Рекомендуемый вес |
|---|---|
| Точность и корректность | 30 |
| Завершенность задачи | 25 |
| Следование инструкциям | 15 |
| Качество результата | 15 |
| Скорость и эффективность | 10 |
| Стоимость | 5 |
| Итого | 100 |
Весовые коэффициенты должны меняться в зависимости от задачи. Например, в тестах по кодингу стоит сделать акцент на работающем коде и успешных тестах, тогда как в исследованиях приоритет отдается фактической точности и качеству источников.
Не публикуйте баллы как результаты независимого теста, если вы не проводили эксперимент лично. Если доступ к Argon ограничен, используйте четко обозначенное сравнение опубликованных данных, а раздел независимого тестирования оставьте для моделей, которые действительно можете оценить.
Сравнение цен: какая модель выгоднее?
Опубликованные стандартные тарифы API служат хорошей отправной точкой.
| Модель | Входные токены (за 1 млн) | Выходные токены (за 1 млн) |
|---|---|---|
| Gemini 4 Argon | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
Источники: Google, OpenAI и Anthropic.
Согласно заявленным тарифам, у Argon наименьшая стоимость токенов, за ней идут Opus 5.5 и Astra. Однако это не делает Argon автоматически самым дешевым вариантом на практике для любого пользователя, особенно пока доступ к ней ограничен.
Пример: задача, использующая 100 000 входных и 20 000 выходных токенов
В предположении использования стандартных тарифов, без учета скидок за кэширование, платы за инструменты или иных сборов:
- Gemini 4 Argon: $0,20 (вход) + $0,20 (выход) = $0,40
- GPT-6 Astra: $1,00 (вход) + $1,00 (выход) = $2,00
- Claude Opus 5.5: $0,40 (вход) + $0,40 (выход) = $0,80
Это пример расчета стоимости токенов, а не утверждение о том, что модели расходуют одинаковое количество токенов для выполнения одной и той же задачи.
Для более объективного сравнения рассчитайте стоимость получения одного успешного результата. Если одной модели требуется пять попыток, а другая справляется с первой, их итоговая стоимость может существенно отличаться от пропорции базовых цен.
Подписки также имеют собственные цены, лимиты и правила использования. Не сравнивайте цены API напрямую со стоимостью подписок, как если бы они были эквивалентны.
Какая ИИ-модель лучше всего подходит под ваши задачи?
Выбор подходящей модели зависит от рода вашей деятельности, частоты использования ИИ и критериев успешного результата.
Для разработчиков ПО
Попробуйте протестировать GPT-6 Astra и Claude Opus 5.5 на вашей реальной кодовой базе. Обе модели позиционируются для сложных инженерных задач, но их показатели будут зависеть от используемого языка, инструментов и сложности проекта.
Gemini 4 Argon также заслуживает внимания из-за высоких заявленных результатов в сфере разработки ПО, с оглядкой на доступность и независимую проверку.
Для исследователей и аналитиков
Отдавайте приоритет точности извлечения информации, надежности цитирования, работе с длинными документами и умению отличать факты от предположений.
Для работы с большими массивами файлов проверьте, способна ли модель находить нужные детали, не пропуская противоречивые данные.
Для создателей контента и маркетологов
Сравните, насколько хорошо каждая модель следует ТЗ, выдерживает единый стиль, структурирует информацию и создает черновики, требующие минимальной правки.
Практический процесс может включать подбор ключевых слов, составление плана, написание, фактчекинг и адаптацию текста под разные аудитории. Проверка человеком остается обязательной, особенно для фактов и SEO-контента.
Для бизнес-пользователей
Сосредоточьтесь на выполнении задач, анализе документов, работе со таблицами, составлении отчетов и надежности результатов.
Для регулярных задач даже небольшое сокращение времени ручной проверки может оказаться важнее, чем незначительное повышение баллов в бенчмарках.
Для пользователей с ограниченным бюджетом
Сравнивайте реальную стоимость выполнения ваших типовых задач, а не выбирайте модель только на основе заявленного интеллекта.
Если более доступная модель стабильно закрывает ваши потребности, она может стать лучшим выбором на каждый день. Оставьте более дорогие модели для задач, где их дополнительные возможности дадут ощутимый результат.
Как изучать модели ИИ и решать задачи на ChatGOAT AI
Сравнение моделей полезно, но настоящая выгода от ИИ появляется при его применении в вашей реальной работе.
ChatGOAT AI предоставляет рабочую среду для поддерживаемых моделей и инструментов, помогая пользователям осваивать написание текстов, исследования, анализ и творческие процессы с помощью ИИ, не превращая каждую задачу в отдельный эксперимент.
Если Gemini 4 Argon, GPT-6 Astra и Claude Opus 5.5 доступны в селекторе моделей ChatGOAT, пользователи могут изучить их ответы прямо на платформе и оценить, какой подход лучше отвечает их задачам. Доступность зависит от интеграций, поэтому сверяйтесь с актуальным списком перед началом работы.
Что можно делать с помощью ИИ на ChatGOAT AI?
Используйте ИИ для генерации идей, составления планов, написания постов, переформулирования абзацев, краткого изложения длинных материалов или адаптации контента под разную аудиторию.
Например, SEO-специалист может разработать план статьи, написать сравнительный обзор, подготовить ответы на частые вопросы и отредактировать текст для улучшения читаемости и соответствия поисковым запросам.
Анализ информации и документов
ИИ помогает выделять ключевые мысли из материалов, сравнивать отчеты, структурировать результаты исследований и превращать несистематизированные заметки в четкие резюме.
Например, бизнес-пользователь может трансформировать заметки со встречи в план действий, создать сравнительную таблицу и подготовить краткую справку для руководства.
Создание таблиц и планов проектов
Используйте ИИ для систематизации сравнений продуктов, составления списков задач, формирования исследовательских матриц и разработки планов проектов.
Маркетинговая команда может применить этот процесс для анализа функций конкурентов, распределения ключевых слов по посадочным страницам и составления контент-календаря.
Помощь в кодинге и решении задач
В поддерживаемых сценариях кодинга ИИ может объяснить незнакомый код, предложить шаги по отладке, написать функции и помочь в оформлении технической документации.
Всегда тестируйте сгенерированный код и проверяйте изменения перед их внедрением в рабочую среду.
ChatGOAT AI также предоставляет возможности генерации изображений с помощью поддерживаемых моделей. Это помогает создавать иллюстрации, визуальные концепты, графику для соцсетей и другие творческие материалы.
Генерация изображений — это отдельная функция, не связанная с текстовым рассуждением моделей. Не стоит полагать, что каждая модель из этого сравнения умеет напрямую создавать картинки только потому, что в рабочей среде есть графические инструменты.
Построение эффективного рабочего процесса
Вместо отправки разрозненных промптов пользователи могут разбить проект на этапы: исследование, планирование, черновик, проверка и финальная сдача.
Самый эффективный процесс — тот, который дает точный результат с меньшим количеством рутины, а не тот, где на каждом шаге задействована самая мощная модель.
Изучите ChatGOAT AI, чтобы узнать о поддерживаемых моделях и инструментах ИИ, доступных для ваших задач.
FAQ
Gemini 4 Argon лучше, чем GPT-6 Astra?
Не во всех ситуациях. Google заявила о высоких результатах Argon в отдельных инженерных и профессиональных бенчмарках, тогда как OpenAI публикует высокие показатели Astra в ряде сложных тестов. Ограничения доступа и различия в методологиях тестирования делают однозначные выводы преждевременными.
Claude Opus 5.5 лучше GPT-6 Astra в кодинге?
Обе модели спроектированы для сложных задач разработки ПО. Выбор зависит от кодовой базы, языка программирования, доступных инструментов и качества итоговой реализации. Сравнивайте процент прохождения тестов, риски регрессий, количество итераций и общую стоимость на одной и той же задаче.
Какая модель лучше подходит для сложных рассуждений?
GPT-6 Astra и Gemini 4 Argon позиционируются для сложных рассуждений и многоэтапных задач, тогда как Claude Opus 5.5 рассчитана на требовательные профессиональные и агентские процессы. Используйте специализированные тесты, чтобы определить, какая модель работает лучше для ваших потребностей.
Какая модель самая дешевая?
Исходя из приведенных выше стандартных тарифов API, наименьшая стоимость токенов у Gemini 4 Argon, за ней идут Claude Opus 5.5 и GPT-6 Astra. Однако ограниченный доступ к Argon не позволяет большинству пользователей воспользоваться этими ценами. Итоговая стоимость выполнения задачи также зависит от расхода токенов, повторов, кэширования и инструментов.
Можно ли использовать Gemini 4 Argon прямо сейчас?
Изначально Google анонсировала Argon для ограниченного круга специалистов по кибербезопасности в рамках программы Fairwind, а более широкий доступ запланирован на потом. Проверяйте свежие официальные анонсы Google перед планированием проектов на этой базе.
Можно ли сравнить эти модели на ChatGOAT AI?
Вы можете изучать модели и инструменты, поддерживаемые в актуальной рабочей среде ChatGOAT AI. Для прямого сравнения всех трех моделей убедитесь, что Gemini 4 Argon, GPT-6 Astra и Claude Opus 5.5 присутствуют в меню выбора. Если какая-то из них недоступна, сравните ее официальную документацию с точными результатами доступных моделей.
Какая модель лучше всего подходит для повседневной работы?
Универсального ответа нет. Учитывайте регулярные задачи, требуемую точность результатов, объем правки, бюджет и лимиты использования платформы. Тестирование на нескольких типовых задачах принесет больше пользы, чем выбор только по репутации.
Финальный вердикт: выбирайте модель, которая лучше всего справляется с вашей работой
Gemini 4 Argon, GPT-6 Astra и Claude Opus 5.5 демонстрируют разные подходы к продвинутым ИИ-помощникам. Argon заявляет о сильных сторонах в инжиниринге и профессиональных задачах, Astra ориентирована на сложные рассуждения и управление компьютером, а Opus 5.5 сосредоточена на кодинг-агентах и длительных рабочих процессах.
Лучшая модель — это не обязательно та, у которой самый высокий балл или самый дорогой API. Это модель, которая надежно выполняет ваши задачи, точно следует инструкциям, вписывается в бюджет и требует минимума лишних вмешательств.
Используйте официальные бенчмарки для сужения круга вариантов, обсуждения на Reddit — для понимания реальных вопросов пользователей, а практические тесты — для принятия окончательного решения.
В ChatGOAT AI вы можете работать с поддерживаемыми ИИ-моделями и инструментами для написания текстов, исследований, анализа и творчества в едином пространстве. Начните с реальной задачи, сравните качество результатов и выберите рабочий процесс, который сделает вашу работу проще.