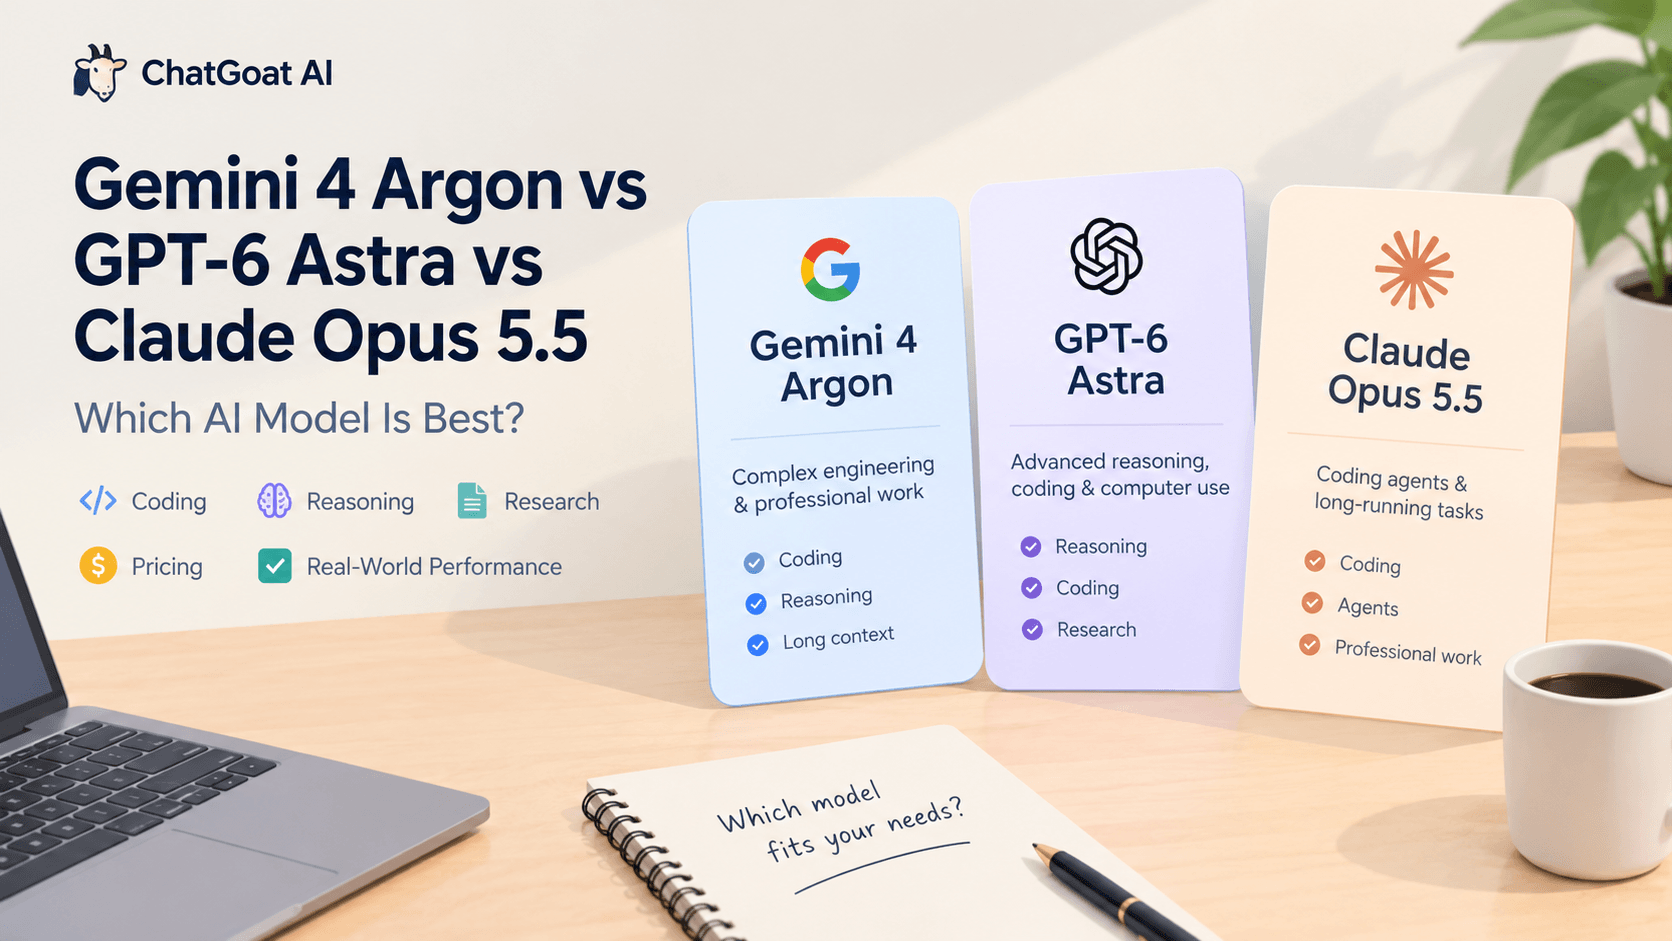
A competi ̄o entre Gemini 4 Argon, GPT-6 Astra e Claude Opus 5.5 destaca uma mudana importante na intelig↑ncia artificial. Os modelos l■deres de hoje j£ n ̄o s ̄o julgados apenas pelo qu ̄o bem respondem a perguntas. Desenvolvedores, pesquisadores e usu£rios do dia a dia tamb←m querem uma IA que possa resolver problemas complexos, entender grandes projetos, escrever cdigo confi£vel, analisar documentos e concluir tarefas de v£rias etapas com menos supervis ̄o.
Cada modelo tem um conjunto diferente de pontos fortes. O Google posiciona o Gemini 4 Argon em torno de engenharia complexa, trabalho de conhecimento profissional e defesa de cibersegurana. A OpenAI apresenta o GPT-6 Astra como um modelo para tarefas exigentes de racioc■nio, programa ̄o, pesquisa e uso de computador. A Anthropic enfatiza os recursos do Claude Opus 5.5 em engenharia de software, agentes de longa execu ̄o e trabalho profissional.
Mas qual modelo voc↑ deve escolher? O Gemini 4 Argon ← realmente melhor em programa ̄o? O GPT-6 Astra justifica seu preo de API mais alto? O Claude Opus 5.5 consegue concluir projetos complicados com menos instrues?
Esta compara ̄o examina resultados de benchmarks oficiais, preos, disponibilidade, casos de uso pr£ticos e discusses do Reddit. Ela tamb←m explica como avaliar esses modelos para o trabalho real e explorar fluxos de trabalho impulsionados por IA atrav←s do ChatGOAT AI.
Veredito R£pido: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
N ̄o h£ um nico vencedor para todas as tarefas. A melhor escolha depende do trabalho que voc↑ precisa concluir, do seu oramento e de voc↑ poder acessar o modelo atrav←s da sua plataforma preferida.
| Compara ̄o | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Posicionamento principal | Engenharia complexa e fluxos de trabalho profissionais | Racioc■nio avanado, programa ̄o, pesquisa e uso de computador | Agentes de programa ̄o e tarefas profissionais de longa execu ̄o |
| Programa ̄o | Resultados slidos em benchmarks selecionados de engenharia de software | Forte em tarefas t←cnicas e de programa ̄o com uso intensivo de racioc■nio | Projetado para programa ̄o complexa e fluxos de trabalho de agentes |
| Racioc■nio | Projetado para resolu ̄o de problemas complexos de v£rias etapas | Desenvolvido para racioc■nio exigente e trabalho profissional | Forte em instrues complexas e trabalho cont■nuo |
| Trabalho com contexto longo | Anunciados at← 1 milh ̄o de tokens de sa■da | Janela de contexto de 1,05 milh ̄o de tokens | Fluxos de trabalho de agentes de longa execu ̄o e grandes projetos |
| Preo padr ̄o de entrada da API | US$ 2 por milh ̄o de tokens | US$ 10 por milh ̄o de tokens | US$ 4 por milh ̄o de tokens |
| Preo padr ̄o de sa■da da API | US$ 10 por milh ̄o de tokens | US$ 50 por milh ̄o de tokens | US$ 20 por milh ̄o de tokens |
| Disponibilidade | Inicialmente restrito a defensores cibern←ticos de confiana | Dispon■vel atrav←s dos produtos suportados e da API da OpenAI | Dispon■vel atrav←s de plataformas suportadas do Claude e de desenvolvedores |
Fontes: Anncio do Gemini 4 Argon do Google, documenta ̄o do modelo GPT-6 Astra da OpenAI e documenta ̄o do Claude Opus da Anthropic.
Esses modelos n ̄o devem ser classificados usando apenas o preo ou um nico benchmark. Um modelo que custa menos por token pode precisar de mais tentativas para terminar uma tarefa, enquanto um modelo com uma pontua ̄o de benchmark impressionante pode n ̄o estar acess■vel ao usu£rio comum.
A conclus ̄o pr£tica: compare a qualidade do resultado final, o tempo necess£rio, o nmero de correes e o custo real de concluir sua tarefa.
Gemini 4 Argon: Constru■do para Engenharia Complexa e Trabalho de Conhecimento
O Google anunciou o Gemini 4 Argon em 30 de setembro de 2026, posicionando-o como um modelo de fronteira para engenharia de software do mundo real, trabalho de conhecimento empresarial e defesa de cibersegurana.
Ao contr£rio de um modelo projetado principalmente para conversas di£rias, o Argon ← apresentado como um sistema capaz de lidar com tarefas longas e interconectadas. Elas podem envolver a verifica ̄o de extensas informaes t←cnicas, identifica ̄o de problemas, planejamento de uma sequ↑ncia de aes e produ ̄o de um resultado final.
Principais pontos fortes
Engenharia de software complexa
O Argon demonstrou fortes resultados em benchmarks selecionados de engenharia de software. O anncio do Google enfatiza tarefas de engenharia de longo horizonte, nas quais um sistema de IA deve manter o contexto enquanto trabalha em um problema complicado.
Aplicaes potenciais incluem a revis ̄o de uma grande base de cdigo, identifica ̄o da origem de um bug, planejamento de uma migra ̄o e avalia ̄o se as alteraes propostas resolvem o problema original.
Pesquisa profissional e an£lise de documentos
O Google tamb←m destaca trabalhos de conhecimento empresarial na £rea jur■dica, financeira e outras. Isso torna as tarefas com uso intensivo de documentos uma £rea importante a ser avaliada, especialmente quando o modelo precisa conectar informaes em v£rios arquivos.
Por exemplo, um analista de negcios poderia usar um fluxo de trabalho de IA para resumir relatrios, extrair dados financeiros, comparar premissas e preparar um relatrio estruturado para revis ̄o humana.
Sa■da de formato longo
O Google anunciou um limite m£ximo de sa■da de at← um milh ̄o de tokens para o Argon. Essa ← uma concess ̄o de sa■da, n ̄o a mesma coisa que uma janela de contexto. A distin ̄o importa ao comparar modelos porque a quantidade de informaes que um modelo pode receber e a quantidade que ele pode gerar s ̄o capacidades diferentes.
Quais s ̄o as limitaes?
A maior limita ̄o pr£tica ← o acesso. No anncio, o Google estava disponibilizando o Argon para defensores cibern←ticos de confiana por meio de seu Programa Fairwind, com disponibilidade mais ampla planejada para uma etapa posterior.
Isso significa que os resultados publicados n ̄o devem ser automaticamente tratados como independentemente reproduz■veis por usu£rios comuns.
Uma pontua ̄o alta em benchmark tamb←m n ̄o estabelece que o Argon superar£ outros modelos em todas as linguagens de programa ̄o, tarefas de pesquisa ou projetos do mundo real.
Para mais contexto, consulte o anncio oficial do Gemini 4 Argon feito pelo Google.
GPT-6 Astra: Racioc■nio Avanado, Programa ̄o e Uso de Computador
A OpenAI descreve o GPT-6 Astra como seu modelo para tarefas profissionais exigentes, incluindo racioc■nio complexo, desenvolvimento de software, pesquisa, cria ̄o de documentos e uso de computador.
Seu valor n ̄o se limita a produzir uma boa resposta em uma nica intera ̄o. Para fluxos de trabalho adequados, o objetivo ← raciocinar sobre um problema, usar as ferramentas dispon■veis e trabalhar em dire ̄o a um resultado claramente definido.
Principais pontos fortes
Racioc■nio avanado
O GPT-6 Astra destina-se a problemas que exigem mais do que recuperar um fato ou gerar uma resposta curta. Ele pode ser avaliado em racioc■nio matem£tico, planejamento, questes t←cnicas complexas e tarefas que envolvem mltiplas restries.
Por exemplo, um gerente de produto pode pedir que ele compare estrat←gias de produtos concorrentes, identifique riscos, construa uma estrutura de decis ̄o e produza um plano de implementa ̄o.
Desenvolvimento e depura ̄o de software
O Astra pode ajudar desenvolvedores a gerar cdigo, inspecionar implementaes existentes, diagnosticar erros e trabalhar em tarefas de engenharia mais complicadas.
Testes teis incluem depurar um projeto desconhecido, modificar v£rios arquivos, gerar testes unit£rios e verificar se a implementa ̄o final atende aos requisitos.
Uso de computador e fluxos de trabalho de agentes
A OpenAI tamb←m documenta capacidades relacionadas ao uso de computador. No entanto, a automa ̄o real depende das ferramentas, permisses e salvaguardas fornecidas pelo ambiente em que o modelo ← executado.
A capacidade de um modelo de planejar uma tarefa n ̄o significa que toda interface de chat permita automaticamente navegar em sites, operar aplicativos ou executar cdigo.
Quais s ̄o as limitaes?
O GPT-6 Astra tem um preo de token de API padr ̄o mais alto do que os outros dois modelos nesta compara ̄o. Suas tarifas publicadas s ̄o de US$ 10 por milh ̄o de tokens de entrada e US$ 50 por milh ̄o de tokens de sa■da, antes de eventuais cobranas de cache, ferramentas e outras tarifas aplic£veis.
Para usu£rios que executam muitas conversas longas ou grandes fluxos de trabalho automatizados, os custos podem aumentar rapidamente.
Portanto, o modelo deve ser avaliado com base na qualidade do trabalho conclu■do, e n ̄o apenas em sua intelig↑ncia bruta. Se uma alternativa menos dispendiosa produzir resultados igualmente confi£veis para uma tarefa de rotina, pagar pelo modelo mais caro pode n ̄o ser necess£rio.
Leia mais na documenta ̄o do GPT-6 Astra da OpenAI.
Claude Opus 5.5: Agentes de Programa ̄o e Tarefas de Longa Execu ̄o
O Claude Opus 5.5 est£ posicionado para engenharia de software exigente, fluxos de trabalho de agentes de longa execu ̄o e trabalho profissional. Seu atrativo para muitos desenvolvedores ← a possibilidade de delegar uma tarefa complicada mantendo os requisitos originais durante todo o processo.
Isso ← particularmente importante quando um projeto envolve v£rios arquivos, mltiplas depend↑ncias ou uma longa sequ↑ncia de decises.
Principais pontos fortes
Compreens ̄o de base de cdigo
Um modelo de programa ̄o til deve entender como as diferentes partes de um projeto interagem. Ele deve ser capaz de identificar a causa de um bug, determinar quais arquivos precisam de alteraes e evitar introduzir regresses em outros locais.
O Claude Opus 5.5 ← um forte candidato para ser avaliado para esses fluxos de trabalho, especialmente quando a tarefa exige aten ̄o cont■nua ¢ estrutura e aos requisitos de um projeto.
Instrues complexas e escrita
Muitas tarefas profissionais envolvem instrues detalhadas que n ̄o podem ser reduzidas a uma nica pergunta. Um usu£rio pode especificar um pblico-alvo, tom, restries t←cnicas, regras de formata ̄o e uma lista de entreg£veis necess£rios.
O Claude pode ser avaliado pelo qu ̄o bem ele segue essas restries, mant←m a consist↑ncia e produz trabalhos que exigem edi ̄o m■nima.
Fluxos de trabalho de agentes de longa execu ̄o
Para equipes de desenvolvimento, um agente de IA pode precisar inspecionar um projeto, fazer alteraes, executar testes, interpretar erros e revisar sua implementa ̄o.
O nmero de etapas conclu■das com sucesso costuma ser mais significativo do que a qualidade da primeira resposta.
Quais s ̄o as limitaes?
Um modelo capaz ainda pode sobrecarregar uma tarefa, fazer suposies incorretas ou consumir franquias substanciais de uso durante uma sess ̄o longa.
Limites de acesso e regras de assinatura tamb←m s ̄o importantes. As discusses da comunidade frequentemente mencionam limites de uso, mesmo quando os usu£rios est ̄o satisfeitos com a qualidade do modelo.
As tarifas de API padr ̄o publicadas do Claude Opus 5.5 s ̄o de US$ 4 por milh ̄o de tokens de entrada e US$ 20 por milh ̄o de tokens de sa■da. Elas s ̄o mais baixas do que as tarifas padr ̄o do Astra, embora o custo real dependa de padres de uso, cache e servios adicionais.
Consulte a documenta ̄o oficial do Claude Opus da Anthropic para obter informaes atuais sobre produtos e preos.
O que os Benchmarks Realmente nos Dizem?
As pontuaes de benchmarks s ̄o teis para entender as capacidades dos modelos, mas n ̄o contam a histria toda.
Testes diferentes medem habilidades diferentes. Um modelo com bom desempenho em um benchmark longo de engenharia de software pode n ̄o ser a melhor escolha para pesquisa factual, escrita ou an£lise visual.
O anncio do Argon feito pelo Google e os resultados publicados da avalia ̄o do GPT-6 Astra fornecem v£rios pontos de compara ̄o teis.
Resultados de benchmarks de programa ̄o selecionados
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Aproximadamente 78% | 74,1% | Aproximadamente 74% |
| FrontierSWE v2 | Veja a avalia ̄o publicada pelo Google | Vantagem relatada nas comparaes dispon■veis | Veja a avalia ̄o publicada pelo Google |
| Terminal-Bench 4.0 | Veja a avalia ̄o publicada pelo Google | 57,9% nos resultados publicados da OpenAI | Resultados de avalia ̄o diferentes podem ser aplic£veis |
Fontes: anncio do Argon do Google, documenta ̄o do modelo Astra da OpenAI e a compara ̄o de outubro de 2026 entre o Argon e seus concorrentes.
Importante: estes nmeros devem ser tratados como resultados relatados, n ̄o como uma compara ̄o independente totalmente controlada. Os resultados podem variar de acordo com a vers ̄o do modelo, ambiente de teste, acesso a ferramentas, configuraes de racioc■nio e data de avalia ̄o. Onde as fontes originais n ̄o estabelecem um valor diretamente compar£vel, a tabela evita deliberadamente inventar um.
Os resultados dispon■veis tamb←m ilustram por que uma classifica ̄o universal ← enganosa. Foi relatado que o Argon lidera no DeepSWE v1.1, enquanto o Astra e o Opus podem ter um desempenho diferente em outras avaliaes de engenharia de software.
Uma abordagem melhor ← perguntar qual benchmark se assemelha ¢ sua carga de trabalho real.
- Para manuten ̄o de cdigo, priorize tarefas em repositrios reais e taxas de aprova ̄o nos testes.
- Para pesquisa, mea a precis ̄o factual e se as citaes sustentam as afirmaes.
- Para fluxos de trabalho de agentes, mea a conclus ̄o de ponta a ponta e a recupera ̄o de erros.
- Para escrita comercial, avalie a precis ̄o, o cumprimento de instrues e o tempo de edi ̄o.
O benchmark ← um ponto de partida. Sua prpria tarefa ← o teste final.
O que os Usu£rios do Reddit Est ̄o Dizendo Sobre Esses Modelos?
O Reddit fornece uma perspectiva diferente dos anncios oficiais. Os usu£rios discutem os aspectos do desempenho dos modelos que notam durante o trabalho di£rio, incluindo qualidade de cdigo, criatividade, velocidade, limites de uso e a quantidade de orienta ̄o de que o modelo precisa.
Essas discusses s ̄o evid↑ncias teis das prioridades dos usu£rios, mas s ̄o anedticas. Uma postagem n ̄o estabelece que um modelo seja objetivamente melhor para todos os usu£rios.
Gemini 4 Argon: Pontuaes impressionantes, mas o acesso continua sendo uma preocupa ̄o
Na discuss ̄o do r/singularity sobre os benchmarks do Gemini 4 Argon, os usu£rios discutiram os resultados relatados pelo Google em programa ̄o, cibersegurana e tarefas profissionais.
Uma pergunta recorrente foi se o desempenho do modelo se traduziria em benef■cios pr£ticos e quando uma disponibilidade mais ampla estaria acess■vel.
Isso cria uma distin ̄o til para um artigo comparativo: a liderana em benchmarks n ̄o ← o mesmo que a utilidade no dia a dia. Os usu£rios precisam de uma maneira de testar o modelo em suas prprias tarefas antes de decidir se vale a pena adot£-lo.
GPT-6 Astra vs Claude Opus 5.5: Qualidade, velocidade e limites de uso
A discuss ̄o no r/ClaudeAI comparando o Opus 5.5 com o GPT-6 Astra ilustra o qu ̄o rapidamente as prefer↑ncias da comunidade podem mudar entre os lanamentos de modelos.
Os participantes descreveram diferentes experi↑ncias com os modelos. Alguns preferiam o Astra, enquanto outros elogiavam as capacidades do Opus 5.5, mas criticavam a quantidade de orienta ̄o que ¢s vezes precisavam fornecer.
A li ̄o mais ampla ← que a qualidade do modelo depende em parte da tarefa e do fluxo de trabalho do usu£rio. Um modelo que funciona bem para um desenvolvedor pode ser menos adequado para os requisitos de outro projeto.
Os limites de uso s ̄o outra preocupa ̄o. Em uma discuss ̄o no Reddit sobre escolher entre o Opus 5.5 e o Astra, um usu£rio levantou dvidas sobre esgotar o limite de uso e se trocar de assinatura ofereceria melhor custo-benef■cio.
Para usu£rios frequentes, o custo do trabalho cont■nuo pode importar tanto quanto a qualidade das respostas individuais.
Uma tarefa criativa simples pode produzir resultados diferentes
Em uma compara ̄o no Reddit entre Opus 5.5, GPT-6 Astra e outros modelos, os usu£rios discutiram dar o mesmo comando a v£rios modelos para criar uma pequena anima ̄o de avi ̄o de papel.
As respostas refletiram prefer↑ncias diferentes: alguns usu£rios preferiram a qualidade da anima ̄o, enquanto outros preferiram a interpreta ̄o ou a dire ̄o criativa de outro modelo.
Esse ← um lembrete til de que as comparaes de modelos n ̄o se limitam a programa ̄o e racioc■nio. Para trabalhos criativos, a qualidade do resultado pode ser subjetiva, e o modelo mais apropriado depende do resultado que o usu£rio deseja.
O que podemos aprender com as discusses?
Em todas essas ramificaes de discuss ̄o, quatro temas se destacam:
- O desempenho no mundo real importa mais do que uma pontua ̄o de destaque. Os usu£rios querem modelos que resolvam seus problemas espec■ficos.
- O cumprimento de instrues afeta a produtividade. Um modelo forte ← mais til quando entende as restries sem a necessidade de esclarecimentos repetidos.
- Os limites de uso afetam a experi↑ncia geral. Resultados de alta qualidade s ̄o menos valiosos se os usu£rios n ̄o conseguirem manter seu fluxo de trabalho.
- Tarefas diferentes recompensam pontos fortes diferentes. Resultados criativos, programa ̄o, pesquisa e automa ̄o n ̄o devem ser avaliados usando os mesmos crit←rios.
Essas observaes devem orientar os testes neste artigo, em vez de substitu■-los.
Como Comparar os Tr↑s Modelos em Tarefas do Mundo Real
A compara ̄o mais til daria aos tr↑s modelos a mesma tarefa, os mesmos materiais de entrada e os mesmos crit←rios de avalia ̄o.
Se todos os tr↑s modelos estiverem dispon■veis para voc↑, os testes a seguir podem ajudar a determinar qual deles se adapta ao seu fluxo de trabalho.
Teste 1: Programa ̄o e depura ̄o
D↑ a cada modelo a mesma pequena base de cdigo contendo um bug reproduz■vel. Pea a ele para identificar o problema, implementar uma corre ̄o, escrever testes e explicar as alteraes.
Medida:
- Se o bug original foi corrigido
- Se os testes existentes ainda passam
- Se novos bugs foram introduzidos
- Quantos comandos de acompanhamento s ̄o necess£rios
- Tempo total e uso de tokens
Um modelo que produz uma explica ̄o plaus■vel, mas falha nos testes, n ̄o deve ser considerado o vencedor.
Teste 2: Pesquisa e an£lise de documentos
Fornea o mesmo conjunto de relatrios, tabelas e documentos de origem. Pea a cada modelo para resumir as evid↑ncias, extrair dados importantes, identificar contradies e preparar um relatrio curto com refer↑ncias.
Mea a precis ̄o factual, a qualidade das citaes, a cobertura de informaes importantes e a quantidade de corre ̄o manual necess£ria.
Este teste ← especialmente til para analistas, estudantes, consultores e equipes de contedo.
Teste 3: Execu ̄o de projetos em v£rias etapas
D↑ a cada modelo uma tarefa que exija v£rias entregas, como analisar uma ideia de produto, desenvolver um plano de projeto, criar uma tabela de tarefas e preparar um relatrio final.
Avalie se ele segue a sequ↑ncia necess£ria, mant←m a consist↑ncia entre os entreg£veis e verifica o resultado final.
Se o ambiente fornecer ferramentas, registre se o modelo as utiliza corretamente. Mantenha a intelig↑ncia do modelo separada das capacidades da plataforma que o executa.
Teste 4: Escrita e cumprimento de instrues
Fornea um briefing de escrita detalhado com pblico-alvo, tom, pontos necess£rios, tamanho e restries.
Compare os resultados em termos de precis ̄o factual, legibilidade, estrutura, originalidade e conformidade com o briefing.
Para equipes de marketing, isso pode revelar qual modelo produz rascunhos iniciais utiliz£veis e qual exige mais edi ̄o.
Use uma estrutura de pontua ̄o consistente
Uma avalia ̄o simples de 100 pontos pode facilitar a compara ̄o dos resultados.
| Crit←rio | Peso sugerido |
|---|---|
| Precis ̄o e exatid ̄o | 30 |
| Conclus ̄o da tarefa | 25 |
| Cumprimento de instrues | 15 |
| Qualidade da sa■da | 15 |
| Velocidade e efici↑ncia | 10 |
| Custo | 5 |
| Total | 100 |
Os pesos devem mudar de acordo com a tarefa. Por exemplo, testes de programa ̄o devem enfatizar o cdigo funcional e os testes bem-sucedidos, enquanto testes de pesquisa devem priorizar a precis ̄o factual e a qualidade das fontes.
N ̄o publique uma pontua ̄o como um teste independente a menos que voc↑ tenha realmente executado o experimento. Se o acesso ao Argon for restrito, use uma compara ̄o claramente rotulada de resultados publicados e reserve a se ̄o de teste independente para modelos que voc↑ possa genuinamente avaliar.
Compara ̄o de Preos: Qual Modelo Oferece Melhor Custo-Benef■cio?
As tarifas de API padr ̄o publicadas para esses modelos fornecem um ponto de partida til.
| Modelo | Entrada por 1M de tokens | Sa■da por 1M de tokens |
|---|---|---|
| Gemini 4 Argon | US$ 2 | US$ 10 |
| GPT-6 Astra | US$ 10 | US$ 50 |
| Claude Opus 5.5 | US$ 4 | US$ 20 |
Fontes: Google, OpenAI e Anthropic.
Nessas tarifas padr ̄o publicadas, o Argon tem o preo por token listado mais baixo, seguido pelo Opus 5.5 e pelo Astra. No entanto, isso n ̄o torna automaticamente o Argon a op ̄o pr£tica mais barata para todos os usu£rios, especialmente enquanto o acesso permanecer restrito.
Exemplo: Uma tarefa usando 100.000 tokens de entrada e 20.000 tokens de sa■da
Assumindo que as tarifas publicadas se aplicam, sem descontos de cache, tarifas de ferramentas ou outras cobranas:
- Gemini 4 Argon: US$ 0,20 de entrada + US$ 0,20 de sa■da = US$ 0,40
- GPT-6 Astra: US$ 1,00 de entrada + US$ 1,00 de sa■da = US$ 2,00
- Claude Opus 5.5: US$ 0,40 de entrada + US$ 0,40 de sa■da = US$ 0,80
Este ← um exemplo de custo por token, n ̄o uma afirma ̄o de que os modelos usam o mesmo nmero de tokens para terminar a mesma tarefa.
Para uma compara ̄o mais justa, calcule o custo de produzir um resultado bem-sucedido. Se um modelo precisa de cinco tentativas e outro conclui a tarefa em uma nica tentativa, seus custos efetivos podem diferir significativamente da propor ̄o padr ̄o do preo do token.
Os planos de assinatura tamb←m t↑m seus prprios preos, limites e regras de uso. N ̄o compare preos de API diretamente com taxas de assinatura como se fossem equivalentes.
Qual Modelo de IA ← o Melhor para Suas Necessidades?
O modelo certo depende do que voc↑ faz, da frequ↑ncia com que usa a IA e de como ← um resultado bem-sucedido.
Para desenvolvedores de software
Considere testar o GPT-6 Astra e o Claude Opus 5.5 em sua base de cdigo real. Ambos est ̄o posicionados para trabalhos de engenharia exigentes, mas seu desempenho relativo depender£ da sua linguagem, ferramentas e complexidade do projeto.
O Gemini 4 Argon tamb←m merece aten ̄o por seus resultados relatados em engenharia de software, sujeitos a acesso e verifica ̄o independente.
Para pesquisadores e analistas
Priorize a extra ̄o precisa de informaes, citaes confi£veis, manipula ̄o de documentos longos e a capacidade de distinguir fatos de suposies.
Para trabalhos que envolvem grandes colees de arquivos, teste se o modelo consegue encontrar detalhes relevantes sem ignorar evid↑ncias contraditrias.
Para criadores de contedo e profissionais de marketing
Compare o qu ̄o bem cada modelo segue um briefing de contedo, mant←m um tom consistente, organiza informaes e produz rascunhos que exigem edi ̄o m■nima.
Um fluxo de trabalho pr£tico pode incluir pesquisa de palavras-chave, estrutura ̄o, reda ̄o, verifica ̄o de fatos e adapta ̄o de contedo para diferentes pblicos. A revis ̄o humana continua sendo essencial, especialmente para afirmaes f£ticas e contedo de SEO.
Para usu£rios corporativos
Foque na conclus ̄o de tarefas, an£lise de documentos, fluxos de trabalho com planilhas, relatrios e confiabilidade dos resultados.
Para tarefas recorrentes, at← mesmo uma pequena redu ̄o no tempo de revis ̄o manual pode importar mais do que uma modesta melhoria nas pontuaes de benchmark.
Para usu£rios conscientes do oramento
Compare o custo real de concluir suas tarefas comuns em vez de selecionar um modelo com base apenas na intelig↑ncia anunciada.
Se um modelo menos caro atende consistentemente aos seus requisitos, ele pode ser a melhor op ̄o para o dia a dia. Reserve modelos mais caros para trabalhos nos quais suas capacidades adicionais faam uma diferena mensur£vel.
Como Explorar Modelos de IA e Concluir Tarefas no ChatGOAT AI
Comparar modelos ← til, mas o verdadeiro benef■cio da IA vem de aplic£-la ao seu prprio trabalho.
ChatGOAT AI fornece um espao de trabalho de IA para modelos e ferramentas suportados, ajudando os usu£rios a explorar fluxos de trabalho de escrita, pesquisa, an£lise e cria ̄o auxiliados por IA sem tratar cada tarefa como um experimento isolado.
Onde o Gemini 4 Argon, o GPT-6 Astra e o Claude Opus 5.5 estiverem habilitados no seletor de modelos atual do ChatGOAT, os usu£rios podem explorar suas respostas dentro da plataforma e avaliar qual abordagem funciona melhor para suas necessidades. A disponibilidade pode variar por modelo e integra ̄o, portanto, verifique a lista de modelos ativos antes de comear.
O que voc↑ pode fazer com IA no ChatGOAT AI?
Use a IA para fazer brainstorming de ideias de artigos, criar estruturas, redigir postagens de blog, reescrever par£grafos, resumir materiais extensos ou adaptar contedo para diferentes pblicos.
Por exemplo, um especialista em SEO pode desenvolver a estrutura de um blog, redigir um artigo comparativo, preparar respostas de FAQ e revisar o contedo para maior clareza e inten ̄o de busca.
Analisar informaes e documentos
A IA pode ajudar a extrair pontos-chave de materiais fornecidos, comparar relatrios, organizar descobertas de pesquisa e transformar notas n ̄o estruturadas em um resumo mais claro.
Por exemplo, um usu£rio corporativo pode transformar notas de reuni ̄o em um plano de a ̄o, criar uma tabela comparativa e preparar um resumo executivo conciso.
Criar tabelas estruturadas e planos de projeto
Use a IA para organizar comparaes de produtos, preparar listas de tarefas, construir matrizes de pesquisa e criar planos de projetos estruturados.
Uma equipe de marketing poderia usar esse fluxo de trabalho para comparar recursos de concorrentes, mapear palavras-chave para p£ginas de destino e organizar um calend£rio de contedo.
Suporte para programa ̄o e resolu ̄o de problemas
Para fluxos de trabalho de programa ̄o suportados, a IA pode explicar cdigo desconhecido, sugerir etapas de depura ̄o, redigir funes e ajudar a organizar a documenta ̄o t←cnica.
Sempre teste o cdigo gerado e revise as alteraes antes de us£-las em produ ̄o.
O ChatGOAT AI tamb←m oferece recursos de gera ̄o de imagens por IA por meio de suas ferramentas e modelos de imagem suportados. Eles podem ajudar os usu£rios a criar ilustraes, conceitos visuais, gr£ficos para redes sociais e outros recursos criativos.
A gera ̄o de imagens ← uma capacidade separada do racioc■nio de modelos de texto. N ̄o presuma que todos os modelos desta compara ̄o possam gerar imagens diretamente s porque o espao de trabalho inclui ferramentas de imagem.
Construir um fluxo de trabalho mais eficiente
Em vez de tratar cada tarefa como um comando isolado, os usu£rios podem dividir um projeto em etapas: pesquisa, planejamento, reda ̄o, verifica ̄o e entrega final.
O fluxo de trabalho mais til ← aquele que produz resultados precisos com menos trabalho repetitivo, n ̄o necessariamente aquele que usa o modelo mais avanado para cada etapa.
Explore o ChatGOAT AI para ver os modelos atualmente suportados e as ferramentas de IA dispon■veis para o seu fluxo de trabalho.
Perguntas Frequentes
O Gemini 4 Argon ← melhor do que o GPT-6 Astra?
N ̄o em todas as situaes. O Google relatou fortes resultados para o Argon em benchmarks selecionados de engenharia e trabalho profissional, enquanto a OpenAI publica fortes resultados para o Astra em v£rias avaliaes exigentes. Restries de acesso e diferenas nos m←todos de teste tornam prematura uma classifica ̄o universal.
O Claude Opus 5.5 ← melhor do que o GPT-6 Astra para programa ̄o?
Ambos foram projetados para tarefas exigentes de engenharia de software. A melhor op ̄o depende da base de cdigo, da linguagem de programa ̄o, das ferramentas dispon■veis e da qualidade da implementa ̄o final. Compare as taxas de aprova ̄o nos testes, os riscos de regress ̄o, a contagem de iteraes e o custo total na mesma tarefa.
Qual modelo ← o melhor para racioc■nio complexo?
O GPT-6 Astra e o Gemini 4 Argon est ̄o posicionados para racioc■nio complexo e trabalho de v£rias etapas, enquanto o Claude Opus 5.5 ← projetado para fluxos de trabalho profissionais e de agentes exigentes. Use testes espec■ficos por tarefa para determinar qual modelo apresenta o melhor desempenho para suas necessidades.
Qual modelo ← o mais barato?
Com base nas tarifas de API padr ̄o publicadas e listadas acima, o Gemini 4 Argon tem o menor preo por token, seguido pelo Claude Opus 5.5 e pelo GPT-6 Astra. No entanto, a disponibilidade restrita do Argon afeta se a maioria dos usu£rios pode realmente utilizar esses preos. O custo total da tarefa tamb←m depende do uso de tokens, reetapas, cache e ferramentas.
Posso usar o Gemini 4 Argon agora mesmo?
O Google anunciou inicialmente o Argon para defensores cibern←ticos de confiana por meio do Programa Fairwind, com um acesso mais amplo planejado. Verifique o anncio oficial mais recente do Google para alteraes na disponibilidade antes de contar com ele para um projeto.
Posso comparar esses modelos no ChatGOAT AI?
Voc↑ pode explorar modelos e ferramentas suportados pelo espao de trabalho atual do ChatGOAT AI. Para comparar os tr↑s diretamente, verifique se o Gemini 4 Argon, o GPT-6 Astra e o Claude Opus 5.5 est ̄o todos dispon■veis no seletor de modelos atual. Se algum n ̄o estiver dispon■vel, compare sua documenta ̄o publicada com os resultados pr£ticos de modelos acess■veis.
Qual modelo ← o melhor para o trabalho do dia a dia?
N ̄o h£ uma resposta universal. Considere as tarefas que voc↑ realiza com mais frequ↑ncia, o grau de precis ̄o necess£rio para os resultados, a quantidade de edi ̄o exigida, seu oramento e os limites de uso da sua plataforma preferida. Testar algumas tarefas representativas ← mais til do que escolher apenas pela reputa ̄o.
Veredito Final: Escolha o Modelo que Conclui Melhor o Seu Trabalho
Gemini 4 Argon, GPT-6 Astra e Claude Opus 5.5 representam abordagens diferentes para a assist↑ncia avanada de IA. O Argon possui pontos fortes relatados em avaliaes selecionadas de engenharia e trabalho profissional, o Astra foca em tarefas exigentes de racioc■nio e uso de computador, e o Opus 5.5 se concentra em agentes de programa ̄o e fluxos de trabalho profissionais de longa execu ̄o.
O melhor modelo n ̄o ← necessariamente aquele com a pontua ̄o mais alta ou a API mais cara. aquele que conclui suas tarefas de forma confi£vel, segue suas instrues, cabe no seu oramento e exige a menor interven ̄o desnecess£ria.
Use benchmarks oficiais para afunilar suas opes, discusses do Reddit para entender as dvidas de usu£rios reais e testes pr£ticos consistentes para tomar a decis ̄o final.
Com o ChatGOAT AI, voc↑ pode explorar modelos e ferramentas de IA suportados para escrita, pesquisa, an£lise e trabalho criativo em um nico espao de trabalho. Comece com uma tarefa que voc↑ realmente precisa concluir, compare a qualidade dos resultados e escolha o fluxo de trabalho que facilite o seu trabalho.