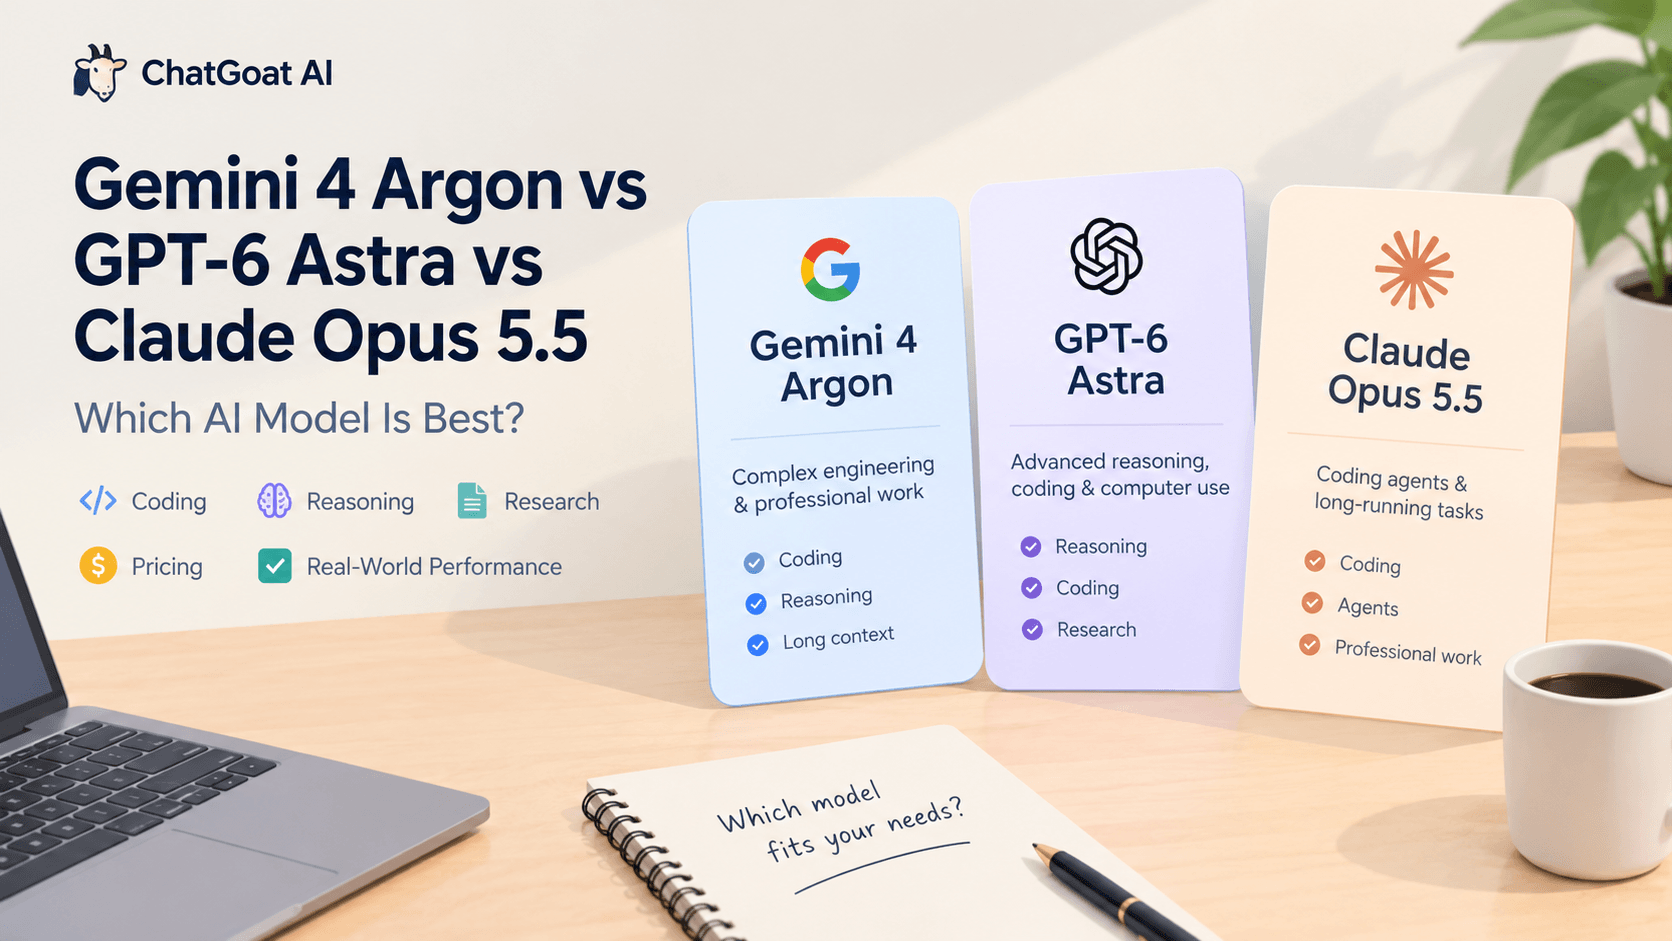
Gemini 4 Argon、GPT-6 Astra、そしてClaude Opus 5.5の間で繰り広げられる競争は、人工知能における重要な変化を浮き彫りにしています。今日の主要なモデルは、単に質問にどれだけ上手く答えられるかだけで評価されるものではなくなりました。開発者、研究者、そして一般のユーザーも、より少ない監視で複雑な問題を解決し、大規模なプロジェクトを理解し、信頼性の高いコードを書き、ドキュメントを分析し、マルチステップのタスクを完了できるAIを求めています。
各モデルにはそれぞれ異なる強みがあります。GoogleはGemini 4 Argonを複雑なエンジニアリング、専門的なナレッジワーク、サイバーセキュリティ防御に強みを持つモデルとして位置付けています。OpenAIはGPT-6 Astraを、高度な推論、コーディング、リサーチ、コンピューター使用タスクに対応するモデルとして提示しています。Anthropicは、ソフトウェアエンジニアリング、長時間の運用が可能なエージェント、専門業務におけるClaude Opus 5.5の機能を強調しています。
しかし、どのモデルを選ぶべきでしょうか? Gemini 4 Argonは実際にコーディングが得意なのでしょうか? GPT-6 Astraはその高いAPI価格に見合う価値があるのでしょうか? Claude Opus 5.5は少ない指示で複雑なプロジェクトを完了できるのでしょうか?
本比較記事では、公式のベンチマーク結果、価格設定、利用可能性、実践的なユースケース、ならびにRedditでの議論を検証します。また、実際の業務向けにこれらのモデルを評価し、ChatGOAT AIを通じてAI搭載のワークフローを活用する方法についても解説します。
迅速な判定:Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
すべてのタスクにおいて唯一絶対の勝者は存在しません。最適な選択肢は、完了する必要がある作業、予算、および好みのプラットフォーム経由でそのモデルにアクセスできるかどうかによって異なります。
| 比較項目 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| 主な位置付け | 複雑なエンジニアリングおよび専門的なワークフロー | 高度な推論、コーディング、リサーチ、コンピューター使用 | コーディングエージェントおよび長期的な専門タスク |
| コーディング | 一部のソフトウェアエンジニアリング・ベンチマークで強力な結果を記録 | 推論要素の強いコーディングや技術的タスク全般で強力 | 複雑なコーディングおよびエージェントのワークフロー向けに設計 |
| 推論力 | 複雑でマルチステップの問題解決向けに設計 | 要求水準の高い推論および専門業務向けに構築 | 複雑な指示への追従と持続的な作業に強み |
| 長文コンテキスト処理 | 最大100万出力トークンを発表 | 105万トークンのコンテキストウィンドウ | 長時間運用のエージェント・ワークフローおよび大規模プロジェクト |
| 標準API入力価格 | 100万トークンあたり2ドル | 100万トークンあたり10ドル | 100万トークンあたり4ドル |
| 標準API出力価格 | 100万トークンあたり10ドル | 100万トークンあたり50ドル | 100万トークンあたり20ドル |
| 利用可能性 | 当初は信頼できるサイバー防衛担当者に限定 | OpenAIの対応製品およびAPI経由で利用可能 | サポートされているClaudeおよび開発者プラットフォーム経由で利用可能 |
出典:GoogleのGemini 4 Argon発表、OpenAIのGPT-6 Astraモデルドキュメント、およびAnthropicのClaude Opusドキュメント。
これらのモデルを、価格や単一のベンチマークだけでランク付けすべきではありません。1トークンあたりのコストが低いモデルでもタスク完了までに何度も再試行が必要になる場合があり、素晴らしいベンチマークスコアを持つモデルが一般的なユーザーには利用できない場合もあります。
実践的なポイント: 最終結果の品質、所要時間、修正回数、およびタスク完了にかかる実際のコストを比較することです。
Gemini 4 Argon:複雑なエンジニアリングとナレッジワーク向けに設計
Googleは2026年9月30日にGemini 4 Argonを発表し、現実世界のソフトウェアエンジニアリング、企業向けナレッジワーク、サイバーセキュリティ防御のためのフロンティアモデルとして位置付けました。
主に日常会話向けに設計されたモデルとは異なり、Argonは相互に関連する長時間のタスクを処理できるシステムとして提示されています。これには、広範な技術情報の検証、問題の特定、一連のアクションの計画、勝つ最終結果の生成などが含まれます。
主な強み
複雑なソフトウェアエンジニアリング
Argonは、厳選されたソフトウェアエンジニアリングのベンチマークで強力な結果を示しています。Googleの発表では、複雑な問題を取り扱う際にAIシステムが文脈を維持し続けなければならない、長期的なエンジニアリングタスクが強調されています。
潜在的な応用例としては、大規模なコードベースのレビュー、バグの原因特定、移行の計画、提案された変更が元の問題を解決するかどうかの評価などが挙げられます。
専門的なリサーチとドキュメント分析
Googleは、法務、財務、その他の企業ナレッジワークも強調しています。これにより、特にモデルが複数のファイルにまたがって情報を関連付ける必要がある場合、ドキュメント主体のタスクが評価すべき重要な領域となります。
例えば、ビジネスアナリストはAIワークフローを使用して、レポートの要約、財務数値の抽出、前提条件の比較を行い、人間がレビューするための構造化されたブリーフィングを作成できます。
長文出力能力
GoogleはArgon向けに最大100万トークンの出力上限を発表しました。これは出力許容量であり、コンテキストウィンドウとは異なります。モデルが受信できる情報の量と生成できる情報の量は異なる機能であるため、モデルを比較する際にはこの違いが重要となります。
どのような制限がありますか?
最も大きな実践上の制限はアクセス権です。発表時点では、GoogleはFairwindプログラムを通じて信頼できるサイバーセキュリティ防衛担当者にArgonを展開しており、より広範な提供は後の段階で計画されています。
つまり、公表された結果を一般的なユーザーが独立して再現可能であると自動的にみなすべきではありません。
また、高いベンチマークスコアがあるからといって、Argonがすべてのプログラミング言語、リサーチタスク、あるいは現実世界のプロジェクトで他のモデルを凌駕することが確定するわけではありません。
詳細な背景については、GoogleによるGemini 4 Argonの公式発表をご覧ください。
GPT-6 Astra:高度な推論、コーディング、コンピューター使用
OpenAIはGPT-6 Astraを、複雑な推論、ソフトウェア開発、リサーチ、ドキュメント作成、コンピューター使用を含む、高度な要求の専門タスク向けモデルとして説明しています。
その価値は、一回のやり取りで良い回答を生成することだけに留まりません。適したワークフローにおいて、問題を推論し、利用可能なツールを活用し、明確に定義された結果に向かって作業を進めることが目的となります。
主な強み
高度な推論能力
GPT-6 Astraは、事実の検索や短い応答の生成以上のものを必要とする問題向けに設計されています。数学的推論、計画立案、複雑な技術的質問、および複数の制約が関わるタスクでその能力を評価できます。
例えば、プロダクトマネージャーは競合する製品戦略の比較、リスクの特定、意志決定フレームワークの構築、実行計画の作成を依頼することができます。
ソフトウェア開発とデバッグ
Astraは、開発者がコードを生成し、既存の実装を検証し、エラーを診断し、より複雑なエンジニアリングタスクを解決するのを支援します。
見慣れないプロジェクトのデバッグ、複数ファイルの修正、単体テストの生成、および最終的な実装が要件を満たしているかの検証などが有用なテストとなります。
コンピューター使用およびエージェントのワークフロー
OpenAIは、コンピューター使用に関連する機能についてもドキュメント化しています。ただし、実際の自動化は、モデルが実行される環境によって提供されるツール、権限、およびセーフガードに依存します。
モデルがタスクを計画できる能力があるからといって、すべてのチャットインターフェースで自動的にウェブサイトの閲覧、アプリケーションの操作、コードの実行が許可されるわけではありません。
どのような制限がありますか?
GPT-6 Astraは、本比較における他の2つのモデルよりも標準APIトークン価格が高く設定されています。公表されている料金は、適用されるキャッシュ、ツール、その他の料金が追加される前の段階で、入力トークン100万個あたり10ドル、出力トークン100万個あたり50ドルです。
長時間の会話を多数実行したり、大規模な自動ワークフローを運用したりするユーザーにとっては、コストが急速に膨らむ可能性があります。
したがって、このモデルは生の知能だけでなく、完了した作業の品質に基づいて評価されるべきです。ルーチンタスクに対してより安価な代替手段が同等に信頼性の高い結果を生み出す場合、高価なモデルに支払う必要はないかもしれません。
詳細についてはOpenAIのGPT-6 Astraドキュメントをお読みください。
Claude Opus 5.5:コーディングエージェントと長期タスク
Claude Opus 5.5は、高度なソフトウェアエンジニアリング、長期的なエージェント・ワークフロー、および専門業務を中心に位置付けられています。多くの開発者にとっての魅力は、プロセス全体を通じて元の要件を維持しながら複雑なタスクを委任できる可能性にあります。
これは、プロジェクトに複数のファイル、複数の依存関係、または一連の長い意思決定が含まれる場合に特に重要です。
主な強み
コードベースの理解力
有用なコーディングモデルは、プロジェクトのさまざまな部分がどのように相互作用するかを理解する必要があります。バグの原因を特定し、変更が必要なファイルを特定し、他の場所にデグレを引き起こさないようにできる必要があります。
Claude Opus 5.5は、特にタスクがプロジェクトの構造と要件に対する持続的な注意を必要とする場合、これらのワークフローに対して評価すべき有力な候補となります。
複雑な指示への対応とライティング
多くの専門的タスクには、単一の質問に要約できない詳細な指示が含まれます。ユーザーはターゲット層、トーン、技術的制約、フォーマットルール、必須の成果物リストを指定することがあります。
Claudeは、それらの制約にどれだけ正確に従い、一貫性を維持し、最小限の編集で済むような成果物を生成できるかで評価できます。
長期運用のエージェント・ワークフロー
開発チームにおいて、AIエージェントはプロジェクトを検査し、変更を加え、テストを実行し、エラーを解釈し、実装を修正する必要がある場合があります。
最初に返ってくる応答の質よりも、正常に完了したステップの数のほうが意味を持つことがよくあります。
どのような制限がありますか?
優秀なモデルであっても、タスクを極端に複雑化させたり、不正確な前提を置いたり、長いセッション中に大量の使用枠を消費してしまうことがあります。
アクセス制限やサブスクリプションのルールも重要です。コミュニティの議論では、モデルの品質に満足している場合でも、使用制限について頻繁に言及されています。
Claude Opus 5.5の公表されている標準API料金は、入力トークン100万個あたり4ドル、出力トークン100万個あたり20ドルです。実際のコストは使用パターン、キャッシュ、追加サービスによって異なりますが、これらはAstraの標準料金よりも低くなっています。
現在の製品および価格情報については、Anthropicの公式Claude Opusドキュメントをご覧ください。
ベンチマークは実際に何を物語っているのか?
ベンチマークスコアはモデルの機能を理解するのに役立ちますが、すべてを物語っているわけではありません。
テストによって測定するスキルは異なります。長期的なソフトウェアエンジニアリングのベンチマークで優れているモデルが、事実に基づくリサーチ、ライティング、あるいは視覚分析において最善の選択肢であるとは限りません。
GoogleによるArgonの発表と、公表されているGPT-6 Astraの評価結果は、いくつかの有用な比較ポイントを提供しています。
主なコーディングベンチマーク結果
| ベンチマーク | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | 約78% | 74.1% | 約74% |
| FrontierSWE v2 | Google公表の評価を参照 | 利用可能な比較において優位性が報告されている | Google公表の評価を参照 |
| Terminal-Bench 4.0 | Google公表の評価を参照 | OpenAI公表の結果で57.9% | 異なる評価結果が適用される場合がある |
出典:GoogleのArgon発表、OpenAIのAstraモデルドキュメント、および2026年10月のArgonと同他社モデルの比較。
重要: これらの数値は報告された結果として扱われるべきであり、完全に管理された独立した比較として扱われるべきではありません。結果はモデルのバージョン、テストハーネス、ツールへのアクセス、推論設定、および評価日によって異なる場合があります。元の情報源が直接比較可能な数値を設定していない場合、表では意図的に数値の捏造を避けています。
利用可能な結果は、なぜ一律のランキングが誤解を招くのかも示しています。ArgonはDeepSWE v1.1で首位に立っていると報告されていますが、AstraとOpusは他のソフトウェアエンジニアリング評価において異なるパフォーマンスを示す可能性があります。
より適切なアプローチは、どのベンチマークが実際の業務負荷に類似しているかを問いかけることです。
- コードの保守については、実際のリポジトリタスクとテスト合格率を優先します。
- リサーチについては、事実の正確性と引用が主張を裏付けているかを測定します。
- エージェントのワークフローについては、エンドツーエンドの完了率とエラーからのリカバリ能力を測定します。
- ビジネスライティングについては、正確性、指示への従順さ、および編集にかかる時間を評価します。
ベンチマークは出発点に過ぎません。あなた自身のタスクこそが最終テストです。
Redditユーザーはこれらのモデルについて何と言っているか?
Redditは、公式発表とは異なる視点を提供してくれます。ユーザーはコードの品質、創造性、速度、利用制限、モデルが必要とする指導の量など、日々の作業の中で気付くモデルのパフォーマンスについて議論しています。
これらの議論はユーザーの優先事項を示す有用な証拠となりますが、あくまで逸話的なものです。ある投稿によって、1つのモデルがすべてのユーザーにとって客観的に優れていると証明されるわけではありません。
Gemini 4 Argon:印象的なスコアの一方、アクセス権が依然として課題
r/singularityにおけるGemini 4 Argonベンチマークの議論では、コーディング、サイバーセキュリティ、および専門タスク全般にわたるGoogleの報告結果について議論されました。
繰り返し提起された疑問の1つは、モデルのパフォーマンスが実際の利点につながるかどうか、そしてより広範なアクセスがいつ利用可能になるかということでした。
これは比較記事における有用な視点となります。つまり、ベンチマークでの首位獲得は日々の有用性と同義ではないということです。ユーザーは採用価値があるかどうかを判断する前に、自身のタスクでモデルをテストする方法を必要としています。
GPT-6 Astra vs Claude Opus 5.5:品質、速度、探して利用制限
Opus 5.5とGPT-6 Astraを比較するr/ClaudeAIの議論は、モデルのリリース間にコミュニティの好みがどれほど迅速に変わり得るかを示しています。
参加者は各モデルでの異なる体験を語りました。Astraを好む人もいれば、Opus 5.5の機能を称賛しつつも時折提供する必要のある指示の多さを批判する人もいました。
より大きな教訓は、モデルの品質がタスクやユーザーのワークフローに一部依存するということです。ある開発者にとって機能するモデルが、別のプロジェクトの要件には適さない場合もあります。
使用制限ももう1つの懸念事項です。Opus 5.5とAstraの選択に関するRedditの議論において、あるユーザーは使用量の枯渇や、サブスクリプションを切り替える方がコストパフォーマンスが良いのではないかという疑問を投げかけました。
ヘビーユーザーにとって、継続的な作業にかかるコストは個々の応答の品質と同じくらい重要になることがあります。
シンプルなクリエイティブタスクでも異なる結果をもたらす可能性がある
Opus 5.5、GPT-6 Astra、その他のモデルを比較するRedditのスレッドにおいて、ユーザーは複数のモデルに同じプロンプトを与えて短い紙飛行機のアニメーションを作成させたことについて議論しました。
回答にはさまざまな好みが反映されました。一部のユーザーはアニメーションの品質を好み、他のユーザーは別のモデルの解釈やクリエイティブな方向性を好みました。
これは、モデルの比較がコーディングや推論だけに留まらないことを思い出させてくれる良い例です。クリエイティブな作業において出力品質は主観的であり、最も適切なモデルはユーザーが求める結果によって異なります。
これらの議論から何を学べるか?
これらのスレッド全体を通して、4つのテーマが際立っています。
- 見出しのスコアよりも実社会でのパフォーマンスが重要です。ユーザーは自分たちの特定の問題を解決するモデルを求めています。
- 指示への従順さが生産性を左右します。優れたモデルは、繰り返し確認することなく制約を理解できる場合に、より役立ちます。
- 利用制限が体験全体に影響を与えます。ユーザーがワークフローを維持できない場合、高品質な結果であっても価値は低くなります。
- タスクが異なれば報われる強みも異なります。クリエイティブな出力、コーディング、リサーチ、自動化を同じ基準で評価すべきではありません。
これらの観察結果は、本記事のテストを置き換えるものではなく、テストに反映されるべきものです。
実際のタスクで3つのモデルを比較する方法
最も有用な比較は、3つすべてのモデルに同じタスク、同じ入力素材、および同じ評価基準を与えることです。
3つのモデルすべてが利用可能な場合、以下のテストを行うことで、どれが自分のワークフローに適しているかを判断できます。
テスト1:コーディングとデバッグ
再現可能なバグが含まれる同じ小規模なコードベースを各モデルに与えます。問題の特定、修正の実装、テストの記述、および変更点の説明を依頼します。
評価項目:
- 元のバグが修正されたか
- 既存のテストが依然として合格するか
- 新たなバグが混入していないか
- 追加のプロンプトが何回必要だったか
- 総所要時間とトークン使用量
もっともらしい説明を出力してもテストに失敗するモデルは、勝者とみなすべきではありません。
テスト2:リサーチとドキュメント分析
同じ一連のレポート、表、ソースドキュメントを提供します。各モデルに根拠の要約、重要な数値の抽出、矛盾の特定、および参照元を含む短いレポートの作成を依頼します。
事実の正確性、引用の品質、重要な情報のカバー率、および必要な手動修正の量を測定します。
このテストは、アナリスト、学生、コンサルタント、コンテンツチームに特に役立ちます。
テスト3:マルチステッププロジェクトの実行
製品アイデアの分析、プロジェクト計画の策定、タスク表の作成、最終レポートの準備など、複数の成果物を必要とするタスクを各モデルに与えます。
要求された手順に従っているか、成果物間の一貫性を維持しているか、最終結果を検証しているかを評価します。
環境がツールを提供している場合は、モデルがそれらを正しく使用しているかを記録します。モデルの知能と、それを実行するプラットフォームの機能を区別して評価してください。
テスト4:ライティングと指示への追従
ターゲット層、トーン、必須項目、文章量、制限事項を含む詳細なライティング指示書を提供します。
事実の正確さ、読みやすさ、構造、オリジナル性、および指示書への準拠度について結果を比較します。
マーケティングチームにとって、これはどのモデルが実用的な初稿を作成し、どのモデルがより多くの編集を必要とするかを明らかにするのに役立ちます。
一貫したスコアリングフレームワークを使用する
シンプルな100点満点の評価を使用すると、結果を容易に比較できるようになります。
| 評価項目 | 推奨配点 |
|---|---|
| 正確性と適正さ | 30 |
| タスク完了率 | 25 |
| 指示への従順さ | 15 |
| 出力の品質 | 15 |
| 速度と効率 | 10 |
| コスト | 5 |
| 合計 | 100 |
配点はタスクに応じて変更する必要があります。例えば、コーディングテストでは動作するコードとテスト合格に重点を置き、リサーチテストでは事実の正確性と情報源の品質を優先すべきです。
実際に実験を行っていない限り、独立したテストとしてスコアを公開しないでください。Argonへのアクセスが制限されている場合は、明確にラベル付けされた公表結果の比較を使用し、独立テストのセクションは実際に評価できるモデルのために残しておいてください。
価格比較:どのモデルがより高い価値を提供するか?
これらのモデル向けに公表されている標準API料金は、有用な出発点となります。
| モデル | 100万トークンあたりの入力 | 100万トークンあたりの出力 |
|---|---|---|
| Gemini 4 Argon | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
出典:Google、OpenAI、およびAnthropic。
公表されている標準料金において、Argonは記載されているトークン価格が最も低く、Opus 5.5、Astraがこれに続きます。ただし、特にアクセスが制限されている間は、これが自動的にArgonをすべてのユーザーにとって最も安価で実践的な選択肢にするわけではありません。
例:入力100,000トークンおよび出力20,000トークンを使用するタスク
キャッシュ割引、ツール手数料、その他の料金がなく、公表料金が適用されると仮定した場合:
- Gemini 4 Argon: 入力$0.20 + 出力$0.20 = $0.40
- GPT-6 Astra: 入力$1.00 + 出力$1.00 = $2.00
- Claude Opus 5.5: 入力$0.40 + 出力$0.40 = $0.80
これはトークンコストの例であり、各モデルが同じタスクを完了するために同じ数のトークンを使用すると主張するものではありません。
より公平に比較するには、1つの成功した結果を生み出すためのコストを計算します。1つのモデルが5回の再試行を必要とし、別のモデルが1回の試行でタスクを完了する場合、実質的なコストは標準のトークン価格比率とは大きく異なる可能性があります。
サブスクリプションプランにも独自の価格設定、制限、利用規約があります。API価格とサブスクリプション料金をあたかも同等であるかのように直接比較しないでください。
ニーズに最適なAIモデルはどれか?
最適なモデルは、行う作業、AIを使用する頻度、および成功した結果がどのようなものであるかによって異なります。
ソフトウェア開発者の場合
実際のコードベースでGPT-6 AstraとClaude Opus 5.5をテストすることを検討してください。両者とも要求水準の高いエンジニアリング作業向けに位置付けられていますが、相対的なパフォーマンスは言語、ツール、およびプロジェクトの複雑さによって異なります。
Gemini 4 Argonも、アクセス権と独立した検証を条件として、報告されているソフトウェアエンジニアリングの結果に注目する価値があります。
研究者やアナリストの場合
正確な情報抽出、信頼できる引用、長文ドキュメントの処理、および事実と推測を区別する能力を優先します。
大量のファイル群を扱う作業では、矛盾する証拠を見落とすことなく、モデルが関連する詳細を見つけられるかをテストします。
コンテンツクリエイターやマーケターの場合
各モデルがコンテンツの指示書にどれだけ従い、一貫したトーンを維持し、情報を整理し、最小限の編集で済む下書きを作成できるかを比較します。
実践的なワークフローには、キーワード調査、構成案作成、下書き、ファクトチェック、異なるターゲット層向けへのコンテンツの調整が含まれる場合があります。特に事実に基づく主張やSEOコンテンツについては、人間のレビューが引き続き不可欠です。
ビジネスユーザーの場合
タスクの完了、ドキュメント分析、スプレッドシートのワークフロー、報告、および出力の信頼性に焦点を当てます。
繰り返されるタスクについては、手動でのレビュー時間がわずかに削減されるだけでも、ベンチマークスコアの緩やかな向上以上に重要となる場合があります。
予算を重視するユーザーの場合
宣伝されている知能だけでモデルを選択するのではなく、一般的なタスクを完了するための実際のコストを比較してください。
より安価なモデルが要件を一貫して満たしている場合、それが日常的な選択肢としてより優れている可能性があります。より高価なモデルは、その追加機能が測定可能な違いを生み出す作業のためにとっておきましょう。
ChatGOAT AIでAIモデルを試してタスクを完了する方法
モデルを比較することは有用ですが、AIの本当の利点はそれを独自の作業に適用することから得られます。
ChatGOAT AIはサポートされているモデルとツールのためのAIワークスペースを提供し、すべてのタスクを別々の実験として扱うことなく、ユーザーがAI支援によるライティング、リサーチ、分析、クリエイティブなワークフローを試せるよう支援します。
現在のChatGOATモデルセレクターでGemini 4 Argon、GPT-6 Astra、Claude Opus 5.5が有効になっている場合、ユーザーはプラットフォーム内でそれらの応答を確認し、どの手法が自身のニーズに最も適しているかを評価できます。提供状況はモデルや統合によって異なる場合があるため、開始前に最新のモデルリストをご確認ください。
ChatGOAT AIのAIで何ができますか?
AIを使用して、記事のアイデアのブレーンストーミング、アウトラインの作成、ブログ投稿の下書き、段落の書き換え、長文資料の要約、異なるターゲット層向けへのコンテンツの調整を行います。
例えば、SEOスペシャリストはブログのアウトラインを作成し、比較記事を下書きし、FAQの回答を準備し、明瞭さと検索意図に合わせてコンテンツを修正できます。
情報とドキュメントの分析
AIは提供された資料から要点を抽出し、レポートを比較し、調査結果を整理し、構造化されていないメモをより明確な要約に変換するのに役立ちます。
例えば、ビジネスユーザーは会議のメモをアクションプランに変換し、比較表を作成し、簡潔なエグゼクティブサマリーを作成できます。
構造化された表とプロジェクト計画の作成
AIを使用して製品比較を整理し、タスクリストを作成し、リサーチマトリックスを構築し、構造化されたプロジェクト計画を作成します。
マーケティングチームはこのワークフローを使用して、競合他社の機能を比較し、ランディングページにキーワードをマッピングし、コンテンツカレンダーを整理できます。
コーディングと問題解決のサポート
サポートされているコーディングワークフローでは、AIは見慣れないコードの解説、デバッグ手順の提案、関数の下書き、技術ドキュメントの整理をサポートできます。
生成されたコードは必ずテストし、本番環境で使用する前に変更点を確認してください。
ChatGOAT AIは、サポートされている画像ツールやモデルを通じてAI画像生成機能も提供しています。これによりユーザーはイラスト、ビジュアルコンセプト、SNSグラフィック、その他のクリエイティブアセットを作成できます。
画像生成はテキストモデルの推論とは別の機能です。ワークスペースに画像ツールが含まれているからといって、本比較のすべてのモデルが画像を直接生成できると判断しないでください。
より効率的なワークフローの構築
すべてのタスクを単一のプロンプトとして扱うのではなく、ユーザーはプロジェクトをリサーチ、計画、下書き、チェック、最終納品といったステップに分解できます。
最も有用なワークフローとは、すべてのステップで最も高度なモデルを使用するものではなく、少ない反復作業で正確な結果を生み出すワークフローです。
ワークフローで利用可能な、現在サポートされているモデルおよびAIツールを確認するには、ChatGOAT AIをご覧ください。
FAQ(よくある質問)
Gemini 4 ArgonはGPT-6 Astraよりも優れていますか?
すべての状況で優れているわけではありません。Googleは一部のエンジニアリングおよび専門業務のベンチマークでArgonの強力な結果を報告していますが、OpenAIは複数の高度な評価でAstraの強力な結果を公表しています。アクセス制限やテスト方法の違いにより、一律のランキング付けを行うのは時期尚早です。
コーディングにおいてClaude Opus 5.5はGPT-6 Astraよりも優れていますか?
両者とも高度なソフトウェアエンジニアリングタスク向けに設計されています。どちらが適しているかは、コードベース、プログラミング言語、利用可能なツール、および最終的な実装の品質によって異なります。同一のタスクにおいて、テストの合格率、デグレのリスク、反復回数、および総コストを比較してください。
複雑な推論に最も適しているモデルはどれですか?
GPT-6 AstraとGemini 4 Argonはともに複雑な推論とマルチステップの作業向けに位置付けられており、Claude Opus 5.5は要求水準の高い専門業務およびエージェントのワークフロー向けに設計されています。タスク固有のテストを実施して、ニーズに最も合ったモデルを特定してください。
最も安価なモデルはどれですか?
上記に挙げた公表されている標準API料金に基づくと、Gemini 4 Argonが最も低いトークン価格となっており、Claude Opus 5.5、GPT-6 Astraがそれに続きます。ただし、Argonの利用制限により、大部分のユーザーが実際にその価格を利用できるかどうかが影響を受けます。また、タスクの総コストはトークン使用量、再試行回数、キャッシュ、およびツールにも依存します。
Gemini 4 Argonは今すぐ利用できますか?
Googleは当初、Fairwindプログラムを通じて信頼できるサイバーセキュリティ防衛担当者向けにArgonを発表し、より広範なアクセスを計画していました。プロジェクトで活用する前に、利用可能性の変更についてGoogleの最新の公式発表をご確認ください。
ChatGOAT AIでこれらのモデルを比較することはできますか?
現在のChatGOAT AIワークスペースでサポートされているモデルとツールを試すことができます。3つすべてを直接比較するには、Gemini 4 Argon、GPT-6 Astra、Claude Opus 5.5が現在のモデルセレクターでそれぞれ利用可能であることを確認してください。いずれかが利用できない場合は、公表されているドキュメントと利用可能なモデルでの実践結果を比較してください。
日常の作業に最も適しているモデルはどれですか?
万人に共通する答えはありません。最も頻繁に行うタスク、必要な結果の正確さ、必要な編集量、予算、および利用するプラットフォームの使用制限を考慮してください。評判だけで選択するよりも、いくつかの代表的なタスクをテストするほうが役立ちます。
最終判定:あなたの作業を最も良く完了させるモデルを選ぼう
Gemini 4 Argon、GPT-6 Astra、Claude Opus 5.5は、高度なAIアシスタンスに対する異なるアプローチを表現しています。Argonは厳選されたエンジニアリングおよび専門業務の評価において強みが報告されており、Astraは要求の高い推論とコンピューター使用タスクを対象とし、Opus 5.5はコーディングエージェントおよび長期運用の専門ワークフローに焦点を当てています。
最良のモデルとは、必ずしも最も高いスコアを持つモデルや最も高価なAPIであるとは限りません。自らのタスクを確実に行い、指示に従い、予算に収まり、不必要な介入を最小限に抑えられるモデルこそが最良のモデルです。
公式ベンチマークを使用して選択肢を絞り込み、Redditでの議論を通じて実際のユーザーが抱いている疑問を理解し、一貫した実践テストを行って最終決定を下してください。
ChatGOAT AIを使用すると、ライティング、リサーチ、分析、クリエイティブワークのためのサポートされているAIモデルとツールを1つのワークスペースで試すことができます。実際に完了する必要のあるタスクから始め、結果の品質を比較し、作業をより容易にするワークフローを選択してください。