Punti chiave
- Kimi K3.1 Pro offre una finestra di contesto da 1 milione di token ed │ progettato per la programmazione, la creazione 3D, la ricerca finanziaria e le attivit¢ di agenti a lungo termine.
- La sua API costa 2 $ per milione di token in input e 10 $ per milione di token in output, con l'input memorizzato nella cache disponibile a uno sconto del 90%.
- Kimi ottiene un punteggio del 65,7% su Terminal-Bench 4.0, vicino al 66,4% di Claude Opus 5.5 e davanti al 58,2% di GPT-6 Astra.
- Kimi │ in vantaggio in diversi benchmark finanziari e a lungo contesto, tra cui SWE-Marathon v1.1 e OfficeQA Pro v2.
- GPT-6 Astra offre prestazioni decisamente superiori in Terminal-Bench Science 0.1, il che suggerisce una maggiore efficacia nei flussi di lavoro scientifici e per agenti di ricerca.
- Il prezzo inferiore dei token di Kimi non si traduce sempre in una spesa finale pi bassa, poich← le attivit¢ basate su agenti possono consumare molti token di output.
- ChatGOAT AI consente agli utenti di accedere a Kimi K3.1 Pro insieme a Claude Opus 5.5, GPT-6 Astra, Gemini, Grok, DeepSeek e altri modelli in un'unica interfaccia.
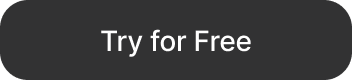
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra: quale modello di intelligenza artificiale dovresti usare?
Scegliere un modello di IA non significa pi semplicemente selezionare quello "pi intelligente". Il modello migliore dipende da cosa si sta sviluppando: un agente di programmazione, un assistente per la ricerca finanziaria, un prototipo 3D, un flusso di lavoro di ricerca o un'applicazione di produzione sensibile ai costi.
Questo confronto analizza Kimi K3.1 Pro, Claude Opus 5.5 e GPT-6 Astra utilizzando attivit¢ reali, risultati di benchmark, prezzi e punti di forza pratici.
Cos'│ Kimi K3.1 Pro?
Kimi K3.1 Pro │ il primo modello della serie K3.1 di Moonshot AI e il modello pi potente dell'azienda fino ad oggi. Si tratta di un modello da 3 mila miliardi di parametri con una finestra di contesto di 1 milione di token, che lo rende adatto a grandi basi di codice, report estesi, attivit¢ di agenti multi-step e progetti di ricerca complessi.
Moonshot posiziona K3.1 Pro attorno a quattro miglioramenti principali:
- Programmazione
- Creazione 3D
- Ricerca finanziaria
- Funzionalit¢ di agenti a lungo termine
Supporta inoltre strumenti come Unity, Unreal, Godot e Three.js, il che lo rende interessante per gli sviluppatori che creano giochi, siti Web interattivi ed esperienze 3D.
Prezzi di Kimi K3.1 Pro
| Piano / Accesso | Prezzo | Note |
|---|---|---|
| Input API | 2 $ per milione di token | Inferiore al precedente prezzo di input di Kimi K3 di 3 $. |
| Output API | 10 $ per milione di token | Inferiore al precedente prezzo di output di Kimi K3 di 15 $. |
| Input memorizzato nella cache | Circa 0,20 $ per milione di token | Basato su uno sconto del 90% sulla cache. |
| Versione ad alta velocit¢ | Circa il doppio del prezzo standard | Offre un output circa 2-3 volte pi veloce a parit¢ di intelligenza. |
Il prezzo di listino basso │ allettante, ma │ importante monitorare l'effettivo utilizzo dei token. In un test di Artificial Analysis, Kimi ha consumato circa 150 milioni di token di output, superando la mediana di 87 milioni, il che pu aumentare il costo totale delle attivit¢ di agenti lunghi.
Benchmark di Kimi K3.1 Pro
Kimi K3.1 Pro offre prestazioni particolarmente elevate negli agenti di codifica, nell'ingegneria del software a lungo termine, nella ricerca sul Web e nell'analisi di documenti finanziari. Tuttavia, non │ il modello migliore per ogni attivit¢.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Cosa significa |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | 66,4% | 58,2% | Kimi │ quasi alla pari con Claude nel lavoro di agenti di codifica da terminale. |
| SWE-Marathon v1.1 | 51,7% | 46,3% | 42,5% | Kimi │ leader nell'ingegneria del software a lungo termine. |
| HLE-Full con strumenti | 70,0% | 67,7% | 57,2% | Kimi offre prestazioni elevate nel difficile ragionamento basato sulla conoscenza con strumenti. |
| BrowseComp | 92,1% | 90,8% | 91,5% | Tutti e tre sono forti nella ricerca sul Web. |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | Kimi │ indicato per l'analisi di documenti finanziari e per ufficio. |
| Terminal-Bench Science 0.1 | 38,1 | 63,3 | 68,1 | GPT-6 Astra │ leader nei flussi di lavoro da terminale orientati alla scienza. |
La lezione principale │ semplice: Kimi non │ semplicemente un "Claude pi economico". altamente competitivo nella programmazione basata su agenti e nel lavoro incentrato sui documenti, ma GPT-6 Astra potrebbe essere l'opzione migliore per i flussi di lavoro di ricerca scientifica.
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra
1. Risoluzione di bug in una base di codice reale
Attivit¢: Fornire a ciascun modello lo stesso repository contenente diversi bug nascosti. Chiedere di individuare il problema, scrivere una correzione, aggiungere test e spiegare la modifica.
Cosa misurare:
- Se individua la causa principale
- Numero di tentativi
- Se i test vengono superati
- Qualit¢ del codice
- Token totali e costo
Risultato previsto: Kimi offre buone prestazioni nei benchmark di ingegneria a lungo termine, ma test indipendenti su repository reali suggeriscono che potrebbe non essere sempre in testa nella correzione di bug legacy. Un test di terze parti ha rilevato che Kimi ha ottenuto un punteggio di 36 in una valutazione di correzione di bug nel mondo reale, al di sotto del 41,7 di Claude Opus 5.5.
Scelta migliore: Claude Opus 5.5 per il debug di codice legacy complesso; Kimi K3.1 Pro per refactoring pi ampi e sviluppo guidato da agenti.
2. Trasformazione di un PRD in un'applicazione Web funzionante
Attivit¢: Fornire un documento di requisiti di prodotto (PRD) e chiedere a ciascun modello di creare un'applicazione Web funzionante, inclusi frontend, backend, schema del database e istruzioni di distribuzione.
Cosa misurare:
- Completezza delle funzionalit¢
- Organizzazione del codice
- Qualit¢ dell'interfaccia utente (UI)
- Gestione di una modifica dei requisiti a met¢ progetto
- Se l'applicazione viene eseguita senza riparazioni manuali
Risultato previsto: Kimi │ progettato per la programmazione tramite agenti e supporta flussi di lavoro orientati al frontend e al 3D, ma valutazioni indipendenti suggeriscono che potrebbe ancora essere inferiore ad alcuni modelli di punta occidentali in termini di rifinitura visiva, animazione e creazione di siti Web.
Scelta migliore: Kimi per prototipi ingegneristici rapidi; Claude o GPT-6 Astra se la qualit¢ visiva e la progettazione iterativa sono la priorit¢.
3. Analisi di un report finanziario esteso
Attivit¢: Caricare un rapporto annuale di 300 pagine, un report di settore e un foglio di calcolo. Chiedere al modello di estrarre metriche finanziarie, identificare i rischi, elaborare una previsione a tre anni e citare i numeri di pagina per ogni affermazione.
Cosa misurare:
- Accuratezza dei numeri estratti
- Qualit¢ delle citazioni
- Capacit¢ di collegare i dati tra documenti diversi
- Qualit¢ del modello finanziario
- Tasso di allucinazione
Risultato previsto: Questo │ uno dei casi d'uso pi forti di Kimi. Ha ottenuto un punteggio di 64,4 su OfficeQA Pro v2, superando Claude Opus 5.5 a 62,2 e GPT-6 Astra a 54,4.
Scelta migliore: Kimi K3.1 Pro per documenti finanziari lunghi, analisi di fogli di calcolo e lavoro aziendale ad alta intensit¢ di ricerca.
4. Creazione di un prototipo 3D
Attivit¢: Chiedere a ciascun modello di creare una scena interattiva in Three.js, un minigioco in Godot o un prototipo in Unity a partire da un breve briefing.
Cosa misurare:
- Qualit¢ degli asset
- Completezza dell'interazione
- Utilizzo degli strumenti
- Rifinitura visiva
- Capacit¢ di apportare modifiche in seguito al feedback
Risultato previsto: Kimi │ forte in questa categoria perch← Moonshot ha specificamente migliorato la creazione 3D e l'integrazione degli strumenti. Tuttavia, non │ automaticamente il modello creativo migliore; test indipendenti hanno evidenziato lacune in alcune attivit¢ di generazione 3D e di siti Web.
Scelta migliore: Kimi per prototipi giocabili rapidi; Claude o GPT-6 Astra per un output creativo di maggiore qualit¢, a seconda dei risultati dei vostri test.
5. Ricerca online in pi fasi
Attivit¢: Chiedere a ciascun modello di effettuare ricerche su un mercato, identificare 10 aziende importanti, verificare le affermazioni e produrre un rapporto con le relative fonti.
Cosa misurare:
- Qualit¢ delle fonti
- Accuratezza fattuale
- Capacit¢ di evitare la ripetizione
- Profondit¢ dell'analisi
- Affidabilit¢ delle citazioni
Risultato previsto: Kimi ha ottenuto un punteggio del 92,1% su BrowseComp, leggermente davanti a Claude Opus 5.5 e GPT-6 Astra. Ci suggerisce una notevole efficacia nel recupero di informazioni basate sul Web.
Scelta migliore: Kimi per la ricerca web generale; GPT-6 Astra per la ricerca scientifica e le indagini tecniche.
6. Test di costo e velocit¢
Attivit¢: Eseguire lo stesso flusso di lavoro per agenti in 10 passaggi su ciascun modello e confrontare il costo totale, la latenza, i token di output, i tentativi e la qualit¢ finale.
| Metrica | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Prezzo input API | 2 $ / milione di token | Superiore | Varia a seconda del provider e del piano. |
| Prezzo output API | 10 $ / milione di token | Superiore | Varia a seconda del provider e del piano. |
| Costo attivit¢ Artificial Analysis | 2,11 $ | 5,98 $ | 3,26 $ |
| Utilizzo token di output | Elevato in alcuni test con agenti | Inferiore nel test citato | Moderato nel test citato |
| Ideale per | Contesto lungo, agenti di programmazione, finanza | Ingegneria del software complessa | Ricerca e agenti scientifici |
Il prezzo inferiore di Kimi │ reale, ma la fattura finale dipende da quanti token utilizza il modello. Per i prompt ripetitivi, la memorizzazione nella cache pu fare una differenza notevole.
Quale modello dovresti scegliere?
| Caso d'uso | Modello migliore | Perch← |
|---|---|---|
| Documenti finanziari lunghi | Kimi K3.1 Pro | Ottime prestazioni in OfficeQA e contesto di 1M di token. |
| Programmazione basata su agenti | Kimi K3.1 Pro o Claude Opus 5.5 | Kimi │ in vantaggio in alcuni test di programmazione a lungo termine; Claude rimane eccellente nella programmazione da terminale. |
| Risoluzione di bug legacy | Claude Opus 5.5 | Pi efficace in alcuni test indipendenti di correzione di bug su repository reali. |
| Agenti di ricerca scientifica | GPT-6 Astra | Guida Terminal-Bench Science 0.1 con un ampio margine. |
| App API sensibili ai costi | Kimi K3.1 Pro | Prezzi di input/output di listino inferiori e forte valore di benchmark. |
| Prototipi 3D e di giochi | Kimi K3.1 Pro | Progettato per la creazione 3D e strumenti come Unity, Unreal, Godot e Three.js. |
| Ricerca web generale | Kimi K3.1 Pro | Leggermente in vantaggio su BrowseComp. |
Come testare questi modelli in autonomia
Non affidarti solo ai grafici dei benchmark. Esegui lo stesso prompt su ciascun modello e valuta i risultati.
Usa questo semplice framework di test:
- Scegli un'attivit¢ che svolgi realmente ogni settimana.
- Scrivi un prompt dettagliato con deliverable chiari.
- Esegui il test su Kimi K3.1 Pro, Claude Opus 5.5 e GPT-6 Astra.
- Registra la qualit¢ di completamento, le modifiche necessarie, la latenza e l'utilizzo dei token.
- Ripeti il test tre volte.
- Calcola il costo per risultato utilizzabile, non solo il costo per milione di token.
Questo approccio aiuta a evitare l'errore pi comune: scegliere un modello perch← vince un benchmark piuttosto che perch← offre le prestazioni migliori nel proprio flusso di lavoro.
Prova Kimi K3.1 Pro su ChatGOAT AI
Non servono account separati o chiavi API per confrontare questi modelli. ChatGOAT AI │ una piattaforma IA all-in-one che offre accesso a molteplici modelli leader, tra cui Kimi K3.1 Pro, Claude Opus 5.5, GPT-6 Astra, Gemini 4 Carbon, Grok 4.7 e DeepSeek, in un'unica area di lavoro.
Con ChatGOAT AI puoi:
- Chattare con Kimi K3.1 Pro direttamente nel tuo browser.
- Confrontare Kimi con Claude Opus 5.5 e GPT-6 Astra utilizzando lo stesso prompt.
- Utilizzare l'IA per programmazione, ricerca, scrittura, fogli di calcolo, presentazioni, immagini e attivit¢ di agenti multi-step.
- Cambiare modello senza dover ricostruire il tuo flusso di lavoro o gestire pi abbonamenti.
Ad esempio, se stai analizzando un rapporto finanziario, puoi chiedere a Kimi K3.1 Pro di estrarre le metriche e costruire un modello, quindi chiedere a Claude Opus 5.5 di rivedere la logica o a GPT-6 Astra di effettuare ricerche sui rischi di mercato. Questo flusso di lavoro di "cambio di modello" │ spesso pi utile rispetto all'impegno vincolante con un unico fornitore di IA.
Domande frequenti (FAQ)
Kimi K3.1 Pro │ migliore di Claude Opus 5.5?
Dipende dall'attivit¢. Kimi │ in vantaggio in alcuni benchmark di programmazione a lungo termine, analisi finanziaria e recupero dati, mentre Claude Opus 5.5 rimane leggermente in vantaggio in Terminal-Bench 4.0 e potrebbe essere pi efficiente per determinate attivit¢ di debug nel mondo reale.
Kimi K3.1 Pro │ migliore di GPT-6 Astra?
Per la programmazione a contesto lungo, i documenti finanziari e la ricerca web generale, Kimi │ altamente competitivo. Per i flussi di lavoro da terminale scientifico, GPT-6 Astra gode di un netto vantaggio in base ai risultati di Terminal-Bench Science 0.1.
Quanto costa Kimi K3.1 Pro?
Kimi K3.1 Pro costa 2 $ per milione di token in input e 10 $ per milione di token in output tramite l'API. L'input memorizzato nella cache │ disponibile a circa 0,20 $ per milione di token.
Kimi K3.1 Pro ha davvero un contesto di 1 milione di token?
S↓. Moonshot dichiara che K3.1 Pro supporta una finestra di contesto di 1 milione di token, utile per grandi basi di codice, report estesi e analisi di pi documenti.
Posso usare Kimi K3.1 Pro per la programmazione?
S↓. La programmazione │ uno dei suoi punti di forza principali, in particolare la programmazione basata su agenti, l'ingegneria del software a lungo termine e le attivit¢ di sviluppo basate su terminale.
Posso usare Kimi K3.1 Pro su ChatGOAT AI?
S↓. ChatGOAT AI include Kimi K3.1 Pro tra i modelli disponibili, insieme a Claude Opus 5.5, GPT-6 Astra, Gemini, Grok e DeepSeek.
Qual │ il modello migliore per i principianti?
Per i principianti, │ consigliabile iniziare con ChatGOAT AI poich← consente di provare pi modelli in un unico posto. Usa Kimi per documenti lunghi e programmazione, Claude per un'attenta ingegneria del software e GPT-6 Astra per attivit¢ ad alta intensit¢ di ricerca.
Dovrei scegliere Kimi perch← │ pi economico?
Non sempre. Kimi ha un prezzo dei token inferiore, ma le attivit¢ degli agenti possono generare molti token di output. Testa l'intero flusso di lavoro e confronta il costo finale, non solo la tariffa pubblicata.