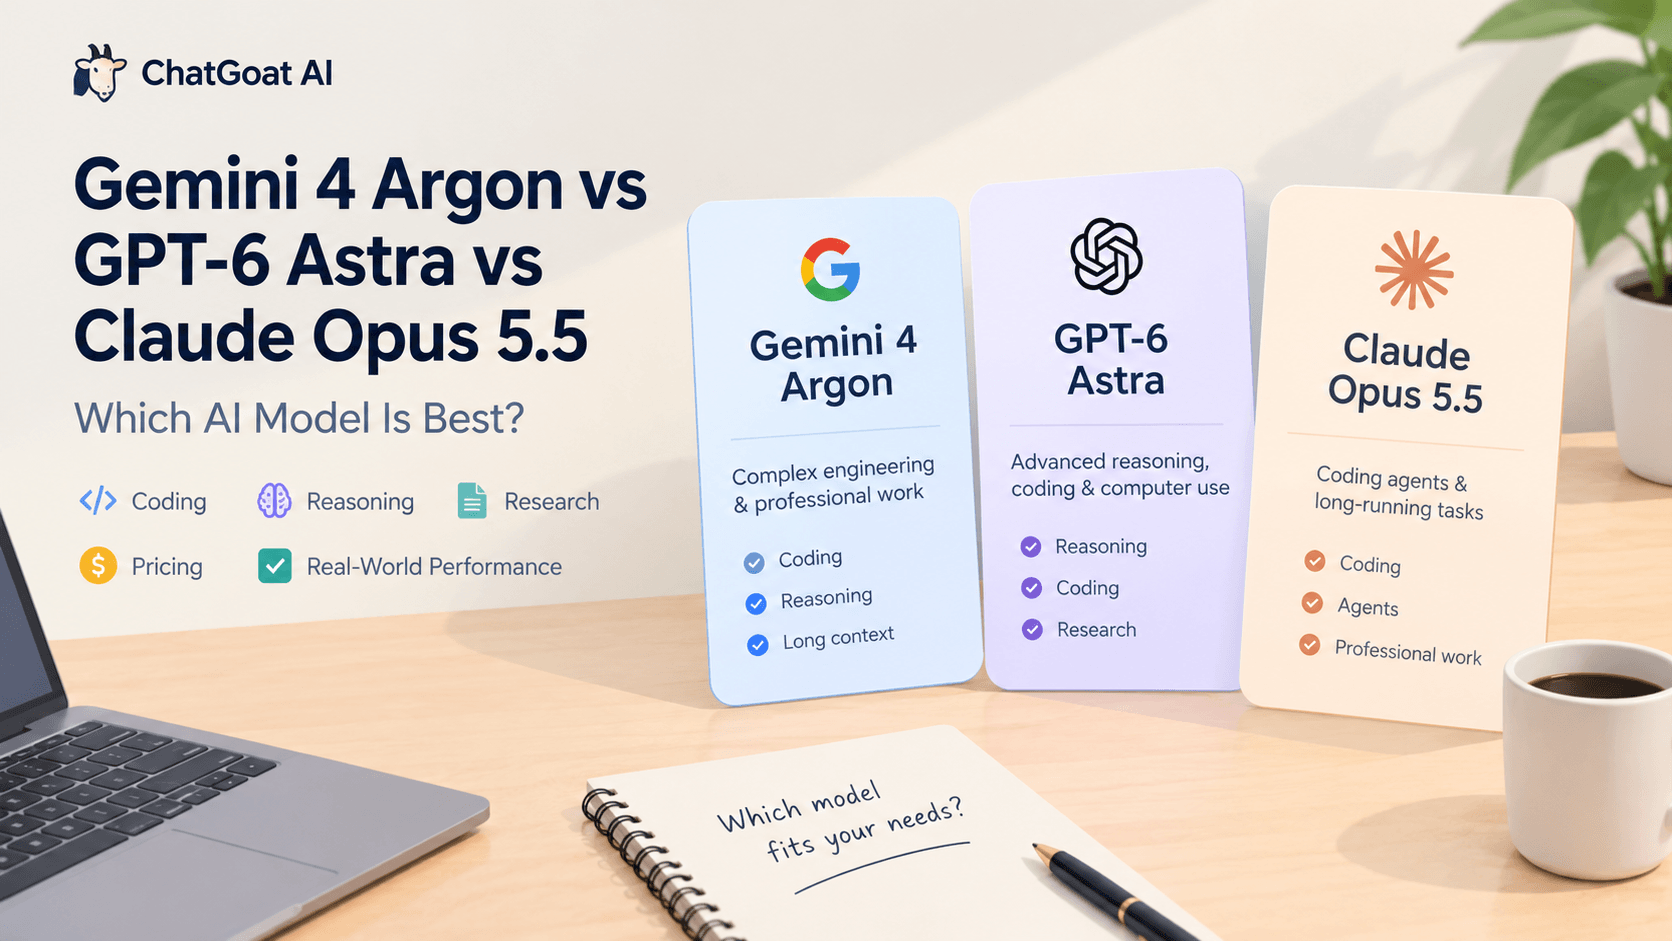
La competizione tra Gemini 4 Argon, GPT-6 Astra e Claude Opus 5.5 evidenzia un importante cambiamento nell'intelligenza artificiale. I modelli leader di oggi non vengono pi giudicati solo da quanto bene rispondono alle domande. Sviluppatori, ricercatori e utenti comuni desiderano anche un'IA in grado di risolvere problemi complessi, comprendere grandi progetti, scrivere codice affidabile, analizzare documenti e completare attivit¢ multi-step con meno supervisione.
Ogni modello possiede un insieme diverso di punti di forza. Google posiziona Gemini 4 Argon attorno all'ingegneria complessa, al lavoro intellettuale professionale e alla difesa della sicurezza informatica. OpenAI presenta GPT-6 Astra come un modello per compiti impegnativi di ragionamento, programmazione, ricerca e utilizzo del computer. Anthropic sottolinea le capacit¢ di Claude Opus 5.5 nell'ingegneria del software, negli agenti a lungo termine e nel lavoro professionale.
Ma quale modello dovresti scegliere? Gemini 4 Argon │ effettivamente migliore nella programmazione? GPT-6 Astra giustifica il suo prezzo API pi elevato? Claude Opus 5.5 pu completare progetti complicati con meno istruzioni?
Questo confronto esamina i risultati ufficiali dei benchmark, i prezzi, la disponibilit¢, i casi d'uso pratici e le discussioni da Reddit. Spiega anche come valutare questi modelli per il lavoro reale ed esplorare i flussi di lavoro basati sull'IA tramite ChatGOAT AI.
Verdetto rapido: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
Non esiste un unico vincitore per ogni compito. La scelta migliore dipende dal lavoro che devi completare, dal tuo budget e dalla possibilit¢ di accedere al modello tramite la tua piattaforma preferita.
| Confronto | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Posizionamento principale | Ingegneria complessa e flussi di lavoro professionali | Ragionamento avanzato, programmazione, ricerca e utilizzo del computer | Agenti di programmazione e compiti professionali a lungo termine |
| Programmazione | Risultati eccellenti su benchmark selezionati di ingegneria del software | Forte nei compiti tecnici e di programmazione ad alto tasso di ragionamento | Progettato per la programmazione complessa e flussi di lavoro di agenti |
| Ragionamento | Progettato per la risoluzione di problemi complessi e multi-step | Sviluppato per ragionamenti impegnativi e lavoro professionale | Forte con istruzioni complesse e lavoro prolungato |
| Lavoro su contesti lunghi | Annunciati fino a 1 milione di token in uscita | Finestra di contesto da 1,05 milioni di token | Flussi di lavoro di agenti a lungo termine e grandi progetti |
| Prezzo standard API in ingresso | $2 per milione di token | $10 per milione di token | $4 per milione di token |
| Prezzo standard API in uscita | $10 per milione di token | $50 per milione di token | $20 per milione di token |
| Disponibilit¢ | Inizialmente limitato a difensori informatici fidati | Disponibile tramite i prodotti supportati e le API di OpenAI | Disponibile tramite le piattaforme supportate di Claude e per sviluppatori |
Fonti: annuncio di Gemini 4 Argon da parte di Google, documentazione del modello GPT-6 Astra di OpenAI e documentazione di Claude Opus di Anthropic.
Questi modelli non dovrebbero essere classificati utilizzando solo il prezzo o un singolo benchmark. Un modello che costa meno per token potrebbe richiedere pi tentativi per completare un compito, mentre un modello con un punteggio di benchmark impressionante potrebbe non essere accessibile all'utente medio.
La conclusione pratica: confronta la qualit¢ del risultato finale, il tempo richiesto, il numero di correzioni e il costo effettivo per completare il tuo compito.
Gemini 4 Argon: progettato per l'ingegneria complessa e il lavoro intellettuale
Google ha annunciato Gemini 4 Argon il 30 settembre 2026, posizionandolo come un modello di punta per l'ingegneria del software nel mondo reale, il lavoro intellettuale aziendale e la difesa della sicurezza informatica.
A differenza di un modello progettato principalmente per le conversazioni quotidiane, Argon viene presentato come un sistema in grado di gestire compiti lunghi e interconnessi. Questi possono comportare l'esame di estese informazioni tecniche, l'identificazione di problemi, la pianificazione di una sequenza di azioni e la produzione di un risultato finale.
Punti di forza chiave
Ingegneria del software complessa
Argon ha mostrato risultati eccellenti su benchmark selezionati di ingegneria del software. L'annuncio di Google sottolinea i compiti ingegneristici ad ampio raggio, in cui un sistema di IA deve mantenere il contesto mentre lavora su un problema complicato.
Le applicazioni potenziali includono la revisione di un ampio codebase, l'identificazione della fonte di un bug, la pianificazione di una migrazione e la valutazione se le modifiche proposte risolvono il problema originale.
Ricerca professionale e analisi di documenti
Google evidenzia anche il lavoro intellettuale legale, finanziario e aziendale. Ci rende i compiti ricchi di documenti un'area importante da valutare, in particolare quando il modello deve collegare informazioni tra diversi file.
Ad esempio, un analista aziendale potrebbe utilizzare un flusso di lavoro basato sull'IA per sintetizzare report, estrarre cifre finanziarie, confrontare ipotesi e preparare un briefing strutturato per la revisione umana.
Output di testo lungo
Google ha annunciato un limite massimo di output fino a un milione di token per Argon. Si tratta di una quota di output, non della stessa cosa di una finestra di contesto. La distinzione │ importante quando si confrontano i modelli, perch← la quantit¢ di informazioni che un modello pu ricevere e la quantit¢ che pu generare sono capacit¢ diverse.
Quali sono le limitazioni?
La pi grande limitazione pratica │ l'accesso. Al momento dell'annuncio, Google stava distribuendo Argon a difensori informatici fidati tramite il suo programma Fairwind, con una disponibilit¢ pi ampia pianificata per una fase successiva.
Ci significa che i risultati pubblicati non dovrebbero essere automaticamente considerati come indipendentemente riproducibili dagli utenti comuni.
Un punteggio di benchmark elevato non stabilisce nemmeno che Argon superer¢ altri modelli in ogni linguaggio di programmazione, compito di ricerca o progetto del mondo reale.
Per ulteriori informazioni, consulta l'annuncio ufficiale di Google su Gemini 4 Argon.
GPT-6 Astra: ragionamento avanzato, programmazione e utilizzo del computer
OpenAI descrive GPT-6 Astra come il suo modello per compiti professionali impegnativi, tra cui ragionamento complesso, sviluppo software, ricerca, creazione di documenti e utilizzo del computer.
Il suo valore non si limita a produrre una buona risposta in un singolo scambio. Per flussi di lavoro idonei, l'obiettivo │ ragionare su un problema, utilizzare gli strumenti disponibili e lavorare verso un risultato chiaramente definito.
Punti di forza chiave
Ragionamento avanzato
GPT-6 Astra │ destinato a problemi che richiedono qualcosa in pi del semplice recupero di un fatto o della generazione di una breve risposta. Pu essere valutato su ragionamento matematico, pianificazione, domande tecniche complesse e compiti che comportano vincoli multipli.
Ad esempio, un product manager potrebbe chiedergli di confrontare strategie di prodotto concorrenti, identificare rischi, costruire un quadro decisionale e produrre un piano di implementazione.
Sviluppo software e debugging
Astra pu aiutare gli sviluppatori a generare codice, ispezionare implementazioni esistenti, diagnosticare errori e svolgere compiti di ingegneria pi complicati.
I test utili includono il debugging di un progetto sconosciuto, la modifica di pi file, la generazione di test unitari e la verifica che l'implementazione finale soddisfi i requisiti.
Utilizzo del computer e flussi di lavoro di agenti
OpenAI documenta anche le capacit¢ relative all'utilizzo del computer. Tuttavia, l'automazione effettiva dipende dagli strumenti, dalle autorizzazioni e dalle protezioni fornite dall'ambiente in cui viene eseguito il modello.
La capacit¢ di un modello di pianificare un compito non significa che ogni interfaccia di chat gli consenta automaticamente di navigare nei siti web, azionare applicazioni o eseguire codice.
Quali sono le limitazioni?
GPT-6 Astra presenta un prezzo dei token API standard pi elevato rispetto agli altri due modelli in questo confronto. Le sue tariffe pubblicate sono di $10 per milione di token in ingresso e $50 per milione di token in uscita, prima delle addebiti applicabili per caching, strumenti e altro.
Per gli utenti che eseguono molte conversazioni lunghe o grandi flussi di lavoro automatizzati, i costi possono accumularsi rapidamente.
Il modello dovrebbe quindi essere valutato sulla qualit¢ del lavoro completato, non solo sulla sua intelligenza grezza. Se un'alternativa meno costosa produce risultati altrettanto affidabili per un compito di routine, pagare per il modello pi costoso potrebbe non essere necessario.
Leggi di pi nella documentazione su GPT-6 Astra di OpenAI.
Claude Opus 5.5: agenti di programmazione e compiti a lungo termine
Claude Opus 5.5 si posiziona attorno all'ingegneria del software impegnativa, ai flussi di lavoro di agenti a lungo termine e al lavoro professionale. Il suo fascino per molti sviluppatori risiede nella possibilit¢ di delegare un compito complicato mantenendo i requisiti originali durante tutto il processo.
Ci │ particolarmente importante quando un progetto coinvolge diversi file, dipendenze multiple o una lunga sequenza di decisioni.
Punti di forza chiave
Comprensione del codebase
Un modello di programmazione utile deve comprendere come interagiscono le diverse parti di un progetto. Dovrebbe essere in grado di identificare la causa di un bug, determinare quali file necessitano di modifiche ed evitare di introdurre regressioni altrove.
Claude Opus 5.5 │ un forte candidato da valutare per questi flussi di lavoro, specialmente quando il compito richiede un'attenzione prolungata alla struttura e ai requisiti di un progetto.
Istruzioni complesse e scrittura
Molti compiti professionali comportano istruzioni dettagliate che non possono essere ridotte a una singola domanda. Un utente pu specificare pubblico, tono, vincoli tecnici, regole di formattazione e un elenco di deliverable richiesti.
Claude pu essere valutato su quanto bene rispetta tali vincoli, mantiene la coerenza e produce un lavoro che necessita di modifiche minime.
Flussi di lavoro di agenti a lungo termine
Per i team di sviluppo, un agente di IA potrebbe dover ispezionare un progetto, apportare modifiche, eseguire test, interpretare errori e rivedere la propria implementazione.
Il numero di passaggi completati con successo │ spesso pi significativo della qualit¢ della prima risposta.
Quali sono le limitazioni?
Un modello capace pu comunque sovraccaricare di complessit¢ un compito, fare ipotesi errate o consumare quote d'uso sostanziali durante una sessione lunga.
Anche i limiti di accesso e le regole di abbonamento sono importanti. Le discussioni della community menzionano frequentemente i limiti di utilizzo, anche quando gli utenti sono soddisfatti della qualit¢ del modello.
Le tariffe API standard pubblicate di Claude Opus 5.5 sono di $4 per milione di token in ingresso e $20 per milione di token in uscita. Queste sono inferiori alle tariffe standard di Astra, sebbene il costo effettivo dipenda dai modelli di utilizzo, dal caching e da servizi aggiuntivi.
Vedi la documentazione ufficiale di Anthropic su Claude Opus per le informazioni attuali sui prodotti e sui prezzi.
Cosa ci dicono effettivamente i benchmark?
I punteggi dei benchmark sono utili per comprendere le capacit¢ dei modelli, ma non raccontano l'intera storia.
Test diversi misurano competenze diverse. Un modello che ottiene buoni risultati in un lungo benchmark di ingegneria del software potrebbe non essere la scelta migliore per la ricerca fattuale, la scrittura o l'analisi visiva.
L'annuncio di Argon da parte di Google e i risultati di valutazione pubblicati di GPT-6 Astra offrono diversi punti di confronto utili.
Risultati selezionati dei benchmark di programmazione
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Circa 78% | 74,1% | Circa 74% |
| FrontierSWE v2 | Consulta la valutazione pubblicata da Google | Vantaggio segnalato nei confronti disponibili | Consulta la valutazione pubblicata da Google |
| Terminal-Bench 4.0 | Consulta la valutazione pubblicata da Google | 57,9% nei risultati pubblicati da OpenAI | Potrebbero applicarsi diversi risultati di valutazione |
Fonti: l'annuncio di Argon da parte di Google, la documentazione del modello Astra di OpenAI e il confronto di ottobre 2026 tra Argon e i suoi concorrenti.
Importante: queste cifre dovrebbero essere trattate come risultati dichiarati, non come un confronto indipendente completamente controllato. I risultati possono variare in base alla versione del modello, al sistema di testing, all'accesso agli strumenti, alle impostazioni di ragionamento e alla data di valutazione. Laddove le fonti originali non stabiliscono una cifra direttamente comparabile, la tabella evita deliberatamente di inventarne una.
I risultati disponibili illustrano anche perch← una classifica universale sia fuorviante. stato riportato che Argon │ in testa su DeepSWE v1.1, mentre Astra e Opus possono mostrare prestazioni diverse in altre valutazioni di ingegneria del software.
Un approccio migliore consiste nel chiedersi quale benchmark assomigli di pi al tuo carico di lavoro effettivo.
- Per la manutenzione del codice, dai la priorit¢ alle attivit¢ reali su repository e ai tassi di superamento dei test.
- Per la ricerca, misura l'accuratezza fattuale e se le citazioni supportano le affermazioni.
- Per i flussi di lavoro di agenti, misura il completamento end-to-end e il ripristino dagli errori.
- Per la scrittura aziendale, valuta l'accuratezza, il rispetto delle istruzioni e il tempo di revisione.
Il benchmark │ un punto di partenza. Il tuo compito specifico │ il test finale.
Cosa dicono gli utenti di Reddit su questi modelli?
Reddit offre una prospettiva diversa rispetto agli annunci ufficiali. Gli utenti discutono degli aspetti delle prestazioni del modello che notano durante il lavoro quotidiano, inclusi qualit¢ del codice, creativit¢, velocit¢, limiti di utilizzo e quantit¢ di guida di cui un modello ha bisogno.
Queste discussioni sono un'evidenza utile delle priorit¢ degli utenti, ma sono aneddotiche. Un post non stabilisce che un modello sia oggettivamente migliore per ogni utente.
Gemini 4 Argon: punteggi impressionanti, ma l'accesso rimane una preoccupazione
Nella discussione su r/singularity sui benchmark di Gemini 4 Argon, gli utenti hanno discusso i risultati riportati da Google in ambito di programmazione, sicurezza informatica e compiti professionali.
Una domanda ricorrente era se le prestazioni del modello si sarebbero tradotte in benefici pratici e quando sarebbe diventato disponibile un accesso pi ampio.
Questo crea una distinzione utile per un articolo comparativo: la leadership nei benchmark non equivale all'utilit¢ quotidiana. Gli utenti hanno bisogno di un modo per testare il modello sui propri compiti prima di decidere se valga la pena adottarlo.
GPT-6 Astra vs Claude Opus 5.5: qualit¢, velocit¢ e limiti di utilizzo
La discussione su r/ClaudeAI che confronta Opus 5.5 con GPT-6 Astra illustra con quale rapidit¢ le preferenze della community possano cambiare tra una versione e l'altra del modello.
I partecipanti hanno descritto esperienze diverse con i modelli. Alcuni hanno preferito Astra, mentre altri hanno elogiato le capacit¢ di Opus 5.5 pur criticando la quantit¢ di guida che a volte dovevano fornire.
La lezione pi generale │ che la qualit¢ del modello dipende in parte dal compito e dal flusso di lavoro dell'utente. Un modello che funziona bene per uno sviluppatore potrebbe essere meno adatto ai requisiti di un altro progetto.
I limiti di utilizzo rappresentano un'altra preoccupazione. In una discussione su Reddit sulla scelta tra Opus 5.5 e Astra, un utente ha sollevato dubbi sull'esaurimento dell'utilizzo e se il cambio di abbonamento avrebbe offerto un valore migliore.
Per gli utenti frequenti, il costo del lavoro prolungato pu contare quanto la qualit¢ delle singole risposte.
Un semplice compito creativo pu produrre risultati diversi
In un confronto su Reddit tra Opus 5.5, GPT-6 Astra e altri modelli, gli utenti hanno discusso l'invio dello stesso prompt a diversi modelli per creare una breve animazione di un aeroplanino di carta.
Le risposte hanno riflesso preferenze diverse: alcuni utenti hanno preferito la qualit¢ dell'animazione, mentre altri hanno preferito l'interpretazione o la direzione creativa di un modello diverso.
Questo │ un utile promemoria del fatto che i confronti tra modelli non si limitano alla programmazione e al ragionamento. Per il lavoro creativo, la qualit¢ dell'output pu essere soggettiva e il modello pi appropriato dipende dal risultato desiderato dall'utente.
Cosa possiamo imparare dalle discussioni?
In tutti questi thread emergono quattro temi principali:
- Le prestazioni nel mondo reale contano pi di un punteggio ad effetto. Gli utenti desiderano modelli che risolvano i loro problemi specifici.
- Il rispetto delle istruzioni influisce sulla produttivit¢. Un modello forte │ pi utile quando comprende i vincoli senza chiare e ripetute spiegazioni.
- I limiti di utilizzo influenzano l'esperienza complessiva. Risultati di alta qualit¢ hanno meno valore se gli utenti non possono sostenere il proprio flusso di lavoro.
- Compiti diversi premiano punti di forza diversi. Output creativo, programmazione, ricerca e automazione non dovrebbero essere valutati utilizzando gli stessi criteri.
Queste osservazioni dovrebbero guidare i test in questo articolo, anzich← sostituirli.
Come confrontare i tre modelli nei compiti del mondo reale
Il confronto pi utile darebbe a tutti e tre i modelli lo stesso compito, gli stessi materiali di input e gli stessi criteri di valutazione.
Se tutti e tre i modelli sono a tua disposizione, i seguenti test possono aiutarti a determinare quale si adatta meglio al tuo flusso di lavoro.
Test 1: Programmazione e debugging
Fornisci a ciascun modello lo stesso piccolo codebase contenente un bug riproducibile. Chiedigli di identificare il problema, implementare una correzione, scrivere test e spiegare le modifiche.
Misura:
- Se il bug originale │ stato risolto
- Se i test esistenti continuano a passare
- Se sono stati introdotti nuovi bug
- Quanti prompt di approfondimento sono necessari
- Tempo totale e utilizzo dei token
Un modello che produce una spiegazione plausibile ma non supera i test non dovrebbe essere considerato il vincitore.
Test 2: Ricerca e analisi di documenti
Fornisci lo stesso insieme di report, tabelle e documenti di origine. Chiedi a ciascun modello di sintetizzare le prove, estrarre cifre importanti, identificare contraddizioni e preparare un breve report con riferimenti.
Misura l'accuratezza fattuale, la qualit¢ delle citazioni, la copertura delle informazioni importanti e la quantit¢ di correzione manuale richiesta.
Questo test │ particolarmente utile per analisti, studenti, consulenti e team di contenuti.
Test 3: Esecuzione di progetti multi-step
Fornisci a ciascun modello un compito che richiede diversi deliverable, come l'analisi di un'idea di prodotto, lo sviluppo di un piano di progetto, la creazione di una tabella di attivit¢ e la preparazione di un report finale.
Valuta se segue la sequenza richiesta, mantiene la coerenza tra i deliverable e verifica il risultato finale.
Se l'ambiente fornisce strumenti, registra se il modello li utilizza correttamente. Mantieni l'intelligenza del modello separata dalle capacit¢ della piattaforma che lo esegue.
Test 4: Scrittura e rispetto delle istruzioni
Fornisci un brief di scrittura dettagliato con un pubblico target, un tono, i punti richiesti, la lunghezza e i vincoli.
Confronta i risultati per accuratezza fattuale, leggibilit¢, struttura, originalit¢ e conformit¢ al brief.
Per i team di marketing, questo pu rivelare quale modello produce prime bozze utilizzabili e quale richiede maggiori modifiche.
Utilizza un sistema di punteggio coerente
Una semplice valutazione a 100 punti pu rendere i risultati pi facili da confrontare.
| Criterio | Peso suggerito |
|---|---|
| Accuratezza e correttezza | 30 |
| Completamento del compito | 25 |
| Rispetto delle istruzioni | 15 |
| Qualit¢ dell'output | 15 |
| Velocit¢ ed efficienza | 10 |
| Costo | 5 |
| Totale | 100 |
I pesi dovrebbero cambiare in base al compito. Ad esempio, i test di programmazione dovrebbero porre maggiore enfasi sul codice funzionante e sul superamento dei test, mentre i test di ricerca dovrebbero dare priorit¢ all'accuratezza fattuale e alla qualit¢ delle fonti.
Non pubblicare un punteggio come test indipendente a meno che tu non abbia effettivamente condotto l'esperimento. Se l'accesso ad Argon │ limitato, utilizza un confronto chiaramente etichettato dei risultati pubblicati e riserva la sezione dei test indipendenti per i modelli che puoi valutare autenticamente.
Confronto dei prezzi: quale modello offre un valore migliore?
Le tariffe API standard pubblicate per questi modelli forniscono un utile punto di partenza.
| Modello | Input per 1 milione di token | Output per 1 milione di token |
|---|---|---|
| Gemini 4 Argon | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
Fonti: Google, OpenAI e Anthropic.
A queste tariffe standard pubblicate, Argon ha il prezzo per token pi basso elencato, seguito da Opus 5.5 e Astra. Tuttavia, ci non rende automaticamente Argon l'opzione pratica pi economica per ogni utente, specialmente fino a quando l'accesso rimane limitato.
Esempio: un compito che utilizza 100.000 token in ingresso e 20.000 token in uscita
Presupponendo l'applicazione delle tariffe pubblicate, senza sconti per il caching, costi di strumenti o altri addebiti:
- Gemini 4 Argon: $0,20 input + $0,20 output = $0,40
- GPT-6 Astra: $1,00 input + $1,00 output = $2,00
- Claude Opus 5.5: $0,40 input + $0,40 output = $0,80
Questo │ un esempio di costo in token, non un'affermazione secondo cui i modelli utilizzino lo stesso numero di token per completare lo stesso compito.
Per un confronto pi equo, calcola il costo per produrre un risultato positivo. Se un modello richiede cinque tentativi e un altro completa il compito in un solo tentativo, i loro costi effettivi possono differire in modo significativo dal rapporto standard tra i prezzi dei token.
Anche i piani di abbonamento hanno prezzi, limiti e regole di utilizzo propri. Non confrontare direttamente i prezzi delle API con le tariffe di abbonamento come se fossero equivalenti.
Quale modello di IA │ il migliore per le tue esigenze?
Il modello giusto dipende da ci che fai, dalla frequenza con cui usi l'IA e da come si presenta un risultato di successo.
Per gli sviluppatori software
Prendi in considerazione l'idea di testare GPT-6 Astra e Claude Opus 5.5 sul tuo effettivo codebase. Entrambi sono posizionati per compiti di ingegneria impegnativi, ma le loro prestazioni relative dipenderanno dal tuo linguaggio, dagli strumenti e dalla complessit¢ del progetto.
Vale la pena tenere d'occhio anche Gemini 4 Argon per i suoi risultati dichiarati nell'ingegneria del software, a condizione di accesso e verifica indipendente.
Per ricercatori e analisti
Dai la priorit¢ all'estrazione accurata delle informazioni, alle citazioni affidabili, alla gestione di documenti lunghi e alla capacit¢ di distinguere i fatti dalle ipotesi.
Per lavori che coinvolgono grandi raccolte di file, verifica se il modello │ in grado di trovare dettagli rilevanti senza trascurare prove contraddittorie.
Per creatori di contenuti e marketer
Confronta quanto bene ciascun modello segue un brief di contenuto, mantiene un tono coerente, organizza le informazioni e produce bozze che necessitano di modifiche minime.
Un flusso di lavoro pratico potrebbe includere la ricerca di parole chiave, la stesura della struttura, la redazione, il fact-checking e l'adattamento dei contenuti per diversi pubblici. La revisione umana rimane essenziale, specialmente per le affermazioni fattuali e i contenuti SEO.
Per gli utenti aziendali
Concentrati sul completamento delle attivit¢, sull'analisi dei documenti, sui flussi di lavoro con fogli di calcolo, sulla reportistica e sull'affidabilit¢ degli output.
Per le attivit¢ ricorrenti, anche una piccola riduzione del tempo di revisione manuale pu contare pi di un modesto miglioramento nei punteggi dei benchmark.
Per gli utenti attenti al budget
Confronta il costo effettivo per il completamento delle tue attivit¢ comuni anzich← selezionare un modello basandoti solo sulla sua intelligenza pubblicizzata.
Se un modello meno costoso soddisfa costantemente i tuoi requisiti, potrebbe essere l'opzione migliore per l'uso quotidiano. Riserva i modelli pi costosi per i lavori in cui le loro capacit¢ aggiuntive fanno una differenza misurabile.
Come esplorare i modelli di IA e completare le attivit¢ su ChatGOAT AI
Confrontare i modelli │ utile, ma il vero beneficio dell'IA deriva dall'applicarla al proprio lavoro.
ChatGOAT AI fornisce uno spazio di lavoro IA per i modelli e gli strumenti supportati, aiutando gli utenti ad esplorare flussi di lavoro di scrittura, ricerca, analisi e creativit¢ assistiti dall'IA senza dover trattare ogni compito come un esperimento separato.
Laddove Gemini 4 Argon, GPT-6 Astra e Claude Opus 5.5 siano abilitati nel selettore di modelli attuale di ChatGOAT, gli utenti possono esplorare le loro risposte all'interno della piattaforma e valutare quale approccio funzioni meglio per le loro esigenze. La disponibilit¢ pu variare in base al modello e all'integrazione, quindi controlla l'elenco dei modelli attivi prima di iniziare.
Cosa puoi fare con l'IA su ChatGOAT AI?
Scrivere e migliorare i contenuti
Utilizza l'IA per fare brainstorming di idee per articoli, creare strutture, redigere post per blog, riscrivere paragrafi, riassumere materiali lunghi o adattare i contenuti per diversi pubblici.
Ad esempio, uno specialista SEO pu sviluppare la struttura di un blog, redigere un articolo comparativo, preparare risposte alle FAQ e rivedere il contenuto per migliorarne la chiarezza e l'intento di ricerca.
Analizzare informazioni e documenti
L'IA pu aiutare ad estrarre i punti chiave dai materiali forniti, confrontare report, organizzare i risultati delle ricerche e trasformare appunti non strutturati in un riassunto pi chiaro.
Ad esempio, un utente aziendale pu trasformare gli appunti di una riunione in un piano d'azione, creare una tabella comparativa e preparare un sintetico executive summary.
Creare tabelle strutturate e piani di progetto
Utilizza l'IA per organizzare confronti di prodotti, preparare elenchi di attivit¢, creare matrici di ricerca e sviluppare piani di progetto strutturati.
Un team di marketing potrebbe utilizzare questo flusso di lavoro per confrontare le funzionalit¢ dei concorrenti, associare le parole chiave alle landing page e organizzare un calendario editoriale.
Supportare la programmazione e la risoluzione dei problemi
Per i flussi di lavoro di programmazione supportati, l'IA pu spiegare codice sconosciuto, suggerire passaggi di debugging, redigere funzioni e aiutare ad organizzare la documentazione tecnica.
Testa sempre il codice generato e rivedi le modifiche prima di utilizzarle in produzione.
Esplorare la creazione di immagini
ChatGOAT AI offre anche funzionalit¢ di generazione di immagini tramite IA attraverso i suoi strumenti e modelli di immagini supportati. Questi possono aiutare gli utenti a creare illustrazioni, concetti visivi, grafiche per i social media e altre risorse creative.
La generazione di immagini │ una capacit¢ separata dal ragionamento dei modelli di testo. Non presupporre che ogni modello in questo confronto possa generare direttamente immagini solo perch← lo spazio di lavoro include strumenti per le immagini.
Costruire un flusso di lavoro pi efficiente
Invece di trattare ogni compito come un prompt isolato, gli utenti possono suddividere un progetto in fasi: ricerca, pianificazione, stesura, verifica e consegna finale.
Il flusso di lavoro pi utile │ quello che produce risultati accurati con meno lavoro ripetitivo, non necessariamente quello che utilizza il modello pi avanzato per ogni passaggio.
Esplora ChatGOAT AI per vedere i modelli e gli strumenti di IA attualmente supportati disponibili per il tuo flusso di lavoro.
FAQ
Gemini 4 Argon │ migliore di GPT-6 Astra?
Non in tutte le situazioni. Google ha riportato ottimi risultati per Argon su benchmark selezionati di ingegneria e lavoro professionale, mentre OpenAI pubblica risultati eccellenti per Astra su diverse valutazioni impegnative. Le restrizioni di accesso e le differenze nei metodi di testing rendono prematura una classifica universale.
Claude Opus 5.5 │ migliore di GPT-6 Astra per la programmazione?
Entrambi sono progettati per compiti impegnativi di ingegneria del software. L'opzione migliore dipende dal codebase, dal linguaggio di programmazione, dagli strumenti disponibili e dalla qualit¢ dell'implementazione finale. Confronta i tassi di superamento dei test, i rischi di regressione, il numero di iterazioni e il costo totale per lo stesso compito.
Quale modello │ il migliore per il ragionamento complesso?
GPT-6 Astra e Gemini 4 Argon sono entrambi posizionati per il ragionamento complesso e il lavoro multi-step, mentre Claude Opus 5.5 │ progettato per flussi di lavoro professionali e di agenti impegnativi. Utilizza test specifici per il tuo compito per determinare quale modello funzioni meglio per le tue esigenze.
Quale modello │ il pi economico?
In base alle tariffe API standard pubblicate ed elencate sopra, Gemini 4 Argon ha il prezzo dei token pi basso, seguito da Claude Opus 5.5 e GPT-6 Astra. Tuttavia, la disponibilit¢ limitata di Argon influisce sulla possibilit¢ che la maggior parte degli utenti possa effettivamente usufruire di tale prezzo. Il costo totale del compito dipende anche dall'utilizzo dei token, dai tentativi, dal caching e dagli strumenti.
Posso usare Gemini 4 Argon in questo momento?
Google ha inizialmente annunciato Argon per i difensori della sicurezza informatica fidati attraverso il programma Fairwind, con un accesso pi ampio pianificato in seguito. Controlla l'ultimo annuncio ufficiale di Google per eventuali modifiche alla disponibilit¢ prima di fare affidamento su di esso per un progetto.
Posso confrontare questi modelli su ChatGOAT AI?
Puoi esplorare i modelli e gli strumenti supportati dall'attuale spazio di lavoro di ChatGOAT AI. Per confrontarli direttamente tutti e tre, verifica che Gemini 4 Argon, GPT-6 Astra e Claude Opus 5.5 siano tutti disponibili nel selettore di modelli attuale. Se uno non │ disponibile, confronta invece la sua documentazione pubblicata con i risultati pratici dei modelli accessibili.
Quale modello │ il migliore per il lavoro quotidiano?
Non esiste una risposta universale. Considera i compiti che svolgi pi spesso, quanto devono essere accurati i risultati, la quantit¢ di modifiche richieste, il tuo budget e i limiti di utilizzo della tua piattaforma preferita. Testare alcune attivit¢ rappresentative │ pi utile che scegliere unicamente in base alla reputazione.
Verdetto finale: scegli il modello che completa meglio il tuo lavoro
Gemini 4 Argon, GPT-6 Astra e Claude Opus 5.5 rappresentano approcci diversi all'assistenza avanzata tramite IA. Argon vanta punti di forza dichiarati in valutazioni selezionate di ingegneria e lavoro professionale, Astra si rivolge a compiti impegnativi di ragionamento e utilizzo del computer, mentre Opus 5.5 si concentra su agenti di programmazione e flussi di lavoro professionali a lungo termine.
Il miglior modello non │ necessariamente quello con il punteggio pi alto o le API pi costose. quello che completa in modo affidabile i tuoi compiti, segue le tue istruzioni, si adatta al tuo budget e richiede il minor intervento superfluo.
Utilizza i benchmark ufficiali per restringere le tue opzioni, le discussioni su Reddit per comprendere le domande che si pongono gli utenti reali e test pratici coerenti per prendere la decisione finale.
Con ChatGOAT AI puoi esplorare i modelli di IA e gli strumenti supportati per la scrittura, la ricerca, l'analisi e il lavoro creativo in un unico spazio di lavoro. Inizia con un compito che devi effettivamente completare, confronta la qualit¢ dei risultati e scegli il flusso di lavoro che rende il tuo lavoro pi semplice.