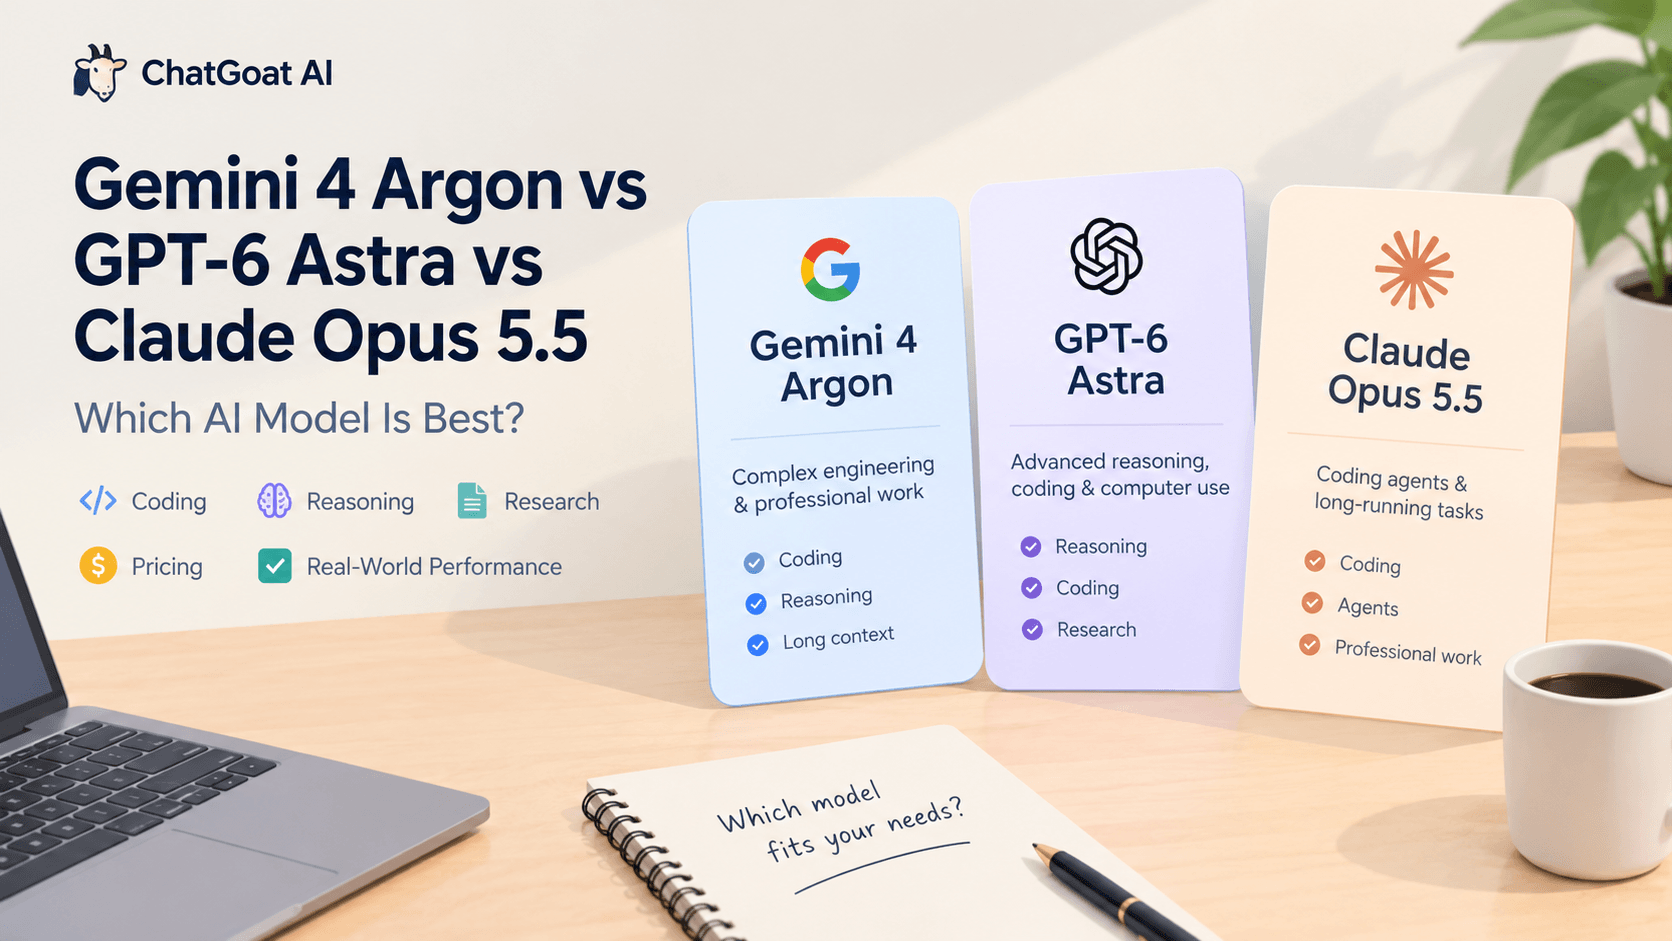
A Gemini 4 Argon, a GPT-6 Astra és a Claude Opus 5.5 közötti verseny fontos elmozdulást jelez a mesterséges intelligencia terén. A mai vezető modelleket már nem csupán az alapján ítélik meg, hogy mennyire jól válaszolnak meg kérdéseket. A fejlesztők, kutatók és a mindennapi felhasználók olyan MI-t is elvárnak, amely képes összetett problémákat megoldani, nagy projekteket átlátni, megbízható kódot írni, dokumentumokat elemezni és több lépésből álló feladatokat elvégezni kevesebb felügyelet mellett.
Mindegyik modell eltérő erősségekkel rendelkezik. A Google a Gemini 4 Argon-t az összetett mérnöki feladatok, a professzionális tudásalapú munka és a kiberbiztonsági védelem köré pozicionálja. Az OpenAI a GPT-6 Astra-t a komoly érvelési, kódolási, kutatási és számítógép-használati feladatok modelljeként mutatja be. Az Anthropic a Claude Opus 5.5 képességeit hangsúlyozza a szoftverfejlesztés, a hosszan futó ágensek és a professzionális munka terén.
De melyik modellt érdemes választania? Valóban jobb a Gemini 4 Argon a kódolásban? Indokolja a GPT-6 Astra a magasabb API-árát? Képes a Claude Opus 5.5 bonyolult projekteket elvégezni kevesebb utasítással?
Ez az összehasonlítás a hivatalos teljesítménytesztek (benchmarkok) eredményeit, az árazást, az elérhetőséget, a gyakorlati felhasználási eseteket és a Reddit-megbeszéléseket vizsgálja. Azt is elmagyarázza, hogyan értékelheti ezeket a modelleket a valódi munkában, és hogyan fedezhet fel MI-alapú munkafolyamatokat a ChatGOAT AI segítségével.
Gyors ítélet: Gemini 4 Argon vs. GPT-6 Astra vs. Claude Opus 5.5
Nincs egyetlen győztes minden feladatra. A legjobb választás a szándékolt feladattól, a költségkerettől és attól függ, hogy hozzáfér-e a modellhez a preferált platformján keresztül.
| Összehasonlítás | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Elsődleges pozicionálás | Összetett mérnöki és professzionális munkafolyamatok | Fejlett érvelés, kódolás, kutatás és számítógép-használat | Kódoló ágensek és hosszan futó professzionális feladatok |
| Kódolás | Erős eredmények kiválasztott szoftverfejlesztési teszteken | Erős a komoly érvelést igénylő kódolási és technikai feladatokban | Összetett kódolási és ágens-munkafolyamatokra tervezve |
| Érvelés | Összetett, több lépésből álló problémamegoldásra tervezve | Igényes érvelésre és professzionális munkára tervezve | Erős az összetett utasítások követésében és a tartós munkában |
| Hosszú kontextusú munka | Akár 1 millió kimeneti token bejelentve | 1,05 millió tokenes kontextusablak | Hosszan futó ágens-munkafolyamatok és nagy projektek |
| Standard API bemeneti ár | 2 $ / millió token | 10 $ / millió token | 4 $ / millió token |
| Standard API kimeneti ár | 10 $ / millió token | 50 $ / millió token | 20 $ / millió token |
| Elérhetőség | Kezdetben a megbízható kiberbiztonsági védőkre korlátozva | Elérhető az OpenAI támogatott termékein és API-ján keresztül | Elérhető a támogatott Claude és fejlesztői platformokon keresztül |
Források: A Google Gemini 4 Argon bejelentése, Az OpenAI GPT-6 Astra modell-dokumentációja és Az Anthropic Claude Opus dokumentációja.
Ezeket a modelleket nem szabad kizárólag az ár vagy egyetlen teljesítményteszt alapján rangsorolni. Egy tokenenként olcsóbb modellnek több újrapróbálkozásra lehet szüksége egy feladat befejezéséhez, míg egy lenyűgöző teszteredménnyel rendelkező modell nem biztos, hogy elérhető az átlagos felhasználó számára.
A gyakorlati tanulság: Hasonlítsa össze a végeredmény minőségét, a szükséges időt, a javítások számát és a feladat elvégzésének tényleges költségét.
Gemini 4 Argon: Összetett mérnöki és tudásalapú munkára tervezve
A Google 2026. szeptember 30-án jelentette be a Gemini 4 Argon-t, amelyet a valódi szoftverfejlesztés, a vállalati tudásalapú munka és a kiberbiztonsági védelem élvonalbeli modelljeként pozicionál.
Az elsősorban mindennapi beszélgetésekre tervezett modellektől eltérően az Argon olyan rendszerként mutatkozik be, amely képes hosszú, egymással összefüggő feladatok kezelésére. Ezek magukban foglalhatják a terjedelmes technikai információk vizsgálatát, a problémák azonosítását, a cselekvéssorozat megtervezését és a végeredmény előállítását.
Főbb erősségek
Összetett szoftverfejlesztés
Az Argon erős eredményeket mutatott kiválasztott szoftverfejlesztési teszteken. A Google bejelentése a hosszú távú mérnöki feladatokat hangsúlyozza, ahol az MI-rendszernek meg kell őriznie a kontextust, miközben egy bonyolult problémán dolgozik.
A lehetséges alkalmazások közé tartozik a nagy kódalapok áttekintése, a hiba okának azonosítása, a migráció megtervezése és annak értékelése, hogy a javasolt módosítások megoldják-e az eredeti problémát.
Professzionális kutatás és dokumentumelemzés
A Google a jogi, pénzügyi és egyéb vállalati tudásalapú munkát is kiemeli. Ez teszi a dokumentumigényes feladatokat fontos értékelési területté, különösen akkor, ha a modellnek több fájlon keresztül kell összekapcsolnia az információkat.
Egy üzleti elemző például használhat egy MI-munkafolyamatot a jelentések összefoglalására, a pénzügyi adatok kinyerésére, a feltételezések összehasonlítására és egy strukturált tájékoztató előkészítésére az emberi áttekintéshez.
Hosszú formátumú kimenet
A Google legfeljebb egymillió tokenes maximális kimeneti korlátot jelentett be az Argon esetében. Ez egy kimeneti keret, ami nem ugyanaz, mint a kontextusablak. A különbségtétel azért fontos a modellek összehasonlításakor, mert az információmennyiség, amit egy modell fogadni tud, és az, amit generálni képes, két eltérő képesség.
Melyek a korlátok?
A legnagyobb gyakorlati korlát a hozzáférés. A bejelentéskor a Google az Argont a Fairwind Programon keresztül a megbízható kiberbiztonsági védők számára tette elérhetővé, a szélesebb körű elérhetőséget pedig egy későbbi szakaszra tervezte.
Ez azt jelenti, hogy a közzétett eredményeket nem szabad automatikusan az átlagos felhasználók által függetlenül reprodukálhatónak tekinteni.
A magas teszteredmény azt sem bizonyítja, hogy az Argon minden programozási nyelvben, kutatási feladatban vagy valódi projektben felülmúlja a többi modellt.
További háttérinformációkért tekintse meg a Google hivatalos bejelentését a Gemini 4 Argonról.
GPT-6 Astra: Fejlett érvelés, kódolás és számítógép-használat
Az OpenAI a GPT-6 Astra-t az igényes professzionális feladatok modelljeként írja le, beleértve az összetett érvelést, a szoftverfejlesztést, a kutatást, a dokumentumkészítést és a számítógép-használatot.
Értéke nem korlátozódik arra, hogy egyetlen válaszváltásban jó választ adjon. A megfelelő munkafolyamatoknál a cél a probléma végiggondolása, a rendelkezésre álló eszközök használata és a világosan meghatározott eredmény felé történő haladás.
Főbb erősségek
Fejlett érvelés
A GPT-6 Astra-t olyan problémákra szánják, amelyek többet igényelnek egy tény visszakeresésénél vagy egy rövid válasz generálásánál. Értékelhető matematikai érvelésben, tervezésben, összetett technikai kérdésekben és több megkötést tartalmazó feladatokban.
Egy termékmenedzser például megkérheti, hogy hasonlítsa össze a versengő termékstratégiákat, azonosítsa a kockázatokat, építsen fel egy döntési keretrendszert és készítsen megvalósítási tervet.
Szoftverfejlesztés és hibakeresés
Az Astra segíthet a fejlesztőknek kódgenerálásban, a meglévő megvalósítások ellenőrzésében, a hibák diagnosztizálásában és a bonyolultabb mérnöki feladatok elvégzésében.
A hasznos tesztek közé tartozik egy ismeretlen projekt hibakeresése, több fájl módosítása, egységtesztek generálása és annak ellenőrzése, hogy a végső megvalósítás megfelel-e a követelményeknek.
Számítógép-használati és ágens-munkafolyamatok
Az OpenAI dokumentálja a számítógép-használattal kapcsolatos képességeket is. A tényleges automatizálás azonban a modell futási környezete által biztosított eszközöktől, jogosultságoktól és biztonsági korlátoktól függ.
Az a tény, hogy egy modell képes megtervezni egy feladatot, nem jelenti azt, hogy minden csevegőfelület automatikusan lehetővé teszi számára a weboldalak böngészését, az alkalmazások kezelését vagy a kód végrehajtását.
Melyek a korlátok?
A GPT-6 Astra magasabb standard API-tokenárral rendelkezik, mint az összehasonlításban szereplő másik két modell. A közzétett díjai 10 $ / 1 millió bemeneti token és 50 $ / 1 millió kimeneti token, az esetleges gyorsítótárazási, eszköz- és egyéb díjak előtt.
A sok hosszú beszélgetést vagy nagy méretű automatizált munkafolyamatokat futtató felhasználók számára a költségek gyorsan felhalmozódhatnak.
Ezért a modellt az elvégzett munka minősége alapján kell értékelni, nem pedig csak a nyers intelligenciája alapján. Ha egy olcsóbb alternatíva ugyanolyan megbízható eredményeket hoz egy rutinfeladathoz, nem biztos, hogy szükséges a drágább modellért fizetni.
Olvasson többet az OpenAI GPT-6 Astra dokumentációjában.
Claude Opus 5.5: Kódoló ágensek és hosszan futó feladatok
A Claude Opus 5.5 az igényes szoftverfejlesztés, a hosszan futó ágens-munkafolyamatok és a professzionális munka köré pozicionált. Sok fejlesztő számára a vonzereje abban rejlik, hogy egy bonyolult feladatot delegálhat, miközben az eredeti követelmények a folyamat során végig megmaradnak.
Ez különösen fontos akkor, ha egy projekt több fájlt, több függőséget vagy döntések hosszú sorozatát foglalja magában.
Főbb erősségek
Kódalap megértése
Egy hasznos kódoló modellnek meg kell értenie, hogyan lépnek kölcsönhatásba a projekt különböző részei. Képesnek kell lennie a hiba okának azonosítására, a módosítandó fájlok meghatározására, és el kell kerülnie a regressziók bevezetését máshol.
A Claude Opus 5.5 erős jelölt ezen munkafolyamatok értékelésére, különösen akkor, ha a feladat tartós figyelmet igényel a projekt szerkezetére és követelményeire.
Összetett utasítások és írás
Sok professzionális feladat részletes utasításokat tartalmaz, amelyeket nem lehet egyetlen kérdésre leegyszerűsíteni. A felhasználó meghatározhatja a célközönséget, a hangnemet, a technikai korlátokat, a formázási szabályokat és a szükséges eredmények listáját.
A Claude értékelhető az alapján, hogy mennyire követi ezeket a megkötéseket, mennyire tartja fenn a konzisztenciát, és hogy minimális szerkesztést igénylő munkát végez-e.
Hosszan futó ágens-munkafolyamatok
A fejlesztőcsapatok számára előfordulhat, hogy egy MI-ágensnek át kell vizsgálnia egy projektet, módosításokat kell végeznie, teszteket kell futtatnia, értelmeznie kell a hibákat és felül kell vizsgálnia a megvalósítását.
A sikeresen teljesített lépések száma gyakran többet jelent, mint az első válasz minősége.
Melyek a korlátok?
Egy felelősségteljes modell is túlbonyolíthat egy feladatot, helytelen feltételezéseket tehet, vagy jelentős használati keretet fogyaszthat el egy hosszú munkamenet során.
A hozzáférési korlátok és az előfizetési szabályok is számítanak. A közösségi beszélgetésekben gyakran említik a használati korlátokat, még akkor is, ha a felhasználók elégedettek a modell minőségével.
A Claude Opus 5.5 közzétett standard API-díjai 4 $ / 1 millió bemeneti token és 20 $ / 1 millió kimeneti token. Ezek alacsonyabbak az Astra standard díjainál, bár a tényleges költség a használati mintáktól, a gyorsítótárazástól és a kiegészítő szolgáltatásoktól függ.
Tekintse meg az Anthropic hivatalos Claude Opus dokumentációját a aktuális termék- és árazási információkért.
Mit mondanak nekünk valójában a benchmarkok?
A teljesítménytesztek (benchmarkok) pontszámai hasznosak a modell képességeinek megértéséhez, de nem tárják fel a teljes képet.
A különböző tesztek eltérő készségeket mérnek. Egy modell, amely jól teljesít egy hosszú szoftverfejlesztési teszten, nem biztos, hogy a legjobb választás tényalapú kutatáshoz, íráshoz vagy vizuális elemzéshez.
A Google Argon bejelentése és a közzétett GPT-6 Astra értékelési eredmények számos hasznos összehasonlítási pontot nyújtanak.
Válogatott kódolási teszteredmények
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Körülbelül 78% | 74,1% | Körülbelül 74% |
| FrontierSWE v2 | Lásd a Google közzétett értékelését | Jelentett előny az elérhető összehasonlításokban | Lásd a Google közzétett értékelését |
| Terminal-Bench 4.0 | Lásd a Google közzétett értékelését | 57,9% az OpenAI közzétett eredményeiben | Eltérő értékelési eredmények lehetnek érvényesek |
Források: A Google Argon bejelentése, Az OpenAI Astra modell-dokumentációja és az Argon és versenytársai 2026. októberi összehasonlítása.
Fontos: Ezeket a számokat bejelentett eredményekként kell kezelni, nem pedig teljes mértékben ellenőrzött független összehasonlításként. Az eredmények eltérhetnek a modellverzió, a tesztelési keretrendszer, az eszközök hozzáférése, az érvelési beállítások és az értékelés dátuma szerint. Ahol az eredeti források nem határoznak meg közvetlenül összehasonlítható adatot, a táblázat szándékosan kerülte az adatok kitalálását.
A rendelkezésre álló eredmények azt is szemléltetik, miért félrevezető egy univerzális rangsor. Jelentések szerint az Argon vezet a DeepSWE v1.1 teszten, míg az Astra és az Opus eltérően teljesíthet más szoftverfejlesztési értékeléseken.
Jobb megközelítés, ha megkérdezi: melyik benchmark hasonlít a tényleges munkájára?
- Karbantartáshoz helyezze a hangsúlyt a valódi tárolófeladatokra és a tesztek sikeres teljesítésére.
- Kutatáshoz mérje a ténybeli pontosságot és azt, hogy az hivatkozások alátámasztják-e az állításokat.
- Ágens-munkafolyamatoknál mérje a teljes folyamat befejezését és a hibákból való felépülést.
- Üzleti írásnál értékelje a pontosságot, az utasítások követését és a szerkesztési időt.
A benchmark kiindulópont. A saját feladata jelenti a végső tesztet.
Mit mondanak a Reddit-felhasználók ezekről a modellekről?
A Reddit eltérő perspektívát kínál a hivatalos bejelentésekhez képest. A felhasználók a modell teljesítményének azon részeit vitatják meg, amelyeket a mindennapi munka során észlelnek, beleértve a kód minőségét, a kreativitást, a sebességet, a használati korlátokat és a modell által igényelt útmutatás mennyiségét.
Ezek a megbeszélések hasznos bizonyítékul szolgálnak a felhasználói prioritásokról, de anekdotikus jellegűek. Egy bejegyzés nem bizonyítja, hogy egy modell objektíven jobb minden felhasználó számára.
Gemini 4 Argon: Lenyelegő pontszámok, de a hozzáférés továbbra is aggodalomra ad okot
Az r/singularity beszélgetésében a Gemini 4 Argon tesztjeiről a felhasználók a Google bejelentett eredményeit vitatták meg a kódolás, a kiberbiztonság és a professzionális feladatok terén.
Az egyik visszatérő kérdés az volt, hogy a modell teljesítménye átültethető-e gyakorlati előnyökké, és mikor válik elérhetővé a szélesebb körű hozzáférés.
Ez hasznos különbségtételt teremt egy összehasonlító cikkben: a tesztekben való vezető szerep nem azonos a mindennapi hasznossággal. A felhasználóknak lehetőségre van szükségük ahhoz, hogy kipróbálhassák a modellt a saját feladataikon, mielőtt eldöntik, érdemes-e bevezetni.
GPT-6 Astra vs Claude Opus 5.5: Minőség, sebesség és használati korlátok
Az Opus 5.5 és a GPT-6 Astra összehasonlításáról szóló r/ClaudeAI beszélgetés jól szemlélteti, milyen gyorsan változhatnak a közösségi preferenciák a modellfrissítések között.
A résztvevők eltérő tapasztalatokról számoltak be a modellekkel kapcsolatban. Egyesek az Astrát részesítették előnyben, míg mások az Opus 5.5 képességeit dicsérték, de kritizálták a néha szükséges útmutatás mennyiségét.
A szélesebb körű tanulság az, hogy a modell minősége részben a feladattól és a felhasználó munkafolyamatától függ. Egy olyan modell, amely jól teljesít egy fejlesztőnél, kevésbé felelhet meg egy másik projekt követelményeinek.
A használati korlátok egy másik aggodalomra okot adó tényezőt jelentenek. Az Opus 5.5 és az Astra közötti választásról szóló Reddit-beszélgetésben egy felhasználó kérdéseket vetett fel a használati keret kimerülésével kapcsolatban, és azzal kapcsolatban, hogy az előfizetések váltása jobb értéket kínálna-e.
Gyakori felhasználók számára a tartós munka költsége legalább annyira számíthat, mint az egyedi válaszok minősége.
Egy egyszerű kreatív feladat is eltérő eredményeket hozhat
Az Opus 5.5, a GPT-6 Astra és más modellek Reddit-összehasonlításában a felhasználók megvitatták, hogy több modellnek ugyanazt az utasítást adták egy rövid papírrepülő-animáció elkészítéséhez.
A válaszok eltérő preferenciákat tükröztek: egyes felhasználók az animáció minőségét részesítették előnyben, míg mások egy másik modell értelmezését vagy kreatív irányát kedvelték.
Ez hasznos emlékeztető arra, hogy a modellek összehasonlítása nem korlátozódik a kódolásra és az érvelésre. A kreatív munkánál a kimenet minősége szubjektív lehet, és a legmegfelelőbb modell a felhasználó által kívánt eredménytől függ.
Mit tanulhatunk a megbeszélésekből?
Ezekben a témákban négy fő szempont emelkedik ki:
- A valós teljesítmény többet számít, mint egy szalagcímbe illő pontszám. A felhasználók olyan modelleket szeretnének, amelyek megoldják a konkrét problémáikat.
- Az utasítások követése befolyásolja a termelékenységet. Egy erős modell akkor hasznosabb, ha pontosítások nélkül megérti a korlátokat.
- A használati korlátok befolyásolják a teljes élményt. A kiváló minőségű eredmények kevésbé értékesek, ha a felhasználók nem tudják fenntartani a munkafolyamatukat.
- A különböző feladatok eltérő erősségeket díjaznak. A kreatív kimenetet, a kódolást, a kutatást és az automatizálást nem szabad ugyanazon kritériumok alapján értékelni.
Ezeknek a megfigyeléseknek a cikkben szereplő teszteket kell megalapozniuk, ahelyett, hogy helyettesítenék azokat.
Hogyan hasonlítható össze a három modell a valós feladatokban?
A leghasznosabb összehasonlítás az lenne, ha mindhárom modellnek ugyanazt a feladatot, ugyanazokat a bemeneti anyagokat és ugyanazokat az értékelési szempontokat adnánk.
Ha mindhárom modell elérhető az Ön számára, a következő tesztek segíthetnek meghatározni, melyik illik a munkafolyamatához.
1. teszt: Kódolás és hibakeresés
Adja meg mindegyik modellnek ugyanazt a kis kódalapot, amely egy reprodukálható hibát tartalmaz. Kérje meg a probléma azonosítására, a javítás végrehajtására, tesztek írására és a változtatások elmagyarázására.
Mérendő szempontok:
- Az eredeti hiba javításra került-e
- A meglévő tesztek továbbra is sikeresek-e
- Keletkeztek-e új hibák
- Hány kiegészítő utasításra van szükség
- Teljes idő és tokenhasználat
Az a modell, amely elfogadható magyarázatot ad, de megbukik a teszteken, nem tekinthető győztesnek.
2. teszt: Kutatás és dokumentumelemzés
Biztosítsa ugyanazt a jelentéskészletet, táblázatokat és forrásdokumentumokat. Kérje meg mindegyik modellt a bizonyítékok összefoglalására, a fontos adatok kinyerésére, az ellentmondások azonosítására és egy rövid, hivatkozásokkal ellátott jelentés elkészítésére.
Mérje a ténybeli pontosságot, az idézetek minőségét, a fontos információk lefedettségét és a szükséges kézi javítások mennyiségét.
Ez a teszt különösen hasznos elemzők, hallgatók, tanácsadók és tartalomgyártó csapatok számára.
3. teszt: Több lépésből álló projekt végrehajtása
Adjon mindegyik modellnek egy olyan feladatot, amely több teljesítendő elemet igényel, mint például egy termékötlet elemzése, projektterv kidolgozása, feladattáblázat készítése és a végső jelentés elkészítése.
Értékelje, hogy követi-e a szükséges sorrendet, fenntartja-e a konzisztenciát az elemek között, és ellenőrzi-e a végeredményt.
Ha a környezet eszközöket biztosít, rögzítse, hogy a modell megfelelően használja-e azokat. Különböztesse meg a modell intelligenciáját az őt futtató platform képességeitől.
4. teszt: Írás és utasítások követése
Adjon meg egy részletes írási vázlatot a célközönséggel, hangnemmel, szükséges pontokkal, terjedelemmel és korlátozásokkal.
Hasonlítsa össze az eredményeket ténybeli pontosság, olvashatóság, szerkezet, eredetiség és a vázlatnak való megfelelés szempontjából.
A marketingcsapatok számára ez megmutathatja, melyik modell készít használható első vázlatokat, és melyik igényel több szerkesztést.
Használjon egységes pontozási keretrendszert
Egy egyszerű, 100 pontos értékelés megkönnyítheti az eredmények összehasonlítását.
| Kritérium | Javasolt súlyozás |
|---|---|
| Pontosság és helyesség | 30 |
| Feladat teljesítése | 25 |
| Utasítások követése | 15 |
| Kimenet minősége | 15 |
| Sebesség és hatékonyság | 10 |
| Költség | 5 |
| Összesen | 100 |
A súlyozásnak a feladattól függően változnia kell. Például a kódolási teszteknél nagyobb hangsúlyt kell fektetni a működő kódra és a sikeres tesztekre, míg a kutatási teszteknél a ténybeli pontosságot és a források minőségét kell előnyben részesíteni.
Ne tegyen közzé pontszámot független tesztként, hacsak nem futtatta le ténylegesen a kísérletet. Ha az Argonhoz való hozzáférés korlátozott, használja a közzétett eredmények világosan megjelölt összehasonlítását, és tartsa fenn a független tesztszekciót azon modellek számára, amelyeket valóban értékelni tud.
Árazási összehasonlítás: Melyik modell kínál jobb értéket?
Az e modellekre közzétett standard API-díjak hasznos kiindulópontot nyújtanak.
| Modell | Bemenet 1M tokenenként | Kimenet 1M tokenenként |
|---|---|---|
| Gemini 4 Argon | 2 $ | 10 $ |
| GPT-6 Astra | 10 $ | 50 $ |
| Claude Opus 5.5 | 4 $ | 20 $ |
Források: Google, OpenAI és Anthropic.
Ezeken a közzétett standard árakon az Argon rendelkezik a legalacsonyabb felsorolt tokenárral, ezt követi az Opus 5.5 és az Astra. Ez azonban nem teszi az Argont automatikusan a legolcsóbb gyakorlati opcióvá minden felhasználó számára, különösen amíg a hozzáférés korlátozott marad.
Példa: Egy 100 000 bemeneti tokent és 20 000 kimeneti tokent használó feladat
Feltételezve, hogy a közzétett árak érvényesek, gyorsítótárazási kedvezmények, eszközdíjak vagy egyéb költségek nélkül:
- Gemini 4 Argon: 0,20 $ bemenet + 0,20 $ kimenet = 0,40 $
- GPT-6 Astra: 1,00 $ bemenet + 1,00 $ kimenet = 2,00 $
- Claude Opus 5.5: 0,40 $ bemenet + 0,40 $ kimenet = 0,80 $
Ez egy tokenköltség-példa, nem pedig az az állítás, hogy a modellek ugyanannyi tokent használnak fel ugyanazon feladat elvégzéséhez.
Az igazságosabb összehasonlítás érdekében számítsa ki egyetlen sikeres eredmény előállításának költségét. Ha az egyik modellnek öt újrapróbálkozásra van szüksége, a másik pedig egyetlen kísérlettel elvégzi a feladatot, a tényleges költségeik jelentősen eltérhetnek a standard tokenár-aránytól.
Az előfizetési csomagok saját árazással, korlátokkal és használati szabályokkal is rendelkeznek. Ne hasonlítsa össze közvetlenül az API-árakat az előfizetési díjakkal, mintha azok egyenértékűek lennének.
Melyik MI-modell a legjobb az Ön igényeinek?
A megfelelő modell attól függ, mit csinál, milyen gyakran használ MI-t, és hogyan néz ki a sikeres eredmény.
Szoftverfejlesztőknek
Fontolja meg a GPT-6 Astra és a Claude Opus 5.5 tesztelését a tényleges kódalapján. Mindkettőt az igényes mérnöki munkára pozicionálják, de relatív teljesítményük a használt nyelvtől, az eszközöktől és a projekt komplexitásától függ majd.
A Gemini 4 Argon-t is érdemes figyelemmel kísérni a bejelentett szoftverfejlesztési eredményei miatt, a hozzáférés és a független ellenőrzés függvényében.
Kutatóknak és elemzőknek
Részesítse előnyben a pontos információkinyerést, a megbízható hivatkozásokat, a hosszú dokumentumok kezelését és a tények feltételezésektől való megkülönböztetésének képességét.
Nagy fájlgyűjteményeket magában foglaló munkáknál tesztelje, hogy a modell megtalálja-e a releváns részleteket anélkül, hogy figyelmen kívül hagyná az ellentmondásos bizonyítékokat.
Tartalomkészítőknek és marketingeseknek
Hasonlítsa össze, mennyire követi az egyes modell a tartalomvázlatot, mennyire tartja fenn a konzekvens hangnemet, hogyan rendszerezi az információkat, és hogy minimális szerkesztést igénylő vázlatokat készít-e.
A gyakorlati munkafolyamat magában foglalhatja a kulcsszókutatást, a vázlatírást, a fogalmazást, a tényellenőrzést és a tartalom adaptálását a különböző célközönségek számára. Az emberi áttekintés továbbra is elengedhetetlen, különösen a ténybeli állítások és a SEO-tartalmak esetében.
Üzleti felhasználóknak
Fókuszáljon a feladatok teljesítésére, a dokumentumelemzésre, a táblázatkezelési munkafolyamatokra, a jelentéskészítésre és a kimenetek megbízhatóságára.
Ismétlődő feladatoknál a kézi áttekintési idő kis mértékű csökkenése is többet számíthat, mint a teszteredmények szerény javulása.
Költségérzékeny felhasználóknak
Hasonlítsa össze a gyakori feladatai elvégzésének tényleges költségét ahelyett, hogy kizárólag a hirdetett intelligencia alapján választana modellt.
Ha egy olcsóbb modell következetesen megfelel az elvárásainak, az jobb mindennapi opció lehet. Tartsa fenn a drágább modelleket azokra a munkákra, ahol azok többletképességei mérhető különbséget jelentenek.
Hogyan fedezheti fel az MI-modelleket és végezhet feladatokat a ChatGOAT AI segítségével
A modellek összehasonlítása hasznos, de az MI valódi előnye abból származik, ha azt a saját munkájára alkalmazza.
A ChatGOAT AI egy MI-munkaterületet biztosít a támogatott modellekhez és eszközökhöz, segítve a felhasználókat az MI-vel támogatott írás, kutatás, elemzés és kreatív munkafolyamatok felfedezésében anélkül, hogy minden feladatot külön kísérletként kellene kezelniük.
Ahol a Gemini 4 Argon, a GPT-6 Astra és a Claude Opus 5.5 engedélyezve van az aktuális ChatGOAT modellválasztóban, a felhasználók felfedezhetik a válaszaikat a platformon belül, és értékelhetik, melyik megközelítés működik a legjobban az igényeiknek. Az elérhetőség modellenként és integrációnként eltérő lehet, ezért a kezdés előtt ellenőrizze az élő modellistát.
Mit tehet az MI segítségével a ChatGOAT AI-on?
Használja az MI-t cikkötletek gyűjtésére, vázlatok készítésére, blogbejegyzések írására, bekezdések átfogalmazására, terjedelmes anyagok összefoglalására vagy a tartalom adaptálására a különböző célközönségek számára.
Egy SEO-szakértő például kidolgozhat egy blogvázlatot, megírhat egy összehasonlító cikket, előkészíthet GYIK-válaszokat, és felülvizsgálhatja a tartalmat a világosság és a keresési szándék szempontjából.
Információk és dokumentumok elemzése
Az MI segíthet kinyerni a főbb pontokat a megadott anyagokból, összehasonlítani a jelentéseket, rendszerezni a kutatási megállapításokat, és a strukturálatlan jegyzeteket világosabb összefoglalóvá alakítani.
Egy üzleti felhasználó például az megbeszélések jegyzeteit akciótervvé alakíthatja, összehasonlító táblázatot készíthet, és tömör vezetői összefoglalót állíthat össze.
Strukturált táblázatok és projekttervek készítése
Használja az MI-t termék-összehasonlítások rendszerezésére, feladatlisták készítésére, kutatási mátrixok építésére és strukturált projekttervek létrehozására.
Egy marketingcsapat használhatja ezt a munkafolyamatot a versenytársak funkcióinak összehasonlítására, a kulcsszavak céloldalakhoz való hozzárendelésére és a tartalomnaptár rendszerezésére.
Kódolás és problémamegoldás támogatása
A támogatott kódolási munkafolyamatoknál az MI elmagyarázhatja az ismeretlen kódot, hibakeresési lépéseket javasolhat, funkciókat írhat, és segíthet a technikai dokumentáció rendszerezésében.
Mindig tesztelje a generált kódot és tekintse át a módosításokat, mielőtt éles környezetben használná azokat.
A ChatGOAT AI képgenerálási képességeket is biztosít a támogatott képes eszközein és modelljein keresztül. Ezek segíthetnek a felhasználóknak illusztrációk, vizuális koncepciók, közösségi média grafikák és egyéb kreatív elemek létrehozásában.
A képgenerálás különálló képesség a szöveges modellek érvelésétől. Ne feltételezze, hogy az összehasonlításban szereplő minden modell képes közvetlenül képeket generálni csak azért, mert a munkaterület tartalmaz képes eszközöket.
Hatékonyabb munkafolyamat kiépítése
Ahelyett, hogy minden feladatot elszigetelt utasításként kezelnének, a felhasználók lépésekre bonthatják a projektet: kutatás, tervezés, fogalmazás, ellenőrzés és végső átadás.
A leghasznosabb munkafolyamat az, amely pontos eredményeket hoz kevesebb ismétlődő munkával – nem feltétlenül az, amelyik a legfejlettebb modellt használja minden egyes lépéshez.
Fedezze fel a ChatGOAT AI-t az aktuálisan támogatott modellek és a munkafolyamatához elérhető MI-eszközök megtekintéséhez.
GYIK
Jobb a Gemini 4 Argon, mint a GPT-6 Astra?
Nem minden helyzetben. A Google erős eredményekről számolt be az Argon esetében válogatott mérnöki és professzionális munkateszteken, míg az OpenAI erős eredményeket tett közzé az Astra esetében számos igényes értékelésen. A hozzáférési korlátozások és a tesztelési módszerek eltérései miatt korai lenne univerzális rangsorról beszélni.
Jobb a Claude Opus 5.5, mint a GPT-6 Astra a kódolásban?
Mindkettőt az igényes szoftverfejlesztési feladatokra tervezték. A jobb opció a kódalaptól, a programozási nyelvtől, az elérhető eszközöktől és a végső megvalósítás minőségétől függ. Hasonlítsa össze a tesztek sikeres teljesítési arányát, a regressziós kockázatokat, az iterációk számát és a teljes költséget ugyanazon a feladaton.
Melyik modell a legjobb az összetett érveléshez?
A GPT-6 Astra és a Gemini 4 Argon egyaránt az összetett érvelésre és a több lépésből álló munkára van pozicionálva, míg a Claude Opus 5.5-öt az igényes professzionális és ágens-munkafolyamatokhoz tervezték. Használjon feladatspecifikus teszteket annak meghatározására, hogy melyik modell teljesít a legjobban az Ön igényeinek megfelelően.
Melyik modell a legolcsóbb?
A fent felsorolt standard közzétett API-díjak alapján a Gemini 4 Argon rendelkezik a legalacsonyabb tokenárral, ezt követi a Claude Opus 5.5 és a GPT-6 Astra. Az Argon korlátozott elérhetősége azonban befolyásolja, hogy a legtöbb felhasználó ténylegesen ki tudja-e használni ezt az árazást. A teljes feladatköltség a tokenhasználattól, az újrapróbálkozásoktól, a gyorsítótárazástól és az eszközöktől is függ.
Használhatom a Gemini 4 Argon-t most azonnal?
A Google kezdetben a Fairwind Programon keresztül jelentette be az Argont a megbízható kiberbiztonsági védők számára, szélesebb körű hozzáféréssel a tervek szerint. Ellenőrizze a Google legújabb hivatalos bejelentését az elérhetőség változásaival kapcsolatban, mielőtt egy projektnél hagyatkozna rá.
Összehasonlíthatom ezeket a modelleket a ChatGOAT AI-on?
Felfedezheti az aktuális ChatGOAT AI munkaterület által támogatott modelleket és eszközöket. Mindhárom közvetlen összehasonlításához ellenőrizze, hogy a Gemini 4 Argon, a GPT-6 Astra és a Claude Opus 5.5 egyaránt elérhető-e a jelenlegi modellválasztóban. Ha valamelyik nem érhető el, hasonlítsa össze a közzétett dokumentációját az elérhető modellekből származó gyakorlati eredményekkel.
Melyik modell a legjobb a mindennapi munkához?
Nincs univerzális válasz. Vegye figyelembe a leggyakrabban végzett feladatokat, az eredmények elvárt pontosságát, a szükséges szerkesztés mennyiségét, a költségkeretét és a preferált platform használati korlátait. Néhány reprezentatív feladat tesztelése hasznosabb, mint kizárólag a hírnév alapján választani.
Végső ítélet: Válassza azt a modellt, amely a legjobban elvégzi a munkáját
A Gemini 4 Argon, a GPT-6 Astra és a Claude Opus 5.5 különböző megközelítéseket képviselnek a fejlett MI-támogatás terén. Az Argon erősségeket jelentett a válogatott mérnöki és professzionális munkák értékelésében, az Astra az igényes érvelési és számítógép-használati feladatokat célozza meg, míg az Opus 5.5 a kódoló ágensekre és a hosszan futó professzionális munkafolyamatokra összpontosít.
A legjobb modell nem feltétlenül az, amelyik a legmagasabb pontszámmal vagy a legdrágább API-val rendelkezik. Az a modell a legjobb, amely megbízhatóan teljesíti a feladatait, követi az utasításait, illeszkedik a költségkeretébe, és a legkevesebb felesleges beavatkozást igényli.
Használja a hivatalos teljesítményteszteket a lehetőségek szűkítésére, a Reddit-beszélgetéseket a valódi felhasználók által feltett kérdések megértésére, és a következetes gyakorlati teszteket a végső döntés meghozatalához.
A ChatGOAT AI segítségével felfedezheti a támogatott MI-modelleket és eszközöket az íráshoz, kutatáshoz, elemzéshez és kreatív munkához egyetlen munkaterületen. Kezdje egy olyan feladattal, amelyet ténylegesen el kell végeznie, hasonlítsa össze az eredmények minőségét, és válassza azt a munkafolyamatot, amely megkönnyíti a munkáját.