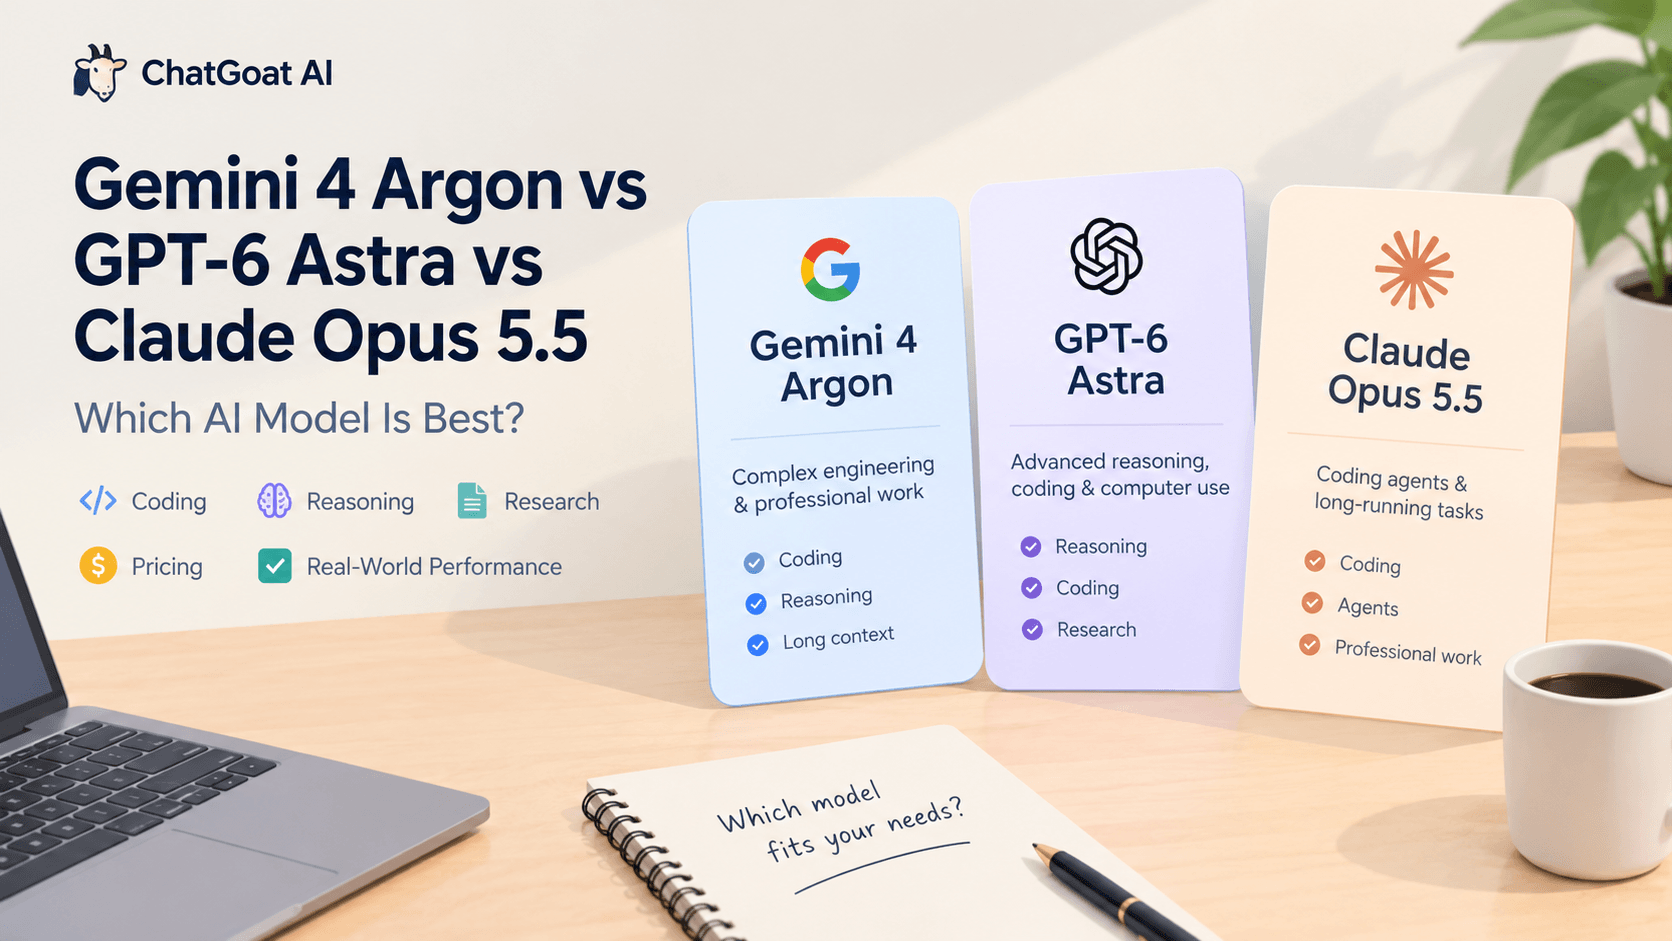
התחרות בין Gemini 4 Argon, GPT-6 Astra, ו-Claude Opus 5.5 מדגישה שינוי חשוב בבינה המלאכותית. המודלים המובילים כיום כבר אינם נשפטים רק לפי מידת ההצלחה שלהם במתן תשובות לשאלות. מפתחים, חוקרים ומשתמשים יומיומיים רוצים כעת בינה מלאכותית שמסוגלת לפתור בעיות מורכבות, להבין פרויקטים גדולים, לכתוב קוד אמין, לנתח מסמכים ולהשלים משימות רב-שלביות עם פחות פיקוח.
לכל מודל יש אוסף שונה של חוזקות. גוגל ממקמת את Gemini 4 Argon סביב הנדסה מורכבת, עבודת ידע מקצועית והגנת סייבר. OpenAI מציגה את GPT-6 Astra כמודל למשימות תובעניות של הסקה, קידוד, מחקר ושימוש במחשב. Anthropic מדגישה את היכולות של Claude Opus 5.5 בהנדסת תוכנה, סוכנים הפועלים לאורך זמן ועבודה מקצועית.
אבל באיזה מודל כדאי לבחור? האם Gemini 4 Argon באמת טוב יותר בקידוד? האם GPT-6 Astra מצדיק את מחיר ה-API הגבוה יותר שלו? האם Claude Opus 5.5 יכול להשלים פרויקטים מסובכים עם פחות הנחיות?
השוואה זו בוחנת תוצאות מבחני ביצועים (benchmarks) רשמיים, תמחור, זמינות, מקרי שימוש מעשיים ודיונים מ-Reddit. היא גם מסבירה כיצד להעריך מודלים אלה עבור עבודה אמיתית ולחקור זרימות עבודה מבוססות בינה מלאכותית באמצעות ChatGOAT AI.
פסק דין מהיר: Gemini 4 Argon מול GPT-6 Astra מול Claude Opus 5.5
אין מנצח יחיד לכל משימה. הבחירה הטובה ביותר תלויה בעבודה שאתם צריכים להשלים, בתקציב שלכם ובשאלה אם יש לכם גישה למודל דרך הפלטפורמה המועדפת עליכם.
| השוואה | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| מיצוב עיקרי | הנדסה מורכבת וזרימות עבודה מקצועיות | הסקה מתקדמת, קידוד, מחקר ושימוש במחשב | סוכני קידוד ומשימות מקצועיות ארוכות טווח |
| קידוד | תוצאות חזקות במבחני ביצועים נבחרים בהנדסת תוכנה | חזק במשימות קידוד ומשימות טכניות עתירות הסקה | מתוכנן לקידוד מורכב ולזרימות עבודה של סוכנים |
| הסקה | מתוכנן לפתרון בעיות מורכב ורב-שלבי | בנוי להסקה תובענית ולעבודה מקצועית | חזק בהנחיות מורכבות ובעבודה מתמשכת |
| עבודה עם הקשר ארוך (Long-context) | הוכרז על עד מיליון אסימוני פלט (output tokens) | חלון הקשר של 1.05 מיליון אסימונים | זרימות עבודה של סוכנים לאורך זמן ופרויקטים גדולים |
| מחיר קלט API סטנדרטי | $2 למיליון אסימונים | $10 למיליון אסימונים | $4 למיליון אסימונים |
| מחיר פלט API סטנדרטי | $10 למיליון אסימונים | $50 למיליון אסימונים | $20 למיליון אסימונים |
| זמינות | מוגבל בראשיתו למגיני סייבר מהימנים | זמין דרך המוצרים הנתמכים וה-API של OpenAI | זמין דרך פלטפורמות Claude ופלטפורמות מפתחים נתמכות |
מקורות: ההכרזה של גוגל על Gemini 4 Argon, תיעוד המודל GPT-6 Astra של OpenAI, ו-תיעוד Claude Opus של Anthropic.
אין לדרג מודלים אלה על סמך מחיר או מבחן ביצועים יחיד בלבד. מודל שעולה פחות לכל אסימון עשוי לדרוש יותר ניסיונות חוזרים כדי לסיים משימה, בעוד שמודל עם ציון מרשים במבחני ביצועים עשוי שלא להיות נגיש למשתמש הממוצע.
המסקנה המעשית: השוו את איכות התוצאה הסופית, הזמן הנדרש, מספר התיקונים והעלות בפועל של השלמת המשימה שלכם.
Gemini 4 Argon: בנוי להנדסה מורכבת ולעבודת ידע
גוגל הכריזה על Gemini 4 Argon ב-30 בספטמבר 2026, וממצבת אותו כמודל חזיתי (frontier model) עבור הנדסת תוכנה בעולם האמיתי, עבודת ידע ארגונית והגנת סייבר.
בניגוד למודל המיועד בעיקר לשיחות יומיומיות, Argon מוצג כמערכת המסוגלת להתמודד עם משימות ארוכות ומקושרות הדדית. משימות אלה עשויות לכלול בחינת מידע טכני נרחב, זיהוי בעיות, תכנון רצף פעולות והפקת תוצאה סופית.
חוזקות מרכזיות
הנדסת תוכנה מורכבת
Argon הציג תוצאות חזקות במבחני ביצועים נבחרים בהנדסת תוכנה. ההכרזה של גוגל מדגישה משימות הנדסיות לאופק ארוך, שבהן מערכת בינה מלאכותית חייבת לשמור על ההקשר בזמן שהיא עובדת על בעיה מסובכת.
יישומים פוטנציאליים כוללים סקירת בסיס קוד (codebase) גדול, זיהוי המקור לתקלה (bug), תכנון מיגרציה והערכה אם השינויים המוצעים פותרים את הבעיה המקורית.
מחקר מקצועי וניתוח מסמכים
גוגל מדגישה גם עבודת ידע משפטית, פיננסית וארגונית אחרת. הדבר הופך משימות עתירות מסמכים לתחום חשוב להערכה, במיוחד כאשר המודל חייב לחבר מידע בין מספר קבצים.
לדוגמה, אנליסט עסקי יכול להשתמש בזרימת עבודה של בינה מלאכותית כדי לסכם דוחות, לחלץ נתונים פיננסיים, להשוות הנחות ולהכין תדרוך מובנה לסקירה אנושית.
פלט ארוך (Long-form output)
גוגל הכריזה על מגבלת פלט מרבית של עד מיליון אסימונים עבור Argon. זוהי מכסת פלט, ולא אותו דבר כמו חלון הקשר (context window). ההבחנה חשובה בעת השוואת מודלים מכיוון שכמות המידע שמודל יכול לקבל וכמות המידע שהוא יכול לייצר הן יכולות שונות.
מהן המגבלות?
המגבלה המעשית הגדולה ביותר היא הגישה. במועד ההכרזה, גוגל השיקה את Argon למגיני סייבר מהימנים דרך תוכנית Fairwind שלה, כאשר זמינות רחבה יותר מתוכננת לשלב מאוחר יותר.
פירוש הדבר הוא שאין להתייחס לתוצאות המפורסמות ככאלה שניתן לשחזר באופן עצמאי ואוטומטי על ידי משתמשים רגילים.
כמו כן, ציון גבוה במבחן ביצועים אינו מוכיח ש-Argon יעלה בביצועיו על מודלים אחרים בכל שפת תכנות, משימת מחקר או פרויקט בעולם האמיתי.
לרקע נוסף, ראו ההכרזה הרשמית של גוגל על Gemini 4 Argon.
GPT-6 Astra: הסקה מתקדמת, קידוד ושימוש במחשב
OpenAI מתארת את GPT-6 Astra כמודל שלה למשימות מקצועיות תובעניות, כולל הסקה מורכבת, פיתוח תוכנה, מחקר, יצירת מסמכים ושימוש במחשב.
ערכו אינו מוגבל להפקת תשובה טובה בחילופי דברים יחידים. עבור זרימות עבודה מתאימות, המטרה היא להסיק דרך בעיה, להשתמש בכלים זמינים ולפעול לקראת תוצאה מוגדרת בבירור.
חוזקות מרכזיות
הסקה מתקדמת
GPT-6 Astra מיועד לבעיות הדורשות יותר מאחזור עובדה או יצירת תגובה קצרה. ניתן להעריך אותו בהסקה מתמטית, תכנון, שאלות טכניות מורכבות ומשימות המעורבות באילוצים מרובים.
לדוגמה, מנהל מוצר יכול לבקש ממנו להשוות בין אסטרטגיות מוצר מתחרות, לזהות סיכונים, לבנות מסגרת לקבלת החלטות ולהפיק תוכנית יישום.
פיתוח תוכנה וניפוי שגיאות (Debugging)
Astra יכול לעזור למפתחים לייצר קוד, לבדוק יישומים קיימים, לאבחן שגיאות ולעבוד דרך משימות הנדסיות מסובכות יותר.
בדיקות שימושיות כוללות ניפוי שגיאות בפרויקט לא מוכר, שינוי קבצים מרובים, יצירת בדיקות יחידה (unit tests) ואימות שלפיו היישום הסופי עונה על הדרישות.
שימוש במחשב וזרימות עבודה של סוכנים
OpenAI מתעדת גם יכולות הקשורות לשימוש במחשב. עם זאת, אוטומציה בפועל תלויה בכלים, בהרשאות ובאמצעי ההגנה שמספקת הסביבה שבה המודל פועל.
יכולתו של מודל לתכנן משימה אינה אומרת שכל ממשק צ'אט מאפשר לו באופן אוטומטי לגלוש באתרי אינטרנט, להפעיל יישומים או להריץ קוד.
מהן המגבלות?
ל-GPT-6 Astra יש מחיר אסימוני API סטנדרטי גבוה יותר משני המודלים האחרים בהשוואה זו. התעריפים המפורסמים שלו הם $10 למיליון אסימוני קלט ו-$50 למיליון אסימוני פלט, לפני הנחות מטמון (caching), עמלות כלים וחיובים אחרים.
עבור משתמשים המנהלים שיחות ארוכות רבות או זרימות עבודה אוטומטיות גדולות, העלויות יכולות להצטבר במהירות.
לפיכך, יש להעריך את המודל לפי איכות העבודה שהושלמה, ולא רק לפי האינטליגנציה הגולמית שלו. אם חלופה זולה יותר מפיקה תוצאות אמינות במידה שווה עבור משימה שגרתית, ייתכן שלא יהיה צורך לשלם עבור המודל היקר יותר.
קראו עוד ב-תיעוד ה-GPT-6 Astra של OpenAI.
Claude Opus 5.5: סוכני קידוד ומשימות ארוכות טווח
Claude Opus 5.5 ממוצב סביב הנדסת תוכנה תובענית, זרימות עבודה של סוכנים הפועלים לאורך זמן ועבודה מקצועית. המשיכה שלו עבור מפתחים רבים היא האפשרות להאציל משימה מסובכת תוך שמירה על הדרישות המקוריות לאורך כל התהליך.
זה חשוב במיוחד כאשר פרויקט כולל מספר קבצים, תלויות מרובות או רצף ארוך של החלטות.
חוזקות מרכזיות
הבנת בסיס הקוד (Codebase)
מודל קידוד שימושי חייב להבין כיצד חלקים שונים של פרויקט מקיימים אינטראקציה. עליו להיות מסוגל לזהות את הגורם לתקלה, לקבוע אילו קבצים זקוקים לשינויים ולהימנע מהכנסת רגרסיות במקומות אחרים.
Claude Opus 5.5 הוא מועמד חזק להערכה עבור זרימות עבודה אלה, במיוחד כאשר המשימה דורשת תשומת לב מתמשכת למבנה הפרויקט ולדרישותיו.
הנחיות מורכבות וכתיבה
משימות מקצועיות רבות כוללות הנחיות מפורטות שלא ניתן לצמצם לשאלה בודדת. משתמש עשוי להגדיר קהל יעד, טון, אילוצים טכניים, כללי עיצוב ורשימה של תוצרים נדרשים.
ניתן להעריך את Claude לפי המידה שבה הוא עוקב אחר אילוצים אלה, שומר על עקביות ומפיק עבודה הדורשת עריכה מינימלית.
זרימות עבודה של סוכנים לאורך זמן
עבור צוותי פיתוח, סוכן בינה מלאכותית עשוי להצטרך לבדוק פרויקט, לבצע שינויים, להריץ בדיקות, לפרש שגיאות ולעדכן את היישום שלו.
מספר השלבים שהושלמו בהצלחה הוא לרוב משמעותי יותר מאיכות התגובה הראשונה.
מהן המגבלות?
מודל בעל יכולות עדיין יכול לסבך משימה יתר על המידה, להניח הנחות שגויות או לצרוך מכסות שימוש ניכרות במהלך הפעלה ארוכה.
גם מגבלות גישה וכללי מנוי חשובים. דיונים בקהילה מזכירים תכופות מגבלות שימוש, אפילו כאשר המשתמשים מרוצים מאיכות המודל.
תעריפי ה-API הסטנדרטיים המפורסמים של Claude Opus 5.5 הם $4 למיליון אסימוני קלט ו-$20 למיליון אסימוני פלט. אלה נמוכים מהתעריפים הסטנדרטיים של Astra, אם כי העלות בפועל תלויה בדפוסי השימוש, ב-caching ובשירותים נוספים.
ראו את תיעוד Claude Opus הרשמי של Anthropic לקבלת מידע עדכני על המוצר והתמחור.
מה בעצם מבחני הביצועים מספרים לנו?
ציוני מבחני ביצועים שימושיים להבנת יכולות המודל, אך הם אינם מספרים את הסיפור המלא.
בדיקות שונות מודדות כישורים שונים. מודל שפועל היטב במבחן ביצועים ארוך בהנדסת תוכנה עשוי שלא להיות הבחירה הטובה ביותר למחקר עובדתי, כתיבה או ניתוח חזותי.
ההכרזה על Argon של גוגל ותוצאות ההערכה המפורסמות של GPT-6 Astra מספקות מספר נקודות השוואה שימושיות.
תוצאות מבחני ביצועים נבחרים בקידוד
| מבחן ביצועים (Benchmark) | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | כ-78% | 74.1% | כ-74% |
| FrontierSWE v2 | ראו את ההערכה המפורסמת של גוגל | יתרון מדווח בהשוואות הזמינות | ראו את ההערכה המפורסמת של גוגל |
| Terminal-Bench 4.0 | ראו את ההערכה המפורסמת של גוגל | 57.9% בתוצאות המפורסמות של OpenAI | ייתכן שחלות תוצאות הערכה שונות |
מקורות: ההכרזה על Argon של גוגל, תיעוד מודל Astra של OpenAI, ו-השוואת אוקטובר 2026 בין Argon למתחריו.
חשוב: יש להתייחס לנתונים אלה כתוצאות מדווחות, ולא כהשוואה עצמאית מבוקרת לחלוטין. התוצאות עשויות להשתנות לפי גרסת המודל, סביבת הבדיקה, הגישה לכלים, הגדרות ההסקה ותאריך ההערכה. במקום שבו המקורות המקוריים אינם קובעים נתון ניתן להשוואה ישירה, הטבלה נמנעת במכוון מלהמציא כזה.
התוצאות הזמינות מדגישות גם מדוע דירוג אוניברסלי הוא מטעה. מדווח כי Argon מוביל ב-DeepSWE v1.1, בעוד ש-Astra ו-Opus עשויים להציג ביצועים שונים בהערכות הנדסת תוכנה אחרות.
גישה טובה יותר היא לשאול איזה מבחן ביצועים דומה לעומס העבודה בפועל שלכם.
- עבור תחזוקת קוד, תנו עדיפות למשימות מאגר (repository) אמיתיות ולשיעורי מעבר בדיקות.
- עבור מחקר, מדדו דיוק עובדתי ואם ציטוטי המקורות תומכים בטענות.
- עבור זרימות עבודה של סוכנים, מדדו השלמה מקצה לקצה והתאוששות משגיאות.
- עבור כתיבה עסקית, העריכו דיוק, מילוי הנחיות וזמן עריכה.
מבחן הביצועים הוא נקודת התחלה. המשימה שלכם היא המבחן הסופי.
מה אומרים משתמשי Reddit על המודלים האלה?
Reddit מספקת זווית ראייה שונה מההכרזות הרשמיות. משתמשים דנים בחלקי ביצועי המודל שבהם הם מבחינים במהלך עבודה יומיומית, כולל איכות קוד, יצירתיות, מהירות, מגבלות שימוש וכמות ההדרכה שמודל זקוק לה.
דיונים אלה הם ראיה שימושית לסדרי העדיפויות של המשתמשים, אך הם אנקדוטיים. פוסט אינו קובע שמודל אחד טוב יותר באופן אובייקטיבי עבור כל משתמש.
Gemini 4 Argon: ציונים מרשימים, אך הגישה נותרה דאגה
ב-דיון ב-r/singularity על מבחני הביצועים של Gemini 4 Argon, משתמשים דנו בתוצאות המדווחות של גוגל בתחומי הקידוד, אבטחת הסייבר ומשימות מקצועיות.
שאלה חוזרת ונשנית אחת הייתה האם ביצועי המודל יתורגמו ליתרונות מעשיים ומתי תהיה זמינה גישה רחבה יותר.
זה יוצר הבחנה שימושית עבור מאמר השוואה: הובלה במבחני ביצועים אינה זהה לשימושיות יומיומית. משתמשים זקוקים לדרך לבחון את המודל במשימות שלהם לפני שהם מחליטים אם כדאי לאמץ אותו.
GPT-6 Astra מול Claude Opus 5.5: איכות, מהירות ומגבלות שימוש
ה-דיון ב-r/ClaudeAI המשווה בין Opus 5.5 ל-GPT-6 Astra המדגים עד כמה מהר יכולות העדפות הקהילה להשתנות בין גרסאות מודל.
משתתפים תיארו חוויות שונות עם המודלים. חלקם העדיפו את Astra, בעוד שאחרים שיבחו את היכולות של Opus 5.5 אך מתחו ביקורת על כמות ההדרכה שנאלצו לפעמים לספק.
הלקח הרחב יותר הוא שאיכות המודל תלויה בחלקה במשימה ובזרימת העבודה של המשתמש. מודל שפועל היטב עבור מפתח אחד עשוי להיות פחות מתאים לדרישות של פרויקט אחר.
מגבלות שימוש הן דאגה נוספת. ב-דיון ב-Reddit על הבחירה בין Opus 5.5 ל-Astra, משתמש העלה שאלות לגבי התרוקנות מכסת השימוש והאם החלפת מנויים תציע תמורה טובה יותר.
עבור משתמשים תכופים, העלות של עבודה מתמשכת יכולה להיות חשובה לא פחות מאיכות התגובות הבודדות.
משימה יצירתית פשוטה יכולה להניב תוצאות שונות
ב-השוואה ב-Reddit בין Opus 5.5, GPT-6 Astra ומודלים אחרים, משתמשים דנו במתן אותה הנחיה (prompt) למספר מודלים ליצירת אנימציה קצרה של מטוס נייר.
התגובות שיקפו העדפות שונות: חלק מהמשתמשים העדיפו את איכות האנימציה, בעוד שאחרים העדיפו את הפרשנות או הכיוון היצירתי של מודל אחר.
זוהי תזכורת שימושית לכך שהשוואות מודלים אינן מוגבלות לקידוד ולהסקה. עבור עבודה יצירתית, איכות הפלט יכולה להיות סובייקטיבית, והמודל המתאים ביותר תלוי בתוצאה שהמשתמש רוצה.
מה נוכל ללמוד מהדיונים?
לאורך שרשורים אלה, בולטים ארבעה נושאים:
- ביצועים בעולם האמיתי חשובים יותר מציון בכותרת. משתמשים רוצים מודלים שפותרים את הבעיות הספציפיות שלהם.
- מילוי הנחיות משפיע על הפרודוקטיביות. מודל חזק מועיל יותר כשהוא מבין אילוצים ללא צורך בהבהרות חוזרות ונשנות.
- מגבלות שימוש משפיעות על החוויה הכוללת. תוצאות באיכות גבוהה הן בעלות ערך נמוך יותר אם משתמשים אינם יכולים לתחזק את זרימת העבודה שלהם.
- משימות שונות מתגמלות חוזקות שונות. פלט יצירתי, קידוד, מחקר ואוטומציה אינם אמורים להיבחן באותן אמות מידה.
תובנות אלה אמורות להנחות את הבדיקות במאמר זה, ולא להחליף אותן.
כיצד להשוות בין שלושת המודלים במשימות בעולם האמיתי
ההשוואה השימושית ביותר תיתן לכל שלושת המודלים את אותה המשימה, אותם חומרי הקלט ואותן אמות מידה להערכה.
אם כל שלושת המודלים זמינים עבורכם, הבדיקות הבאות יכולות לעזור לקבוע איזה מהם מתאים לזרימת העבודה שלכם.
בדיקה 1: קידוד וניפוי שגיאות
תוו לכל מודל את אותו בסיס קוד קטן המכיל תקלה שניתן לשחזר. בקשו ממנו לזהות את הבעיה, ליישם תיקון, לכתוב בדיקות ולהסביר את השינויים.
מדדו:
- האם התקלה המקורית תוקנה
- האם בדיקות קיימות עדיין עוברות
- האם הוכנסו תקלות חדשות
- כמה הנחיות הבהרה (follow-up prompts) נדרשות
- סך הכל זמן ושימוש באסימונים
מודל שמפיק הסבר שנשמע הגיוני אך נכשל בבדיקות אינו אמור להיחשב למנצח.
בדיקה 2: מחקר וניתוח מסמכים
ספקו את אותה ערכה של דוחות, טבלאות ומסמכי מקור. בקשו מכל מודל לסכם את הראיות, לחלץ נתונים חשובים, לזהות סתירות ולהכין דוח קצר עם הפניות.
מדדו דיוק עובדתי, איכות ציטוטים, כיסוי מידע חשוב וכמות התיקונים הידניים הנדרשת.
בדיקה זו שימושית במיוחד עבור אנליסטים, סטודנטים, יועצים וצוותי תוכן.
בדיקה 3: ביצוע פרויקט רב-שלבי
תנו לכל מודל משימה הדורשת מספר תוצרים, כגון ניתוח רעיון למוצר, פיתוח תוכנית פרויקט, יצירת טבלת משימות והכנת דוח סופי.
העריכו אם הוא עוקב אחר הרצף הנדרש, שומר על עקביות בין התוצרים ובודק את התוצאה הסופית.
אם הסביבה מספקת כלים, רשמו אם המודל משתמש בהם נכון. הפידו להפריד בין האינטליגנציה של המודל לבין היכולות של הפלטפורמה שמריצה אותו.
בדיקה 4: כתיבה ומילוי הנחיות
ספקו בריף כתיבה מפורט עם קהל יעד, טון, נקודות נדרשות, אורך ומגבלות.
השוו את התוצאות מבחינת דיוק עובדתי, קריאות, מבנה, מקוריות ועמידה בדרישות הבריף.
עבור צוותי שיווק, הדבר יכול לחשוף איזה מודל מפיק טיוטות ראשונות שניתן להשתמש בהן ואיזה דורש עריכה רבה יותר.
השתמשו במסגרת דירוג עקבית
הערכה פשוטה של 100 נקודות יכולה להקל על השוואת התוצאות.
| קריטריון | משקל מוצע |
|---|---|
| דיוק ונכונות | 30 |
| השלמת המשימה | 25 |
| מילוי הנחיות | 15 |
| איכות הפלט | 15 |
| מהירות ויעילות | 10 |
| עלות | 5 |
| סך הכל | 100 |
המשקלים אמורים להשתנות בהתאם למשימה. לדוגמה, בדיקות קידוד צריכות לשים דגש רב יותר על קוד עובד ומעבר בדיקות, בעוד שבדיקות מחקר צריכות לתת עדיפות לדיוק עובדתי ולאיכות המקורות.
אל תפרסמו ציון כבדיקה עצמאית אלא אם כן ביצעתם בפועל את הניסוי. אם הגישה ל-Argon מוגבלת, השתמשו בהשוואה מסומנת בבירור של תוצאות מפורסמות ושמרו את סעיף הבדיקה העצמאית למודלים שאתם יכולים להעריך באופן אמיתי.
השוואת תמחור: איזה מודל מציע תמורה טובה יותר?
תעריפי ה-API הסטנדרטיים המפורסמים עבור מודלים אלה מספקים נקודת התחלה שימושית.
| מודל | קלט למיליון אסימונים | פלט למיליון אסימונים |
|---|---|---|
| Gemini 4 Argon | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
מקורות: גוגל, OpenAI, ו-Anthropic.
בתעריפים סטנדרטיים מפורסמים אלה, ל-Argon יש את מחיר האסימונים הרשום הנמוך ביותר, ואחריו Opus 5.5 ו-Astra. עם זאת, הדבר אינו הופך את Argon באופן אוטומטי לאפשרות המעשית הזולה ביותר עבור כל משתמש, במיוחד כל עוד הגישה נותרה מוגבלת.
דוגמה: משימה המשתמשת ב-100,000 אסימוני קלט ו-20,000 אסימוני פלט
בהנחה שהתעריפים המפורסמים חלים, ללא הנחות מטמון (caching), עמלות כלים או חיובים אחרים:
- Gemini 4 Argon: $0.20 קלט + $0.20 פלט = $0.40
- GPT-6 Astra: $1.00 קלט + $1.00 פלט = $2.00
- Claude Opus 5.5: $0.40 קלט + $0.40 פלט = $0.80
זוהי דוגמה עלות-אסימונים, ולא טענה שהמודלים משתמשים באותו מספר אסימונים כדי לסיים את אותה המשימה.
להשוואה הוגנת יותר, חשבו את העלות של הפקת תוצאה מוצלחת אחת. אם מודל אחד זקוק לחמישה ניסיונות חוזרים ואחר משלים את המשימה בניסיון אחד, העלויות האפקטיביות שלהם עשויות להיות שונות באופן משמעותי מיחס מחירי האסימונים הסטנדרטי.
לתוכניות מנוי יש גם תמחור, מגבלות וכללי שימוש משלהן. אל תשוו מחירי API ישירות לדמי מנוי כאילו היו שווי ערך.
איזה מודל בינה מלאכותית הוא הטוב ביותר עבור הצרכים שלכם?
המודל הנכון תלוי במה שאתם עושים, באיזו תדירות אתם משתמשים בבינה מלאכותית ואיך נראית תוצאה מוצלחת.
עבור מפתחי תוכנה
שקלו לבחון את GPT-6 Astra ו-Claude Opus 5.5 על בסיס הקוד בפועל שלכם. שניהם ממוצבים לעבודה הנדסית תובענית, אך הביצועים היחסיים שלהם יתלו בשפה, בכלים ובמורכבות הפרויקט שלכם.
גם על Gemini 4 Argon כדאי לעקוב בשל תוצאות הנדסת התוכנה המדווחות שלו, בכפוף לגישה ולאימות עצמאי.
עבור חוקרים ואנליסטים
תנו עדיפות לחילוץ מידע מדויק, ציטוטים אמינים, טיפול במסמכים ארוכים והיכולת להבחין בין עובדות להנחות.
עבור עבודה המעורבד באוספים גדולים של קבצים, בדקו אם המודל יכול למצוא פרטים רלוונטיים מבלי להתעלם מראיות סותרות.
עבור יוצרי תוכן ואנשי שיווק
השוו עד כמה כל מודל עוקב אחר בריף תוכן, שומר על טון עקבי, מארגן מידע ומפיק טיוטות הדורשות עריכה מינימלית.
זרימת עבודה מעשית עשויה לכלול מחקר מילות מפתח, בניית ראשי פרקים, כתיבת טיוטות, בדיקת עובדות והתאמת תוכן לקהלים שונים. סקירה אנושית נותרה חיונית, במיוחד עבור טענות עובדתיות ותוכן SEO.
עבור משתמשים עסקיים
התמקדו בהשלמת משימות, ניתוח מסמכים, זרימות עבודה של גיליונות אלקטרוניים, דיווח ואמינות הפלטים.
עבור משימות חוזרות ונשנות, אפילו הפחתה קטנה בזמן הסקירה הידנית יכולה להיות חשובה יותר משיפור צנוע בציוני מבחני ביצועים.
עבור משתמשים המודעים לתקציב
השוו את העלות בפועל של השלמת המשימות הנפוצות שלכם במקום לבחור מודל על סמך האינטליגנציה המפורסמת שלו בלבד.
אם מודל פחות יקר עונה בעקביות על הדרישות שלכם, הוא עשוי להיות האפשרות היומיומית הטובה יותר. שמרו מודלים יקרים יותר לעבודה שבה היכולות הנוספות שלהם עושות הבדל מדיד.
כיצד לחקור מודלי בינה מלאכותית ולהשלים משימות ב-ChatGOAT AI
השוואת מודלים היא שימושית, אך היתרון האמיתי של בינה מלאכותית מגיע מיישומה בעבודה שלכם.
ChatGOAT AI מספקת סביבת עבודה של בינה מלאכותית עבור מודלים וכלים נתמכים, ומסייעת למשתמשים לחקור זרימות עבודה של כתיבה, מחקר, ניתוח ויצירה בסיוע בינה מלאכותית מבלי להתייחס לכל משימה כאל ניסוי נפרד.
כאשר Gemini 4 Argon, GPT-6 Astra ו-Claude Opus 5.5 מופעלים בבורר המודלים הנוכחי של ChatGOAT, משתמשים יכולים לחקור את התגובות שלהם בתוך הפלטפורמה ולהעריך איזו גישה עובדת הכי טוב עבור הצרכים שלהם. הזמינות עשויה להשתנות לפי מודל ואינטגרציה, לכן בדקו את רשימת המודלים הפעילה לפני ההתחלה.
מה אפשר לעשות עם בינה מלאכותית ב-ChatGOAT AI?
השתמשו בבינה מלאכותית כדי להעלות רעיונות למאמרים, לבנות ראשי פרקים, לכתוב טיוטות לפוסטים בבלוג, לשכתב פסקאות, לסכם חומרים ארוכים או להתאים תוכן לקהלים שונים.
לדוגמה, מומחה SEO יכול לפתח ראשי פרקים לבלוג, לכתוב טיוטת מאמר השוואה, להכין תשובות לשאלות נפוצות ולערוך את התוכן לבהירות ולכוונת חיפוש.
לנתח מידע ומסמכים
בינה מלאכותית יכולה לסייע לחלץ נקודות מפתח מחומרים שמסופקים, להשוות דוחות, לארגן ממצאי מחקר ולהפוך הערות בלתי מובנות לסיכום ברור יותר.
לדוגמה, משתמש עסקי יכול להפוך הערות לפגישה לתוכנית פעולה, ליצור טבלת השוואה ולהכין תקציר מנהלים תמציתי.
ליצור טבלאות מובנות ותוכניות פרויקט
השתמשו בבינה מלאכותית כדי לארגן השוואות מוצרים, להכין רשימות משימות, לבנות מטריצות מחקר וליצור תוכניות פרויקט מובנות.
צוות שיווק יכול להשתמש בזרימת עבודה זו כדי להשוות תכונות של מתחרים, למפות מילות מפתח לדפי נחיתה ולארגן לוח שנה של תוכן.
לתמוך בקידוד ובפתרון בעיות
עבור זרימות עבודה נתמכות בקידוד, בינה מלאכותית יכולה להסביר קוד לא מוכר, להציע שלבי ניפוי שגיאות, לכתוב טיוטות של פונקציות ולסייע בארגון תיעוד טכני.
תמיד בדקו קוד שנוצר וסקרו שינויים לפני השימוש בהם בסביבת ייצור (production).
ChatGOAT AI מספקת גם יכולות יצירת תמונות בבינה מלאכותית באמצעות כלי התמונות והמודלים הנתמכים שלה. אלה יכולים לסייע למשתמשים ליצור איורים, קונספטים חזותיים, גרפיקה לרשתות חברתיות ונכסים יצירתיים אחרים.
יצירת תמונות היא יכולת נפרדת מהסקה של מודלי טקסט. אל תניחו שכל מודל בהשוואה זו יכול ליצור תמונות באופן ישיר רק משום שסביבת העבודה כוללת כלי תמונות.
לבנות זרימת עבודה יעילה יותר
במקום להתייחס לכל משימה כאל הנחיה (prompt) מבודדת, משתמשים יכולים לחלק פרויקט לשלבים: מחקר, תכנון, כתיבת טיוטה, בדיקה ומסירה סופית.
זרימת העבודה השימושית ביותר היא זו שמפיקה תוצאות מדויקות עם פחות עבודה חזרתית, ולא בהכרח זו שמשתמשת במודל המתקדם ביותר עבור כל שלב.
חקרו את ChatGOAT AI כדי לראות את המודלים והכלים הנתמכים כעת הזמינים עבור זרימת העבודה שלכם.
שאלות נפוצות
האם Gemini 4 Argon טוב יותר מ-GPT-6 Astra?
לא בכל סיטואציה. גוגל דיווחה על תוצאות חזקות עבור Argon במבחני ביצועים נבחרים בהנדסה ובעבודה מקצועית, בעוד OpenAI מפרסמת תוצאות חזקות עבור Astra במספר הערכות תובעניות. מגבלות גישה והבדלים בשיטות הבדיקה הופכים דירוג אוניברסלי למוקדם מדי.
האם Claude Opus 5.5 טוב יותר מ-GPT-6 Astra לקידוד?
שניהם מתוכננים למשימות הנדסת תוכנה תובעניות. האפשרות הטובה יותר תלויה בבסיס הקוד, בשפת התכנות, בכלים הזמינים ובאיכות היישום הסופי. השוו שיעורי מעבר בדיקות, סיכוני רגרסיה, מספר איטרציות ועלות כוללת עבור אותה משימה.
איזה מודל הוא הטוב ביותר להסקה מורכבת?
GPT-6 Astra ו-Gemini 4 Argon ממוצבים שניהם להסקה מורכבת ולעבודה רב-שלבית, בעוד ש-Claude Opus 5.5 מתוכנן לזרימות עבודה מקצועיות ולסוכנים. השתמשו בבדיקות ייעודיות למשימה כדי לקבוע איזה מודל מציג את הביצועים הטובים ביותר עבור הצרכים שלכם.
איזה מודל הוא הזול ביותר?
על סמך תעריפי ה-API הסטנדרטיים المפורסמים הרשומים לעיל, ל-Gemini 4 Argon יש את מחיר האסימונים הנמוך ביותר, ואחריו Claude Opus 5.5 ו-GPT-6 Astra. עם זאת, הזמינות המוגבלת של Argon משפיעה על השאלה אם רוב המשתמשים יכולים במידה מעשית לנצל תמחור זה. העלות הכוללת של המשימה תלויה גם בשימוש באסימונים, בניסיונות חוזרים, ב-caching ובכלים.
האם אני יכול להשתמש ב-Gemini 4 Argon ממש עכשיו?
גוגל הכריזה לראשונה על Argon עבור מגיני סייבר מהימנים דרך תוכנית Fairwind, כאשר זמינות רחבה יותר מתוכננת. בדקו את ההכרזה הרשמית האחרונה של גוגל לגבי שינויים בזמינות לפני שתסתמכו עליו עבור פרויקט.
האם אני יכול להשוות בין מודלים אלה ב-ChatGOAT AI?
תוכלו לחקור מודלים וכלים הנתמכים על ידי סביבת העבודה הנוכחית של ChatGOAT AI. כדי להשוות באופן ישיר בין כל השלושה, ודאו ש-Gemini 4 Argon, GPT-6 Astra ו-Claude Opus 5.5 זמינים כולם בבורר המודלים הנוכחי. אם אחד מהם אינו זמין, השוו את התיעוד المפורסם שלו עם תוצאות מעשיות ממודלים נגישים במקום זאת.
איזה מודל הוא הטוב ביותר לעבודה יומיומית?
אין תשובה אוניברסלית. הובאו בחשבון את המשימות שאתם מבצעים בתדירות הגבוהה ביותר, עד כמה התוצאות צריכות להיות מדויקות, כמות העריכה הנדרשת, התקציב שלכם ומגבלות השימוש של הפלטפורמה המועדפת עליכם. בדיקת מספר משימות מייצגות שימושית יותר מבחירה אך ורק על פי מוניטין.
פסק דין סופי: בחרו את המודל שמשלים את העבודה שלכם על הצד הטוב ביותר
Gemini 4 Argon, GPT-6 Astra ו-Claude Opus 5.5 מייצגים גישות שונות לסיוע מתקדם בבינה מלאכותית. ל-Argon יש חוזקות מדווחות בהערכות נבחרות בהנדסה ובעבודה מקצועית, Astra מתמקד במשימות הסקה ושימוש במחשב תובעניות, ו-Opus 5.5 מתמקד בסוכני קידוד ובזרימות עבודה מקצועיות ארוכות טווח.
המודל הטוב ביותר אינו בהכרח זה עם הציון הגבוה ביותר או ה-API היקר ביותר. זהו המודל שמשלים באופן אמין את המשימות שלכם, עוקב אחר ההנחיות שלכם, מתאים לתקציב שלכם ודורש את מינימום ההתערבות המיותרת.
השתמשו במבחני ביצועים רשמיים כדי לצמצם את האפשרויות שלכם, בדיונים ב-Reddit כדי להבין את השאלות שמשתמשים אמיתיים שואלים, ובבדיקות מעשיות עקביות כדי לקבל את ההחלטה הסופית.
עם ChatGOAT AI, תוכלו לחקור מודלי בינה מלאכותית וכלים נתמכים עבור כתיבה, מחקר, ניתוח ועבודה יצירתית בסביבת עבודה אחת. התחילו במשימה שאתם באמת צריכים להשלים, השוו את איכות התוצאות ובחרו בזרימת העבודה שמקלה על העבודה שלכם.