Kilpailu mallien Gemini 4 Argon, GPT-6 Astra ja Claude Opus 5.5 välillä korostaa tärkeää muutosta tekoälyalalla. Nykyisiä johtavia malleja ei enää arvioida pelkästään sen perusteella, kuinka hyvin ne vastaavat kysymyksiin. Kehittäjät, tutkijat ja tavalliset käyttäjät haluavat tekoälyä, joka pystyy myös ratkaisemaan monimutkaisia ongelmia, ymmärtämään laajoja projekteja, kirjoittamaan luotettavaa koodia, analysoimaan asiakirjoja ja suorittamaan monivaiheisia tehtäviä vähemmällä valvonnalla.
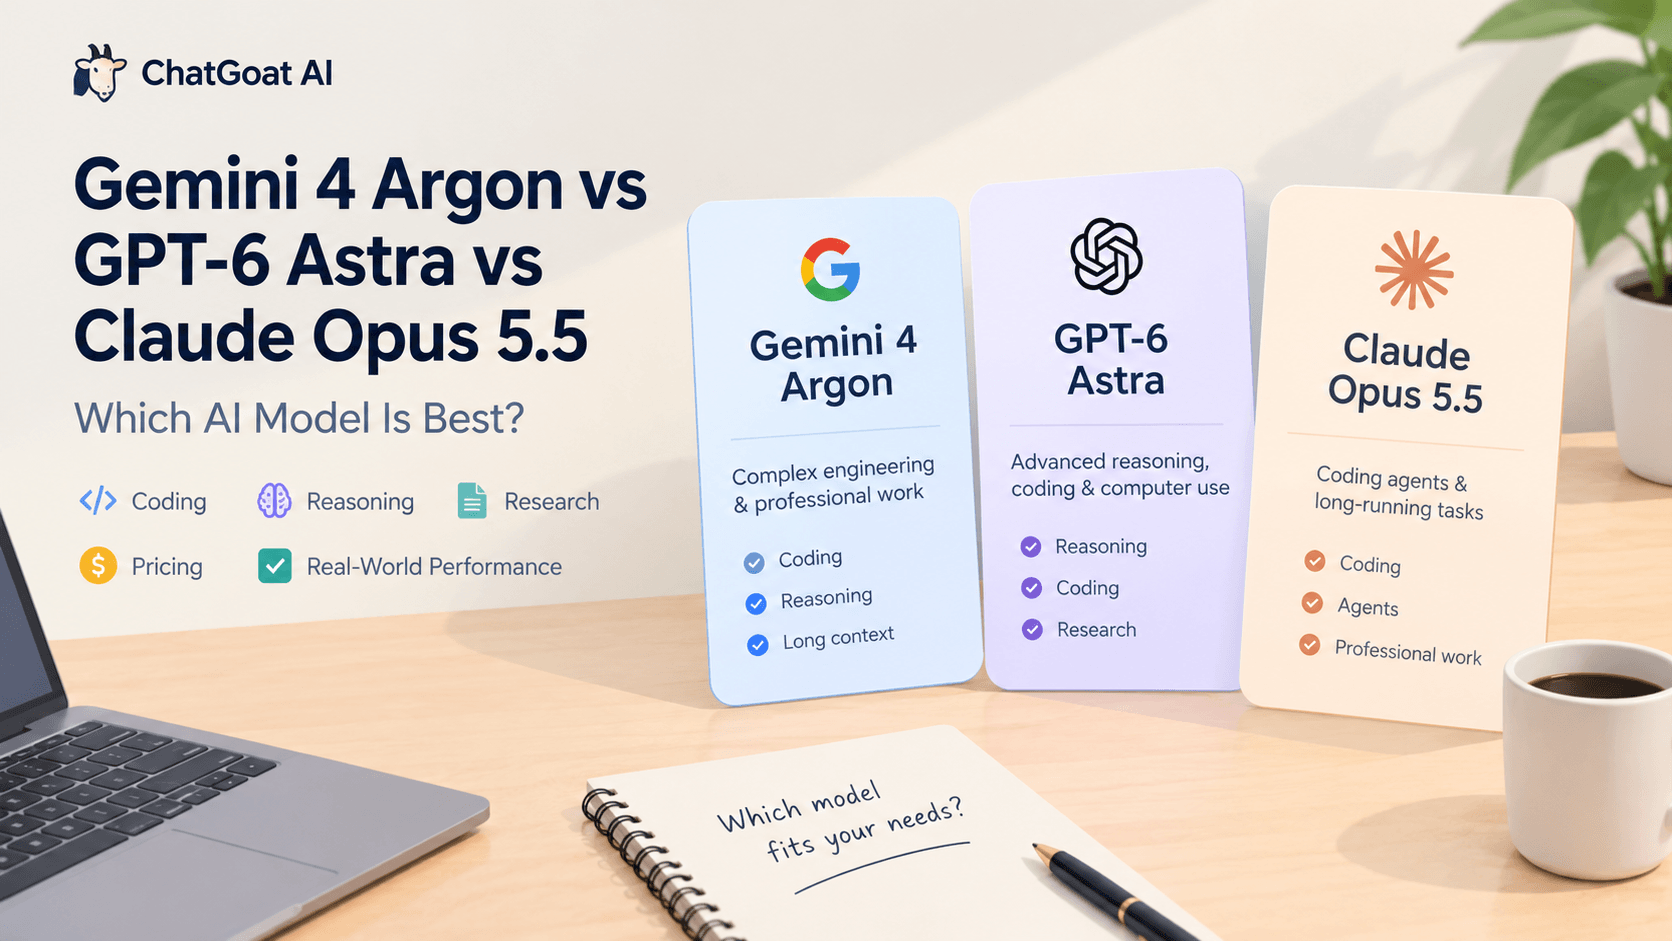
Jokaisella mallilla on omat vahvuutensa. Google asemoi Gemini 4 Argonin monimutkaiseen tekniikkaan, asiantuntijatyöhön ja kyberturvallisuuden puolustukseen. OpenAI esittelee GPT-6 Astran mallina vaativaan päättelyyn, koodaukseen, tutkimukseen ja tietokoneen käyttötehtäviin. Anthropic korostaa Claude Opus 5.5:n suorituskykyä ohjelmistotekniikassa, pitkäkestoisissa agenttitehtävissä ja asiantuntijatyössä.
Mutta mikä malli sinun kannattaisi valita? Onko Gemini 4 Argon todella parempi koodauksessa? Oikeuttaako GPT-6 Astra korkeamman API-hintansa? Pystyykö Claude Opus 5.5 suorittamaan monimutkaisia projekteja vähemmillä ohjeilla?
Tässä vertailussa tarkastellaan virallisia suorituskykytestien (benchmark) tuloksia, hinnoittelua, saatavuutta, käytännön käyttötapauksia ja Reddit-keskusteluja. Siinä selitetään myös, miten näitä malleja voi arvioida todellisessa työssä ja miten tekoälypohjaisia työnkulkuja voi tutkia ChatGOAT AI:n kautta.
Pika-arvio: Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5
Yhtä ainoaa voittajaa jokaiseen tehtävään ei ole. Paras valinta riippuu suoritettavasta työkokonaisuudesta, budjetistasi ja siitä, onko malli saatavilla käyttämäsi alustan kautta.
| Vertailu | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Ensisijainen asemointi | Monimutkainen tekniikka ja ammattimaiset työnkulut | Edistynyt päättely, koodaus, tutkimus ja tietokoneen käyttö | Koodausagentit ja pitkäkestoiset asiantuntijatehtävät |
| Koodaus | Vahvat tulokset valituissa ohjelmistotekniikan suorituskykytesteissä | Vahva paljon päättelyä vaativassa koodauksessa ja teknisissä tehtävissä | Suunniteltu monimutkaiseen koodaukseen ja agenttityönkulkuihin |
| Päättely | Suunniteltu monimutkaiseen, monivaiheiseen ongelmanratkaisuun | Rakennettu vaativaan päättelyyn ja asiantuntijatyöhön | Vahva monimutkaisten ohjeiden noudattamisessa ja pitkäkestoisessa työssä |
| Pitkän kontekstin työskentely | Ilmoitettu jopa 1 miljoonaan tulostustokeniin asti | 1,05 miljoonan tokenin konteksti-ikkuna | Pitkäkestoiset agenttityönkulut ja laajat projektit |
| API-syötteen vakiohinta | 2 $ / miljoona tokenia | 10 $ / miljoona tokenia | 4 $ / miljoona tokenia |
| API-tulosteen vakiohinta | 10 $ / miljoona tokenia | 50 $ / miljoona tokenia | 20 $ / miljoona tokenia |
| Saatavuus | Aluksi rajoitettu luotetuille kyberpuolustajille | Saatavilla OpenAI:n tuettujen tuotteiden ja API:n kautta | Saatavilla tuettujen Claude- ja kehittäjäalustojen kautta |
Lähteet: Googlen ilmoitus Gemini 4 Argonista, OpenAI:n GPT-6 Astra -mallin dokumentaatio ja Anthropican Claude Opus -dokumentaatio.
Näitä malleja ei pitäisi laittaa järjestykseen pelkästään hinnan tai yhden suorituskykytestin perusteella. Malli, joka maksaa vähemmän tokenia kohden, saattaa vaatia enemmän uudelleenyrityksiä tehtävän suorittamiseksi, kun taas vakuuttavan testituloksen saavuttanut malli ei välttämättä ole tavallisen käyttäjän saatavilla.
Käytännön johtopäätös: Vertaa lopputuloksen laatua, tarvittavaa aikaa, korjausten määrää ja tehtävän suorittamisen todellisia kustannuksia.
Gemini 4 Argon: Rakennettu monimutkaiseen tekniikkaan ja asiantuntijatyöhön
Google julkisti Gemini 4 Argonin 30. syyskuuta 2026 ja asemoi sen kärkimalliksi todelliseen ohjelmistotekniikkaan, yritysten asiantuntijatyöhön ja kyberturvallisuuden puolustukseen.
Toisin kuin pääasiassa arkipäiväisiin keskusteluihin suunniteltu malli, Argon esitellään järjestelmänä, joka pystyy käsittelemään pitkiä, toisiinsa kytkeytyviä tehtäviä. Näihin voi sisältyä laajan teknisen tiedon tarkastelua, ongelmien tunnistamista, toimintasarjan suunnittelua ja lopullisen tuloksen tuottamista.
Keskeiset vahvuudet
Monimutkainen ohjelmistotekniikka
Argon on osoittanut vahvoja tuloksia valituissa ohjelmistotekniikan suorituskykytesteissä. Googlen ilmoituksessa korostetaan pitkän aikavälin teknisiä tehtäviä, joissa tekoälyjärjestelmän on säilytettävä konteksti työskennellessään monimutkaisen ongelman parissa.
Mahdollisia käyttökohteita ovat muun muassa laajan koodikannan katselmointi, virheen aiheuttajan tunnistaminen, migraation suunnittelu ja sen arviointi, ratkaisevatko ehdotetut muutokset alkuperäisen ongelman.
Ammattimainen tutkimus ja asiakirja-analyysi
Google korostaa myös juridista, taloudellista ja muuta yritysten asiantuntijatyötä. Tämä tekee runsaasti asiakirjoja sisältävistä tehtävistä tärkeän arviointialueen, etenkin silloin, kun mallin täytyy yhdistää tietoa useista eri tiedostoista.
Esimerkiksi liiketoiminta-analyytikko voisi käyttää tekoälytyönkulkua raporttien yhteenvetämiseen, talouslukujen poimimiseen, oletusten vertailuun ja jäsennellyn katsauksen valmistelemiseen ihmiarviointia varten.
Pitkä muotoinen tuloste
Google ilmoitti Argonin enimmäistulostusrajaksi jopa miljoona tokenia. Tämä on tulostuskiintiö, eikä se ole sama asia kuin konteksti-ikkuna. Ero on tärkeä malleja verrattaessa, koska tiedon määrä, jonka malli voi vastaanottaa, ja tiedon määrä, jonka se voi tuottaa, ovat eri ominaisuuksia.
Mitkä ovat rajoitukset?
Suurin käytännön rajoitus on saatavuus. Julkistushetkellä Google oli tuomassa Argonin luotettavien kyberturvallisuuden puolustajien saataville Fairwind-ohjelmansa kautta, ja laajempi saatavuus on suunniteltu myöhempään vaiheeseen.
Tämä tarkoittaa, ettei julkaistuja tuloksia pitäisi automaattisesti pitää tavallisten käyttäjien riippumattomasti toistettavissa olevina.
Korkea suorituskykytestitulos ei myöskään osoita, että Argon voittaisi muut mallit jokaisessa ohjelmointikielessä, tutkimustehtävässä tai käytännön projektissa.
Lisätietoja löydät Googlen virallisesta Gemini 4 Argon -julkaistusilmoituksesta.
GPT-6 Astra: Edistynyt päättely, koodaus ja tietokoneen käyttö
OpenAI kuvailee GPT-6 Astraa mallikseen vaativiin ammattitehtäviin, kuten monimutkaiseen päättelyyn, ohjelmistokehitykseen, tutkimukseen, asiakirjojen luontiin ja tietokoneen käyttöön.
Sen arvo ei rajoitu hyvän vastauksen tuottamiseen yhdessä viestinvaihdossa. Sopivissa työnkuluissa tavoitteena on päätellä tie ongelman läpi, käyttää käytettävissä olevia työkaluja ja pyrkiä kohti selkeästi määriteltyä tulosta.
Keskeiset vahvuudet
Edistynyt päättely
GPT-6 Astra on tarkoitettu ongelmiin, jotka vaativat enemmän kuin tosiasian hakemista tai lyhyen vastauksen luomista. Sitä voidaan arvioida matemaattisessa päättelyssä, suunnittelussa, monimutkaisissa teknisissä kysymyksissä ja tehtävissä, joihin liittyy useita rajoitteita.
Esimerkiksi tuotepäällikkö voisi pyytää sitä vertailemaan kilpailevia tuotestrategioita, tunnistamaan riskejä, rakentamaan päätöksentekokehyksen ja laatimaan toteutussuunnitelman.
Ohjelmistokehitys ja virheenjäljitys
Astra voi auttaa kehittäjiä luomaan koodia, tarkastelemaan olemassa olevia toteutuksia, diagnosoimaan virheitä ja työskentelemään monimutkaisempien teknisten tehtävien parissa.
Hyödyllisiä testejä ovat muun muassa vieraan projektin virheenjäljitys, useiden tiedostojen muokkaaminen, yksikkötestien luominen ja sen todentaminen, täyttääkö lopullinen toteutus vaatimukset.
Tietokoneen käyttö- ja agenttityönkulut
OpenAI dokumentoi myös tietokoneen käyttöön liittyviä ominaisuuksia. Todellinen automaatio riippuu kuitenkin työkaluista, käyttöoikeuksista ja suojaustoimista, joita mallin suoritusympäristö tarjoaa.
Mallin kyky suunnitella tehtävä ei tarkoita, että jokainen keskustelukäyttöliittymä antaisi sille automaattisesti luvan selata verkkosivustoja, käyttää sovelluksia tai suorittaa koodia.
Mitkä ovat rajoitukset?
GPT-6 Astralla on korkeampi API-tokenien vakiohinta kuin kahdella muulla vertailun mallilla. Sen julkaistut hinnat ovat 10 $ miljoonaa syötteen tokenia kohden ja 50 $ miljoonaa tulosteen tokenia kohden ennen mahdollisia välimuisti-, työkalu- ja muita maksuja.
Käyttäjille, jotka käyvät monia pitkiä keskusteluja tai pyörittävät suuria automaattisia työnkulkuja, kustannukset voivat kertyä nopeasti.
Mallia tulisikin arvioida valmistuneen työn laadun perusteella eikä pelkästään sen puhtaan älykkyyden mukaan. Jos halvempi vaihtoehto tuottaa yhtä luotettavia tuloksia rutiinitehtävässä, kalliimmasta mallista maksaminen ei välttämättä ole tarpeen.
Lue lisää OpenAI:n GPT-6 Astra -dokumentaatiosta.
Claude Opus 5.5: Koodausagentit ja pitkäkestoiset tehtävät
Claude Opus 5.5 on asemoitu vaativaan ohjelmistotekniikkaan, pitkäkestoisiin agenttityönkulkuihin ja asiantuntijatyöhön. Sen vetovoima monille kehittäjille perustuu mahdollisuuteen delegoida monimutkainen tehtävä säilyttäen samalla alkuperäiset vaatimukset koko prosessin ajan.
Tämä on erityisen tärkeää silloin, kun projektiin liittyy useita tiedostoja, useita riippuvuuksia tai pitkä sarja päätöksiä.
Keskeiset vahvuudet
Koodikannan ymmärtäminen
Hyödyllisen koodausmallin on ymmärrettävä, miten projektin eri osat vaikuttavat toisiinsa. Sen pitäisi pystyä tunnistamaan virheen syy, määrittämään muutoksia vaativat tiedostot ja välttämään uusien virheiden aiheuttamista muualle.
Claude Opus 5.5 on vahva ehdokas arvioitavaksi näissä työnkuluissa, etenkin silloin, kun tehtävä vaatii jatkuvaa huomiota projektin rakenteeseen ja vaatimuksiin.
Monimutkaiset ohjeet ja kirjoittaminen
Moniin asiantuntijatehtäviin liittyy yksityiskohtaisia ohjeita, joita ei voi tiivistää yhteen kysymykseen. Käyttäjä voi määrittää kohdeyleisön, äänensävyn, tekniset rajoitteet, muotoilusäännöt ja luettelon vaadituista tuotoksista.
Clauden kohdalla voidaan arvioida, kuinka hyvin se noudattaa näitä rajoitteita, säilyttää johdonmukaisuuden ja tuottaa työtä, joka vaatii mahdollisimman vähän muokkausta.
Pitkäkestoiset agenttityönkulut
Kehitystiimeille tekoälyagentti voi olla tarpeen projektin tarkastamiseen, muutosten tekemiseen, testien suorittamiseen, virheiden tulkitsemiseen ja toteutuksen korjaamiseen.
Onnistuneesti suoritettujen vaiheiden määrä on usein merkitsevämpi kuin ensimmäisen vastauksen laatu.
Mitkä ovat rajoitukset?
Pystyväkin malli voi silti monimutkaistaa tehtävää liikaa, tehdä virheellisiä oletuksia tai kuluttaa merkittävästi käyttökiintiöitä pitkän istunnon aikana.
Myös käyttörajat ja tilaussäännöt vaikuttavat. Yhteisön keskusteluissa mainitaan usein käyttörajat, vaikka käyttäjät olisivatkin tyytyväisiä mallin laatuun.
Claude Opus 5.5:n julkaistut vakio-API-hinnat ovat 4 $ miljoonaa syötteen tokenia kohden ja 20 $ miljoonaa tulosteen tokenia kohden. Nämä ovat alhaisemmat kuin Astran vakiohinnat, vaikka todelliset kustannukset riippuvat käyttötavoista, välimuistista ja lisäpalveluista.
Katso nykyiset tuote- ja hintatiedot Anthropican virallisesta Claude Opus -dokumentaatiosta.
Mitä suorituskykytestit (benchmarkit) todella kertovat meille?
Suorituskykytestien tulokset ovat hyödyllisiä mallien suorituskyvyn ymmärtämisessä, mutta ne eivät kerro koko totuutta.
Eri testit mittaavat eri taitoja. Malli, joka suoriutuu hyvin pitkästä ohjelmistotekniikan suorituskykytestistä, ei välttämättä ole paras valinta tosiasioihin perustuvaan tutkimukseen, kirjoittamiseen tai visuaaliseen analyysiin.
Googlen Argon-ilmoitus ja julkaistut GPT-6 Astran arviointitulokset tarjoavat useita hyödyllisiä vertailukohtia.
Valittujen koodaus-benchmarkien tulokset
| Benchmark-testi | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Noin 78 % | 74,1 % | Noin 74 % |
| FrontierSWE v2 | Katso Googlen julkaisema arviointi | Raportoitu etulyöntiasema saatavilla olevissa vertailuissa | Katso Googlen julkaisema arviointi |
| Terminal-Bench 4.0 | Katso Googlen julkaisema arviointi | 57,9 % OpenAI:n julkaisemissa tuloksissa | Eri arviointitulokset voivat päteä |
Lähteet: Googlen Argon-ilmoitus, OpenAI:n Astra-mallin dokumentaatio ja lokakuun 2026 vertailu Argonista ja sen kilpailijoista.
Tärkeää: Näitä lukuja tulee pitää ilmoitettuina tuloksina eikä täysin kontrolloituna riippumattomana vertailuna. Tulokset voivat vaihdella malliversion, testausympäristön, työkalujen käyttöoikeuksien, päättelyasetusten ja arviointipäivämäärän mukaan. Jos alkuperäiset lähteet eivät tarjoa suoraan vertailukelpoista lukua, taulukossa vältetään tarkoituksellisesti sellaisen keksimistä.
Saatavilla olevat tulokset havainnollistavat myös sitä, miksi yleispätevä paremmuusjärjestys on harhaanjohtava. Argonin on raportoitu johtavan DeepSWE v1.1 -testissä, kun taas Astra ja Opus voivat suoriutua eri tavalla muissa ohjelmistotekniikan arvioinneissa.
Parempi lähestymistapa on kysyä, mikä benchmark-testi muistuttaa omaa todellista työkuormaasi.
- Koodin ylläpidossa aseta etusijalle todelliset koodivarastotehtävät ja testien läpäisyasteet.
- Tutkimuksessa mittaa tosiasioiden tarkkuutta ja sitä, tukevatko lähdeviitteet väitteitä.
- Agenttityönkuluissa mittaa kokonaisvaltaista suoritusta ja virheistä toipumista.
- Liiketoimintakirjoittamisessa arvioi tarkkuutta, ohjeiden noudattamista ja muokkaukseen kuluvaa aikaa.
Benchmark-testi on lähtökohta. Oma tehtäväsi on lopullinen testi.
Mitä Reddit-käyttäjät sanovat näistä malleista?
Reddit tarjoaa erilaisen näkökulman kuin viralliset ilmoitukset. Käyttäjät keskustelevat mallin suorituskyvyn niistä puolista, jotka he huomaavat jokapäiväisessä työssään, mukaan lukien koodin laatu, luovuus, nopeus, käyttörajat ja mallin tarvitseman ohjauksen määrä.
Nämä keskustelut ovat hyödyllistä näyttöä käyttäjien prioriteeteista, mutta ne ovat kokemusperäisiä. Yksittäinen julkaisu ei osoita, että yksi malli olisi objektiivisesti parempi jokaiselle käyttäjälle.
Gemini 4 Argon: Vakuuttavat tulokset, mutta saatavuus mietityttää edelleen
r/singularity-keskustelussa Gemini 4 Argonin benchmark-tuloksista käyttäjät keskustelivat Googlen raportoimista tuloksista koodauksen, kyberturvallisuuden ja asiantuntijatehtävien osalta.
Yksi toistuva kysymys oli, muuttuisiko mallin suorituskyky käytännön hyödyiksi ja milloin laajempi saatavuus toteutuisi.
Tämä luo hyödyllisen eron vertailuartikkelille: benchmark-johtajuus ei ole sama asia kuin jokapäiväinen hyödyllisyys. Käyttäjät tarvitsevat tavan testata mallia omissa tehtävissään ennen kuin he päättävät, kannattaako se ottaa käyttöön.
GPT-6 Astra vs Claude Opus 5.5: Laatu, nopeus ja käyttörajat
r/ClaudeAI-keskustelu, jossa verrataan Opus 5.5:ttä ja GPT-6 Astraa, havainnollistaa, kuinka nopeasti yhteisön mieltymykset voivat muuttua mallijulkaisujen välillä.
Osallistujat kuvaillivat erilaisia kokemuksia malleista. Jotkut pitivät enemmän Astrasta, kun taas toiset kehuivat Opus 5.5:n ominaisuuksia, mutta arvostelivat ohjauksen määrää, jota heidän piti joskus antaa.
Laajempi opetus on, että mallin laatu riippuu osittain tehtävästä ja käyttäjän työnkulusta. Malli, joka toimii hyvin yhdelle kehittäjälle, saattaa sopia huonommin toisen projektin vaatimuksiin.
Käyttörajat ovat toinen huolenaihe. Reddit-keskustelussa valinnasta Opus 5.5:n ja Astran välillä käyttäjä nosti esiin kysymyksiä käyttökiintiön loppumisesta ja siitä, tarjoaisiko tilauksen vaihtaminen parempaa vastinetta rahalle.
Tiheään käyttäville pitkäkestoisen työn kustannukset voivat olla yhtä tärkeitä kuin yksittäisten vastausten laatu.
Yksinkertainen luova tehtävä voi tuottaa erilaisia tuloksia
Reddit-vertailussa Opus 5.5:stä, GPT-6 Astrasta ja muista malleista käyttäjät keskustelivat saman kehotteen antamisesta useille malleille lyhyen paperilennokjianimaation luomiseksi.
Vastaukset heijastivat erilaisia mieltymyksiä: jotkut käyttäjät suosivat animaation laatua, kun taas toiset pitivät enemmän toisen mallin tulkinnasta tai luovasta suunnasta.
Tämä on hyödyllinen muistutus siitä, että mallivertailut eivät rajoitu koodaukseen ja päättelyyn. Luovassa työssä tuloksen laatu voi olla subjektiivista, ja sopivin malli riippuu tuloksesta, jota käyttäjä tavoittelee.
Mitä voimme oppia keskusteluista?
Näissä ketjuissa nousee esiin neljä teemaa:
- Käytännön suorituskyky merkitsee enemmän kuin otsikkotulos. Käyttäjät haluavat malleja, jotka ratkaisevat heidän erityiset ongelmansa.
- Ohjeiden noudattaminen vaikuttaa tuottavuuteen. Vahva malli on hyödyllisempi, kun se ymmärtää rajoitteet ilman toistuvaa selennystä.
- Käyttörajat vaikuttavat kokonaiskokemukseen. Laadukkaat tulokset ovat vähemmän arvokkaita, jos käyttäjät eivät voi jatkaa työnkulkuaan keskeytyksettä.
- Eri tehtävät palkitsevat eri vahvuuksia. Luovaa tuotosta, koodausta, tutkimusta ja automaatiota ei pitäisi arvioida samoin kriteerein.
Näiden havaintojen tulisi ohjata tämän artikkelin testejä ennemmin kuin korvata ne.
Kuinka vertailla kolmea mallia käytännön tehtävissä
Hyödyllisin vertailu antaisi kaikille kolmelle mallille saman tehtävän, samat syötemateriaalit ja samat arviointikriteerit.
Jos kaikki kolme mallia ovat käytettävissäsi, seuraavat testit voivat auttaa määrittämään, mikä niistä sopii työnkulkuusi.
Testi 1: Koodaus ja virheenjäljitys
Anna kullekin mallille sama pieni koodikanta, joka sisältää toistettavan virheen. Pyydä sitä tunnistamaan ongelma, toteuttamaan korjaus, kirjoittamaan testit ja selittämään muutokset.
Mittaa:
- Onko alkuperäinen virhe korjattu
- Läpäisevätkö olemassa olevat testit edelleen
- Onko mukana uusia virheitä
- Kuinka monta jatkokehotetta tarvitaan
- Kokonaisaika ja tokenien kulutus
Mallia, joka tuottaa uskottavan selityksen mutta epäonnistuu testeissä, ei pitäisi pitää voittajana.
Testi 2: Tutkimus ja asiakirja-analyysi
Anna sama sarja raportteja, taulukoita ja lähdeasiakirjoja. Pyydä kutakin mallia tekemään yhteenveto aineistosta, poimimaan tärkeät luvut, tunnistamaan ristiriidat ja laatimaan lyhyt raportti viitteineen.
Mittaa tosiasioiden tarkkuutta, viitteiden laatua, tärkeiden tietojen kattavuutta ja manuaalisen korjauksen tarvetta.
Tämä testi on erityisen hyödyllinen analyytikoille, opiskelijoille, konsulteille ja sisältötiimeille.
Testi 3: Monivaiheisen projektin toteutus
Anna kullekin mallille tehtävä, joka vaatii useita tuotoksia, kuten tuoteidean analysointia, projektisuunnitelman kehittämistä, tehtävätaulukon luomista ja lopullisen raportin valmistelua.
Arvioi, noudattaako se vaadittua järjestystä, säilyttääkö se johdonmukaisuuden tuotosten välillä ja tarkistaako se lopullisen tuloksen.
Jos ympäristö tarjoaa työkaluja, kirjaa muistiin, käyttääkö malli niitä oikein. Pidä mallin älykkyys erillään sitä pyörittävän alustan ominaisuuksista.
Testi 4: Kirjoittaminen ja ohjeiden noudattaminen
Anna yksityiskohtainen kirjoitustoimeksianto, jossa on määritelty kohdeyleisö, äänensävy, vaaditut kohdat, pituus ja rajoitukset.
Vertaa tuloksia tosiasioiden tarkkuuden, luettavuuden, rakenteen, omaperäisyyden ja toimeksiannon noudattamisen osalta.
Markkinointitiimeille tämä voi paljastaa, mikä malli tuottaa käyttökelpoisia ensivedoksia ja mikä vaatii enemmän muokkausta.
Käytä johdonmukaista pisteytyskehystä
Yksinkertainen 100 pisteen arviointi voi helpottaa tulosten vertailua.
| Kriteeri | Ehdotettu painotus |
|---|---|
| Tarkkuus ja virheettömyys | 30 |
| Tehtävän suorittaminen | 25 |
| Ohjeiden noudattaminen | 15 |
| Tulosteen laatu | 15 |
| Nopeus ja tehokkuus | 10 |
| Kustannukset | 5 |
| Yhteensä | 100 |
Painotusten tulisi muuttua tehtävän mukaan. Esimerkiksi koodaustesteissä tulisi painottaa enemmän toimivaa koodia ja testien läpäisyä, kun taas tutkimustesteissä tulisi priorisoida tosiasioiden tarkkuutta ja lähteiden laatua.
Älä julkaise pistemäärää riippumattomana testinä, ellet ole tosiasiallisesti suorittanut koetta. Jos pääsy Argoniiin on rajoitettu, käytä selkeästi merkittyä julkaistujen tulosten vertailua ja varaa riippumattoman testauksen osio malleille, joita voit aidosti arvioida.
Hintavertailu: Mikä malli tarjoaa parempaa vastinetta rahalle?
Näille malleille julkaistut vakio-API-hinnat tarjoavat hyödyllisen lähtökohdan.
| Malli | Syöte per 1 milj. tokenia | Tuloste per 1 milj. tokenia |
|---|---|---|
| Gemini 4 Argon | 2 $ | 10 $ |
| GPT-6 Astra | 10 $ | 50 $ |
| Claude Opus 5.5 | 4 $ | 20 $ |
Lähteet: Google, OpenAI ja Anthropic.
Näillä julkaistuilla vakiohinnoilla Argonilla on alhaisin ilmoitettu token-hinta, jota seuraavat Opus 5.5 ja Astra. Tämä ei kuitenkaan automaattisesti tee Argonista halvinta käytännön vaihtoehtoa jokaiselle käyttäjälle, varsinkaan niin kauan kuin sen saatavuus on rajoitettu.
Esimerkki: Tehtävä, joka käyttää 100 000 syötetokenia ja 20 000 tulostetokenia
Olettaen, että julkaistut hinnat pätevät ilman välimuistialennuksia, työkalumaksuja tai muita kuluja:
- Gemini 4 Argon: 0,20 $ syöte + 0,20 $ tuloste = 0,40 $
- GPT-6 Astra: 1,00 $ syöte + 1,00 $ tuloste = 2,00 $
- Claude Opus 5.5: 0,40 $ syöte + 0,40 $ tuloste = 0,80 $
Tämä on esimerkki token-kustannuksesta, ei väite siitä, että mallit käyttäisivät saman määrän tokeneita saman tehtävän suorittamiseen.
Reilumman vertailun saamiseksi laske yhden onnistuneen tuloksen tuottamisen kustannukset. Jos yksi malli vaatii viisi uudelleenyritystä ja toinen suorittaa tehtävän yhdellä yrityksellä, niiden todelliset kustannukset voivat erota merkittävästi vakio-token-hintasuhteesta.
Tilaussuunnitelmilla on myös omat hintansa, rajansa ja käyttösääntönsä. Älä vertaa API-hintoja suoraan tilausmaksuihin ikään kuin ne olisivat samanarvoisia.
Mikä tekoälymalli sopii parhaiten tarpeisiisi?
Oikea malli riippuu siitä, mitä teet, kuinka usein käytät tekoälyä ja miltä onnistunut tulos näyttää.
Ohjelmistokehittäjille
Harkitse GPT-6 Astran ja Claude Opus 5.5:n testaamista todellisessa koodikannassasi. Molemmat on asemoitu vaativaan insinöörityöhön, mutta niiden suhteellinen suorituskyky riippuu käyttämästäsi kielestä, työkaluista ja projektin monimutkaisuudesta.
Gemini 4 Argon on myös seuraamisen arvoinen sen raportoitujen ohjelmistotekniikan tulosten ansiosta, riippuen pääsystä malliin ja riippumattomasta verifioinnista.
Tutkijoille ja analyytikoille
Aseta etusijalle tarkka tiedon poiminta, luotettavat lähdeviitteet, pitkien asiakirjojen käsittely ja kyky erottaa tosiasiat oletuksista.
Työssä, johon liittyy suuria tiedostokokoelmia, testaa, pystyykö malli löytämään olennaiset yksityiskohdat ilman, että se jättää huomiotta ristiriitaista näyttöä.
Sisällöntuottajille ja markkinoijille
Vertaa, kuinka hyvin kukin malli noudattaa sisältötoimeksiantoa, säilyttää johdonmukaisen äänensävyn, järjestää tietoa ja tuottaa vedoksia, jotka vaativat mahdollisimman vähän muokkausta.
Käytännölliseen työnkulkuun voi sisältyä avainsanatutkimus, jäsennys, luonnostelu, faktojen tarkistus ja sisällön mukauttaminen eri yleisöille. Ihmisen tekemä tarkistus on edelleen välttämätöntä, erityisesti tosiasiaväitteiden ja SEO-sisällön osalta.
Yrityskäyttäjille
Keskity tehtävien suorittamiseen, asiakirja-analyysiin, taulukkolaskentatyönkulkuihin, raportointiin ja tulosteiden luotettavuuteen.
Toistuvissa tehtävissä pienikin manuaalisen tarkistusajan lyheneminen voi olla tärkeämpää kuin vaatimaton parannus benchmark-tuloksissa.
Budjettitietoisille käyttäjille
Vertaa yleisten tehtäviesi suorittamisen todellisia kustannuksia sen sijaan, että valitsisit mallin pelkästään sen mainostetun älykkyyden perusteella.
Jos edullisempi malli täyttää vaatimuksesi johdonmukaisesti, se voi olla parempi arkipäivän vaihtoehto. Varaa kalliimmat mallit työhön, jossa niiden lisäominaisuudet tekevät mitattavan eron.
Kuinka tutkia tekoälymalleja ja suorittaa tehtäviä ChatGOAT AI:ssa
Mallien vertailu on hyödyllistä, mutta tekoälyn todellinen hyöty tulee sen soveltamisesta omaan työhösi.
ChatGOAT AI tarjoaa tekoälytyötilan tuetuille malleille ja työkaluille, mikä auttaa käyttäjiä tutkimaan tekoälyavusteista kirjoittamista, tutkimusta, analyysia ja luovia työnkulkuja ilman, että jokaista tehtävää tarvitsee käsitellä erillisenä kokeiluna.
Jos Gemini 4 Argon, GPT-6 Astra ja Claude Opus 5.5 ovat käytössä nykyisessä ChatGOAT-mallinvalitsimessa, käyttäjät voivat tutkia niiden vastauksia alustalla ja arvioida, mikä lähestymistapa sopii parhaiten heidän tarpeisiinsa. Saatavuus voi vaihdella mallin ja integraation mukaan, joten tarkista ajantasainen malliluettelo ennen aloittamista.
Mitä voit tehdä tekoälyllä ChatGOAT AI:ssa?
Kirjoittaa ja parantaa sisältöä
Käytä tekoälyä artikkeli-ideoiden ideointiin, jäsennysten luomiseen, blogikirjoitusten luonnosteluun, kappaleiden uudelleenkirjoittamiseen, pitkien materiaalien yhteenvetämiseen tai sisällön mukauttamiseen eri yleisöille.
Esimerkiksi hakukoneoptimoinnin asiantuntija voi kehittää blogin jäsennyksen, luonnostella vertailuartikkelin, valmistaa FAQ-vastauksia ja muokata sisältöä selkeyden ja haku-intressin mukaiseksi.
Analysoida tietoa ja asiakirjoja
Tekoäly voi auttaa poimimaan keskeisiä kohtia annetuista materiaaleista, vertailemaan raportteja, järjestämään tutkimustuloksia ja muuttamaan jäsentämättömät muistiinpanot selkeämmäksi yhteenvedoksi.
Esimerkiksi yrityskäyttäjä voi muuttaa kokousmuistiinpanot toimintasuunnitelmaksi, luoda vertailutaulukon ja valmistaa tiiviin tiivistelmän johdolle.
Luoda jäsenneltyjä taulukoita ja projektisuunnitelmia
Käytä tekoälyä tuotevertailujen järjestämiseen, tehtäväluetteloiden valmisteluun, tutkimusmatriisien rakentamiseen ja jäsenneltyjen projektisuunnitelmien luomiseen.
Markkinointitiimi voisi käyttää tätä työnkulkua kilpailijoiden ominaisuuksien vertailuun, avainsanojen kartoittamiseen laskeutumissivuille ja sisältökalenterin järjestämiseen.
Tukea koodausta ja ongelmanratkaisua
Tuetuissa koodaustyönkuluissa tekoäly voi selittää vierasta koodia, ehdottaa virheenjäljitysvaiheita, luonnostella funktioita ja auttaa teknisen dokumentaation järjestämisessä.
Testaa aina luotu koodi ja tarkista muutokset ennen niiden käyttöä tuotannossa.
ChatGOAT AI tarjoaa myös tekoälypohjaisia kuvien luontiominaisuuksia tuettujen kuvatyökalujen ja -mallien kautta. Nämä voivat auttaa käyttäjiä luomaan kuvituksia, visuaalisia konsepteja, sosiaalisen median grafiikkaa ja muita luovia aineistoja.
Kuvien luonti on erillinen ominaisuus tekstimallien päättelystä. Älä oleta, että jokainen tämän vertailun malli voisi luoda kuvia suoraan vain siksi, että työtila sisältää kuvatyökaluja.
Rakentaa tehokkaampi työnkulku
Sen sijaan, että jokaista tehtävää käsiteltäisiin erillisenä kehotteena, käyttäjät voivat jakaa projektin vaiheisiin: tutkimus, suunnittelu, luonnostelu, tarkistus ja lopullinen toimitus.
Hyödyllisin työnkulku on se, joka tuottaa tarkkoja tuloksia vähemmällä toistuvalla työllä – ei välttämättä se, joka käyttää edistyneintä mallia jokaiseen vaiheeseen.
Tutustu ChatGOAT AI:hin nähdäksesi parhaillaan tuetut mallit ja tekoälytyökalut, jotka ovat käytettävissä työnkulussasi.
FAQ
Onko Gemini 4 Argon parempi kuin GPT-6 Astra?
Ei jokaisessa tilanteessa. Google on raportoinut vahvoja tuloksia Argonille valituissa tekniikan ja asiantuntijatyön benchmark-testeissä, kun taas OpenAI julkaisee vahvoja tuloksia Astralle useissa vaativissa arvioinneissa. Saatavuusrajoitukset ja erot testausmenetelmissä tekevät yleispätevästä järjestyksestä ennenaikaisen.
Onko Claude Opus 5.5 parempi kuin GPT-6 Astra koodauksessa?
Molemmat on suunniteltu vaativiin ohjelmistotekniikan tehtäviin. Parempi vaihtoehto riippuu koodikannasta, ohjelmointikielestä, käytettävissä olevista työkaluista ja lopullisen toteutuksen laadusta. Vertaa testien läpäisyasteita, regressioriskejä, iterointikertoja ja kokonaiskustannuksia samassa tehtävässä.
Mikä malli on paras monimutkaiseen päättelyyn?
GPT-6 Astra ja Gemini 4 Argon on molemmat asemoitu monimutkaiseen päättelyyn ja monivaiheiseen työhön, kun taas Claude Opus 5.5 on suunniteltu vaativiin asiantuntija- ja agenttityönkulkuihin. Käytä tehtäväkohtaisia testejä määrittääksesi, mikä malli suoriutuu parhaiten tarpeistasi.
Mikä malli on halvin?
Edellä lueteltujen julkaistujen vakio-API-hintojen perusteella Gemini 4 Argonilla on alhaisin token-hinta, jota seuraavat Claude Opus 5.5 ja GPT-6 Astra. Argonin rajoitettu saatavuus vaikuttaa kuitenkin siihen, voivatko useimmat käyttäjät tosiasiallisesti hyödyntää tätä hinnoittelua. Tehtävän kokonaiskustannus riippuu myös tokenien kulutuksesta, uudelleenyrityksistä, välimuistista ja työkaluista.
Voinko käyttää Gemini 4 Argonai juuri nyt?
Google ilmoitti Argonista aluksi luotettaville kyberturvallisuuden puolustajille Fairwind-ohjelman kautta, ja laajempi saatavuus on suunnitteilla. Tarkista Googlen viimeisin virallinen ilmoitus saatavuuden muutoksista ennen kuin luotat siihen projektissa.
Voinko vertailla näitä malleja ChatGOAT AI:ssa?
Voit tutkia malleja ja työkaluja, joita nykyinen ChatGOAT AI -työtila tukee. Vertaillaksesi kaikkia kolmea suoraan, varmista, että Gemini 4 Argon, GPT-6 Astra ja Claude Opus 5.5 ovat kukin saatavilla nykyisessä mallinvalitsimessa. Jos jokin niistä ei ole saatavilla, vertaa sen julkaistua dokumentaatiota sen sijaan käytettävissä olevista malleista saatuihin käytännön tuloksiin.
Mikä malli on paras arkipäiväiseen työhön?
Yleispätevää vastausta ei ole. Ota huomioon useimmiten suorittamasi tehtävät, kuinka tarkkoja tulosten on oltava, tarvittavan muokkauksen määrä, budjettisi ja käyttämäsi alustan käyttörajat. Muutamien edustavien tehtävien testaaminen on hyödyllisempää kuin valitseminen pelkän maineen perusteella.
Lopullinen arvio: Valitse malli, joka suorittaa työsi parhaiten
Gemini 4 Argon, GPT-6 Astra ja Claude Opus 5.5 edustavat erilaisia lähestymistapoja edistyneeseen tekoälyavustukseen. Argonilla on raportoituja vahvuuksia valituissa tekniikan ja asiantuntijatyön arvioinneissa, Astra tähtää vaativiin päättely- ja tietokoneen käyttötehtäviin, ja Opus 5.5 keskittyy koodausagentteihin ja pitkäkestoisiin asiantuntijatyönkulkuihin.
Paras malli ei välttämättä ole se, jolla on korkein pistemäärä tai kallein API. Se on malli, joka suorittaa tehtäväsi luotettavasti, noudattaa ohjeitasi, sopii budjettiisi ja vaatii vähiten tarpeetonta väliintuloa.
Käytä virallisia suorituskykytestejä vaihtoehtojesi rajaamiseen, Reddit-keskusteluja todellisten käyttäjien esittämien kysymysten ymmärtämiseen ja johdonmukaisia käytännön testejä lopullisen päätöksen tekemiseen.
ChatGOAT AI:n avulla voit tutkia tuettuja tekoälymalleja ja -työkaluja kirjoittamiseen, tutkimukseen, analyysiin ja luovaan työhön yhdessä työtilassa. Aloita tehtävästä, joka sinun on tosiasiallisesti suoritettava, vertaa tulosten laatua ja valitse työnkulku, joka helpottaa työtäsi.