Puntos clave
- Kimi K3.1 Pro tiene una ventana de contexto de 1 milln de tokens y est£ diseado para programacin, creacin en 3D, investigacin financiera y tareas de agentes de larga duracin.
- Su API cuesta $2 por milln de tokens de entrada y $10 por milln de tokens de salida, con entrada en cach← disponible con un 90% de descuento.
- Kimi obtiene una puntuacin del 65.7% en Terminal-Bench 4.0, cerca del 66.4% de Claude Opus 5.5 y por delante del 58.2% de GPT-6 Astra.
- Kimi lidera en varias pruebas comparativas de contexto largo y financieras, incluyendo SWE-Marathon v1.1 y OfficeQA Pro v2.
- GPT-6 Astra rinde mucho mejor en Terminal-Bench Science 0.1, lo que sugiere que podr■a ser m£s fuerte para flujos de trabajo cient■ficos y de agentes de investigacin.
- El menor precio por token de Kimi no siempre significa una factura final m£s baja, ya que las tareas de los agentes pueden consumir muchos tokens de salida.
- ChatGOAT AI permite a los usuarios acceder a Kimi K3.1 Pro junto con Claude Opus 5.5, GPT-6 Astra, Gemini, Grok, DeepSeek y otros modelos en una sola interfaz.
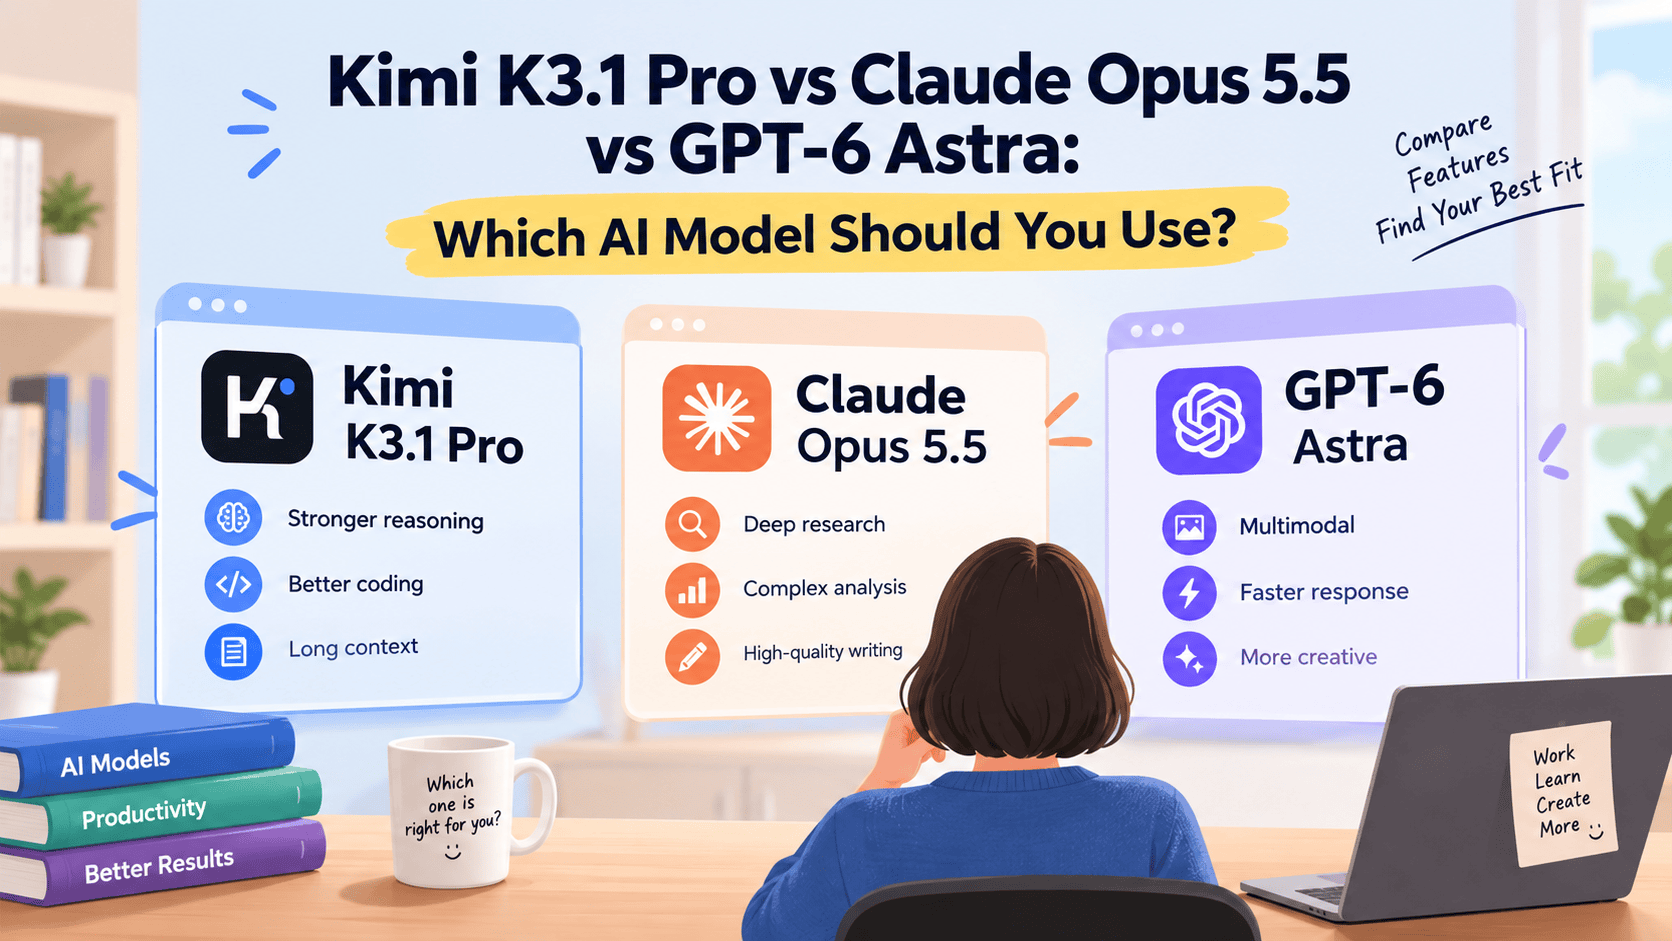
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra: Qu← modelo de IA deber■as usar?
Elegir un modelo de IA ya no consiste solo en escoger el "m£s inteligente". El mejor modelo depende de lo que est←s construyendo: un agente de programacin, un asistente de investigacin financiera, un prototipo 3D, un flujo de trabajo de investigacin o una aplicacin de produccin sensible a los costos.
Esta comparacin analiza Kimi K3.1 Pro, Claude Opus 5.5 y GPT-6 Astra utilizando tareas del mundo real, resultados de pruebas comparativas, precios y fortalezas pr£cticas.
Qu← es Kimi K3.1 Pro?
Kimi K3.1 Pro es el primer modelo de la serie K3.1 de Moonshot AI y el modelo m£s capaz de la compa■a hasta la fecha. Es un modelo de 3 billones de par£metros con una ventana de contexto de 1 milln de tokens, lo que lo hace adecuado para bases de cdigo grandes, informes extensos, tareas de agentes de mltiples pasos y proyectos de investigacin complejos.
Moonshot posiciona a K3.1 Pro en torno a cuatro mejoras principales:
- Programacin
- Creacin en 3D
- Investigacin financiera
- Capacidades de agentes de largo alcance
Tambi←n es compatible con herramientas como Unity, Unreal, Godot y Three.js, lo que lo hace interesante para desarrolladores que construyen juegos, sitios web interactivos y experiencias en 3D.
Precios de Kimi K3.1 Pro
| Plan / Acceso | Precio | Notas |
|---|---|---|
| Entrada de API | $2 por milln de tokens | Menor que el precio de entrada anterior de Kimi K3 de $3. |
| Salida de API | $10 por milln de tokens | Menor que el precio de salida anterior de Kimi K3 de $15. |
| Entrada en cach← | Aproximadamente $0.20 por milln de tokens | Basado en un descuento de cach← del 90%. |
| Versin de alta velocidad | Aproximadamente 2 veces el precio est£ndar | Ofrece una salida entre 2 y 3 veces m£s r£pida con una inteligencia similar. |
El bajo precio de lista es atractivo, pero es importante realizar un seguimiento del uso real de los tokens. En una prueba de Artificial Analysis, Kimi consumi alrededor de 150 millones de tokens de salida, por encima de la mediana de 87 millones, lo que puede aumentar el costo total de las tareas de agentes largos.
Pruebas comparativas de Kimi K3.1 Pro
Kimi K3.1 Pro rinde especialmente bien en agentes de programacin, ingenier■a de software de largo alcance, investigacin web y an£lisis de documentos financieros. Sin embargo, no es el mejor modelo para todas las tareas.
| Prueba comparativa | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Qu← significa |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | Kimi est£ casi empatado con Claude en el trabajo de agentes de programacin en terminal. |
| SWE-Marathon v1.1 | 51.7% | 46.3% | 42.5% | Kimi lidera en ingenier■a de software de largo alcance. |
| HLE-Full con herramientas | 70.0% | 67.7% | 57.2% | Kimi tiene un rendimiento slido en razonamiento de conocimiento dif■cil con herramientas. |
| BrowseComp | 92.1% | 90.8% | 91.5% | Los tres son fuertes en investigacin web. |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | Kimi es fuerte para el an£lisis de documentos financieros y de oficina. |
| Terminal-Bench Science 0.1 | 38.1 | 63.3 | 68.1 | GPT-6 Astra lidera en flujos de trabajo de terminal orientados a la ciencia. |
La leccin principal es simple: Kimi no es simplemente un ᆱClaude m£s baratoᄏ. Es altamente competitivo en programacin ag←ntica y trabajo con muchos documentos, pero GPT-6 Astra puede ser la mejor opcin para los flujos de trabajo de investigacin cient■fica.
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra
1. Correccin de errores en una base de cdigo real
Tarea: Proporcionar a cada modelo el mismo repositorio con varios errores ocultos. Pedirle que localice el problema, escriba una solucin, aada pruebas y explique el cambio.
Qu← medir:
- Si encuentra la causa ra■z
- Nmero de reintentos
- Si las pruebas pasan
- Calidad del cdigo
- Tokens totales y costo
Resultado esperado: Kimi se desempea bien en las pruebas de ingenier■a de largo alcance, pero las pruebas independientes en repositorios reales sugieren que puede no liderar siempre en la correccin de errores heredados (legacy). Una prueba de terceros descubri que Kimi obtuvo una puntuacin de 36 en una evaluacin de correccin de errores en el mundo real, por debajo del 41.7 de Claude Opus 5.5.
Mejor opcin: Claude Opus 5.5 para la depuracin dif■cil de cdigo heredado; Kimi K3.1 Pro para refactorizaciones m£s grandes y desarrollo impulsado por agentes.
2. Convertir un PRD en una aplicacin web funcional
Tarea: Proporcionar un documento de requisitos del producto y pedir a cada modelo que cree una aplicacin web funcional, incluyendo frontend, backend, esquema de base de datos e instrucciones de despliegue.
Qu← medir:
- Completitud de caracter■sticas
- Organizacin del cdigo
- Calidad de la interfaz de usuario (UI)
- Manejo de un cambio de requisitos a mitad del proyecto
- Si la aplicacin se ejecuta sin reparacin manual
Resultado esperado: Kimi est£ diseado para la programacin ag←ntica y es compatible con flujos de trabajo orientados al frontend y a 3D, pero las evaluaciones independientes sugieren que an puede ir por detr£s de algunos modelos insignia occidentales en pulido visual, animacin y creacin de sitios web.
Mejor opcin: Kimi para prototipos r£pidos de ingenier■a; Claude o GPT-6 Astra si la calidad visual y el diseo iterativo son la prioridad.
3. An£lisis de un informe financiero largo
Tarea: Subir un informe anual de 300 p£ginas, un informe de la industria y una hoja de c£lculo. Pedir al modelo que extraiga m←tricas financieras, identifique riesgos, construya un pronstico a tres aos y cite los nmeros de p£gina de cada afirmacin.
Qu← medir:
- Precisin de los nmeros extra■dos
- Calidad de las citas
- Capacidad para conectar datos entre documentos
- Calidad del modelo financiero
- Tasa de alucinacin
Resultado esperado: Este es uno de los casos de uso m£s fuertes de Kimi. Obtuvo una puntuacin de 64.4 en OfficeQA Pro v2, superando a Claude Opus 5.5 con 62.2 y a GPT-6 Astra con 54.4.
Mejor opcin: Kimi K3.1 Pro para documentos financieros largos, an£lisis de hojas de c£lculo y trabajo empresarial con alta carga de investigacin.
4. Construccin de un prototipo 3D
Tarea: Pedir a cada modelo que cree una escena interactiva en Three.js, un minijuego en Godot o un prototipo en Unity a partir de una breve descripcin.
Qu← medir:
- Calidad de los recursos (assets)
- Completitud de la interaccin
- Uso de herramientas
- Pulido visual
- Capacidad de revisin tras recibir comentarios
Resultado esperado: Kimi es fuerte en esta categor■a porque Moonshot mejor espec■ficamente la creacin en 3D y la integracin de herramientas. Sin embargo, no es autom£ticamente el mejor modelo creativo; las pruebas independientes encontraron deficiencias en algunas tareas de generacin en 3D y de sitios web.
Mejor opcin: Kimi para prototipos r£pidos jugables; Claude o GPT-6 Astra para resultados creativos m£s pulidos, dependiendo de los resultados de tus pruebas.
5. Investigacin en l■nea de mltiples pasos
Tarea: Pedir a cada modelo que investigue un mercado, identifique 10 empresas importantes, verifique afirmaciones y produzca un informe con fuentes.
Qu← medir:
- Calidad de las fuentes
- Precisin factual
- Capacidad para evitar la repeticin
- Profundidad del an£lisis
- Fiabilidad de las citas
Resultado esperado: Kimi obtuvo un 92.1% en BrowseComp, ligeramente por delante de Claude Opus 5.5 y GPT-6 Astra. Esto sugiere que es altamente capaz en la recuperacin de informacin basada en la web.
Mejor opcin: Kimi para investigacin web general; GPT-6 Astra para investigacin cient■fica e indagacin t←cnica.
6. Prueba de costos y velocidad
Tarea: Ejecutar el mismo flujo de trabajo de agentes de 10 pasos en cada modelo y comparar el costo total, la latencia, los tokens de salida, los reintentos y la calidad final.
| M←trica | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Precio de entrada de API | $2 / milln de tokens | M£s alto | Var■a segn el proveedor y el plan. |
| Precio de salida de API | $10 / milln de tokens | M£s alto | Var■a segn el proveedor y el plan. |
| Costo de tarea en Artificial Analysis | $2.11 | $5.98 | $3.26 |
| Uso de tokens de salida | Alto en algunas pruebas de agentes | M£s bajo en la prueba citada | Moderado en la prueba citada |
| Mejor para | Contexto largo, agentes de programacin, finanzas | Ingenier■a de software exigente | Agentes de investigacin y cient■ficos |
El precio m£s bajo de Kimi es real, pero tu factura final depende de cu£ntos tokens utilice el modelo. Para solicitudes repetitivas, el almacenamiento en cach← puede marcar una gran diferencia.
Qu← modelo deber■as elegir?
| Caso de uso | Mejor modelo | Por qu← |
|---|---|---|
| Documentos financieros largos | Kimi K3.1 Pro | Gran rendimiento en OfficeQA y contexto de 1 milln de tokens. |
| Programacin ag←ntica | Kimi K3.1 Pro o Claude Opus 5.5 | Kimi lidera algunas pruebas de programacin de largo alcance; Claude sigue siendo excelente en programacin en terminal. |
| Correccin de errores heredados | Claude Opus 5.5 | M£s fuerte en algunas pruebas independientes de correccin de errores en repositorios reales. |
| Agentes de investigacin cient■fica | GPT-6 Astra | Lidera Terminal-Bench Science 0.1 por un amplio margen. |
| Aplicaciones de API sensibles a los costos | Kimi K3.1 Pro | Precios de entrada/salida de lista m£s bajos y gran valor en pruebas comparativas. |
| Prototipos 3D y de juegos | Kimi K3.1 Pro | Diseado para la creacin en 3D y herramientas como Unity, Unreal, Godot y Three.js. |
| Investigacin web general | Kimi K3.1 Pro | Ligeramente por delante en BrowseComp. |
Cmo probar estos modelos t mismo
No conf■es nicamente en las tablas de pruebas comparativas. Ejecuta la misma peticin (prompt) en cada modelo y califica los resultados.
Utiliza este sencillo marco de pruebas:
- Elige una tarea que realmente realices todas las semanas.
- Escribe una peticin detallada con entregables claros.
- Ejectala en Kimi K3.1 Pro, Claude Opus 5.5 y GPT-6 Astra.
- Registra la calidad de finalizacin, las ediciones necesarias, la latencia y el uso de tokens.
- Repite la prueba tres veces.
- Calcula el costo por resultado utilizable, no solo el costo por milln de tokens.
Este enfoque te ayuda a evitar el error m£s comn: elegir un modelo porque gana una prueba comparativa en lugar de porque rinde mejor en tu flujo de trabajo.
Prueba Kimi K3.1 Pro en ChatGOAT AI
No necesitas cuentas separadas ni claves de API para comparar estos modelos. ChatGOAT AI es una plataforma de IA todo en uno que proporciona acceso a mltiples modelos l■deres, incluidos Kimi K3.1 Pro, Claude Opus 5.5, GPT-6 Astra, Gemini 4 Carbon, Grok 4.7 y DeepSeek, en un solo espacio de trabajo.
Con ChatGOAT AI, puedes:
- Chatear con Kimi K3.1 Pro directamente en tu navegador.
- Comparar Kimi con Claude Opus 5.5 y GPT-6 Astra usando la misma peticin.
- Usar la IA para programacin, investigacin, redaccin, hojas de c£lculo, presentaciones, im£genes y tareas de agentes de mltiples pasos.
- Cambiar de modelo sin reconstruir tu flujo de trabajo ni gestionar mltiples suscripciones.
Por ejemplo, si est£s analizando un informe financiero, puedes pedirle a Kimi K3.1 Pro que extraiga m←tricas y construya un modelo, luego pedirle a Claude Opus 5.5 que revise la lgica o a GPT-6 Astra que investigue los riesgos de mercado. Este flujo de trabajo de "cambio de modelo" suele ser m£s til que comprometerse con un solo proveedor de IA.
Preguntas frecuentes
Es Kimi K3.1 Pro mejor que Claude Opus 5.5?
Depende de la tarea. Kimi lidera en algunas pruebas de programacin de largo alcance, an£lisis financiero y recuperacin, mientras que Claude Opus 5.5 sigue estando ligeramente por delante en Terminal-Bench 4.0 y puede ser m£s fuerte para ciertas tareas de depuracin en el mundo real.
Es Kimi K3.1 Pro mejor que GPT-6 Astra?
Para programacin de contexto largo, documentos financieros e investigacin web general, Kimi es altamente competitivo. Para flujos de trabajo cient■ficos en terminal, GPT-6 Astra tiene una clara ventaja basada en los resultados de Terminal-Bench Science 0.1.
Cu£nto cuesta Kimi K3.1 Pro?
Kimi K3.1 Pro cuesta $2 por milln de tokens de entrada y $10 por milln de tokens de salida a trav←s de la API. La entrada en cach← est£ disponible aproximadamente por $0.20 por milln de tokens.
Tiene realmente Kimi K3.1 Pro un contexto de 1M?
S■. Moonshot afirma que K3.1 Pro es compatible con una ventana de contexto de 1 milln de tokens, lo cual es til para bases de cdigo grandes, informes largos y an£lisis de mltiples documentos.
Puedo usar Kimi K3.1 Pro para programar?
S■. La programacin es una de sus principales fortalezas, especialmente la programacin ag←ntica, la ingenier■a de software de largo alcance y las tareas de desarrollo basadas en terminal.
Puedo usar Kimi K3.1 Pro en ChatGOAT AI?
S■. ChatGOAT AI incluye a Kimi K3.1 Pro entre sus modelos disponibles, junto con Claude Opus 5.5, GPT-6 Astra, Gemini, Grok y DeepSeek.
Qu← modelo es mejor para principiantes?
Para los principiantes, comience con ChatGOAT AI porque le permite probar mltiples modelos en un solo lugar. Use Kimi para documentos largos y programacin, Claude para ingenier■a de software cuidadosa y GPT-6 Astra para tareas con alta carga de investigacin.
Deber■a elegir Kimi porque es m£s barato?
No siempre. Kimi tiene un precio por token m£s bajo, pero las tareas de los agentes pueden generar muchos tokens de salida. Pruebe el flujo de trabajo completo y compare el costo final, no solo la tarifa publicada.