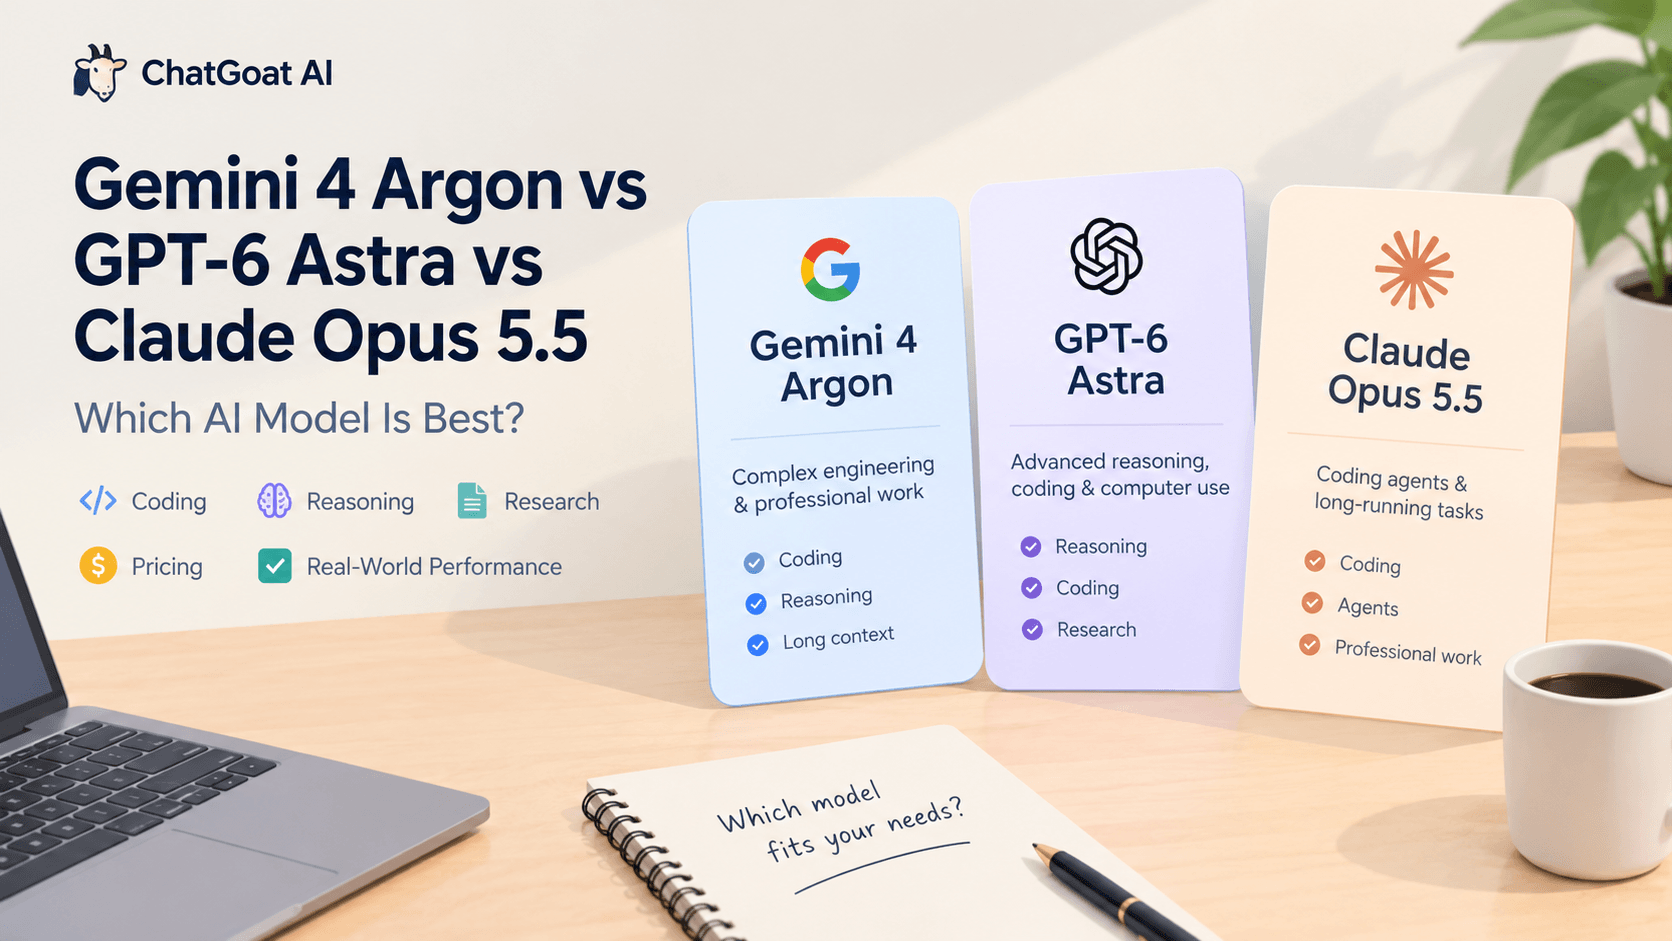
La competencia entre Gemini 4 Argon, GPT-6 Astra y Claude Opus 5.5 destaca un cambio importante en la inteligencia artificial. Los modelos l■deres de hoy en d■a ya no se juzgan nicamente por lo bien que responden preguntas. Los desarrolladores, investigadores y usuarios cotidianos tambi←n quieren una IA que pueda resolver problemas complejos, comprender grandes proyectos, escribir cdigo confiable, analizar documentos y completar tareas de mltiples pasos con menos supervisin.
Cada modelo tiene un conjunto diferente de fortalezas. Google posiciona a Gemini 4 Argon en torno a la ingenier■a compleja, el trabajo de conocimiento profesional y la defensa en ciberseguridad. OpenAI presenta a GPT-6 Astra como un modelo para tareas exigentes de razonamiento, programacin, investigacin y uso del ordenador. Anthropic destaca las capacidades de Claude Opus 5.5 en ingenier■a de software, agentes de larga ejecucin y trabajo profesional.
Pero qu← modelo deber■as elegir? Es Gemini 4 Argon realmente mejor programando? Justifica GPT-6 Astra su precio de API m£s elevado? Puede Claude Opus 5.5 completar proyectos complicados con menos instrucciones?
Esta comparacin examina los resultados oficiales de las evaluaciones comparativas (benchmarks), los precios, la disponibilidad, los casos de uso pr£cticos y las discusiones de Reddit. Tambi←n explica cmo evaluar estos modelos para trabajos reales y explorar flujos de trabajo impulsados por IA a trav←s de ChatGOAT AI.
Veredicto r£pido: Gemini 4 Argon vs. GPT-6 Astra vs. Claude Opus 5.5
No hay un nico ganador para cada tarea. La mejor opcin depende del trabajo que necesites completar, tu presupuesto y si puedes acceder al modelo a trav←s de tu plataforma preferida.
| Comparacin | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Posicionamiento principal | Ingenier■a compleja y flujos de trabajo profesionales | Razonamiento avanzado, programacin, investigacin y uso del ordenador | Agentes de programacin y tareas profesionales de larga ejecucin |
| Programacin | Resultados slidos en evaluaciones comparativas seleccionadas de ingenier■a de software | Slido en tareas t←cnicas y de programacin con un alto nivel de razonamiento | Diseado para programacin compleja y flujos de trabajo con agentes |
| Razonamiento | Diseado para la resolucin de problemas complejos de mltiples pasos | Creado para razonamiento exigente y trabajo profesional | Fuerte en instrucciones complejas y trabajo sostenido |
| Trabajo con contextos largos | Se anunciaron hasta 1 milln de tokens de salida | Ventana de contexto de 1,05 millones de tokens | Flujos de trabajo con agentes de larga ejecucin y grandes proyectos |
| Precio est£ndar de entrada de la API | $2 por milln de tokens | $10 por milln de tokens | $4 por milln de tokens |
| Precio est£ndar de salida de la API | $10 por milln de tokens | $50 por milln de tokens | $20 por milln de tokens |
| Disponibilidad | Inicialmente restringido a ciberdefensores de confianza | Disponible a trav←s de los productos compatibles y la API de OpenAI | Disponible a trav←s de las plataformas compatibles de Claude y de desarrolladores |
Fuentes: Anuncio de Gemini 4 Argon de Google, Documentacin del modelo GPT-6 Astra de OpenAI y Documentacin de Claude Opus de Anthropic.
Estos modelos no deben clasificarse nicamente por el precio o por una sola evaluacin comparativa. Un modelo que cuesta menos por token puede necesitar m£s reintentos para finalizar una tarea, mientras que un modelo con una puntuacin impresionante en un benchmark puede no estar accesible para el usuario promedio.
La conclusin pr£ctica: Compara la calidad del resultado final, el tiempo requerido, la cantidad de correcciones y el costo real de completar tu tarea.
Gemini 4 Argon: Creado para ingenier■a compleja y trabajo de conocimiento
Google anunci Gemini 4 Argon el 30 de septiembre de 2026, posicion£ndolo como un modelo de frontera para la ingenier■a de software en el mundo real, el trabajo de conocimiento empresarial y la defensa en ciberseguridad.
A diferencia de un modelo diseado principalmente para conversaciones cotidianas, Argon se presenta como un sistema capaz de manejar tareas largas e interconectadas. Estas pueden implicar examinar informacin t←cnica extensa, identificar problemas, planificar una secuencia de acciones y producir un resultado final.
Fortalezas clave
Ingenier■a de software compleja
Argon ha mostrado resultados slidos en evaluaciones comparativas seleccionadas de ingenier■a de software. El anuncio de Google enfatiza las tareas de ingenier■a a largo plazo, donde un sistema de IA debe mantener el contexto mientras trabaja en un problema complicado.
Las aplicaciones potenciales incluyen revisar un cdigo base extenso, identificar el origen de un error (bug), planificar una migracin y evaluar si los cambios propuestos resuelven el problema original.
Investigacin profesional y an£lisis de documentos
Google tambi←n destaca el trabajo de conocimiento empresarial, legal, financiero y de otros sectores. Esto hace que las tareas con un alto volumen de documentos sean un £rea importante de evaluacin, particularmente cuando el modelo debe conectar informacin a trav←s de varios archivos.
Por ejemplo, un analista de negocios podr■a usar un flujo de trabajo de IA para resumir informes, extraer cifras financieras, comparar suposiciones y preparar un informe estructurado para revisin humana.
Salida extensa
Google anunci un l■mite m£ximo de salida de hasta un milln de tokens para Argon. Esto es una capacidad de salida, no lo mismo que una ventana de contexto. La distincin importa al comparar modelos porque la cantidad de informacin que un modelo puede recibir y la cantidad que puede generar son capacidades diferentes.
Cu£les son las limitaciones?
La mayor limitacin pr£ctica es el acceso. En el momento del anuncio, Google estaba desplegando Argon para ciberdefensores de confianza a trav←s de su programa Fairwind, con una disponibilidad m£s amplia planificada para una etapa posterior.
Eso significa que los resultados publicados no deben tratarse autom£ticamente como independientemente reproducibles por usuarios ordinarios.
Una puntuacin alta en una evaluacin comparativa tampoco establece que Argon superar£ a otros modelos en cada lenguaje de programacin, tarea de investigacin o proyecto del mundo real.
Para obtener m£s informacin, consulta el anuncio oficial de Gemini 4 Argon de Google.
GPT-6 Astra: Razonamiento avanzado, programacin y uso del ordenador
OpenAI describe a GPT-6 Astra como su modelo para tareas profesionales exigentes, que incluyen razonamiento complejo, desarrollo de software, investigacin, creacin de documentos y uso del ordenador.
Su valor no se limita a producir una buena respuesta en una sola interaccin. Para flujos de trabajo adecuados, el objetivo es razonar sobre un problema, utilizar las herramientas disponibles y trabajar hacia un resultado claramente definido.
Fortalezas clave
Razonamiento avanzado
GPT-6 Astra est£ destinado a problemas que requieren m£s que recuperar un dato o generar una respuesta corta. Se puede evaluar en razonamiento matem£tico, planificacin, preguntas t←cnicas complejas y tareas que involucran mltiples restricciones.
Por ejemplo, un gerente de producto podr■a pedirle que compare estrategias de productos competidores, identifique riesgos, cree un marco de toma de decisiones y elabore un plan de implementacin.
Desarrollo de software y depuracin de cdigo
Astra puede ayudar a los desarrolladores a generar cdigo, inspeccionar implementaciones existentes, diagnosticar errores y realizar tareas de ingenier■a m£s complicadas.
Las pruebas tiles incluyen depurar un proyecto desconocido, modificar mltiples archivos, generar pruebas unitarias y verificar si la implementacin final cumple con los requisitos.
Flujos de trabajo con agentes y uso del ordenador
OpenAI tambi←n documenta capacidades relacionadas con el uso del ordenador. Sin embargo, la automatizacin real depende de las herramientas, los permisos y las salvaguardas proporcionadas por el entorno en el que se ejecuta el modelo.
La capacidad de un modelo para planificar una tarea no significa que cada interfaz de chat le permita autom£ticamente navegar por sitios web, operar aplicaciones o ejecutar cdigo.
Cu£les son las limitaciones?
GPT-6 Astra tiene un precio de token de API est£ndar m£s alto que los otros dos modelos de esta comparacin. Sus tarifas publicadas son de $10 por milln de tokens de entrada y $50 por milln de tokens de salida, antes de los cargos aplicables por almacenamiento en cach←, herramientas y otros costos.
Para los usuarios que ejecutan muchas conversaciones largas o grandes flujos de trabajo automatizados, los costos pueden acumularse r£pidamente.
Por lo tanto, el modelo debe evaluarse en funcin de la calidad del trabajo completado, no solo de su inteligencia bruta. Si una alternativa menos costosa produce resultados igualmente confiables para una tarea rutinaria, pagar por el modelo m£s caro puede no ser necesario.
Lee m£s en la documentacin de GPT-6 Astra de OpenAI.
Claude Opus 5.5: Agentes de programacin y tareas de larga ejecucin
Claude Opus 5.5 est£ posicionado en torno a la ingenier■a de software exigente, flujos de trabajo con agentes de larga ejecucin y trabajo profesional. Su atractivo para muchos desarrolladores es la posibilidad de delegar una tarea complicada manteniendo los requisitos originales durante todo el proceso.
Esto es particularmente importante cuando un proyecto involucra varios archivos, mltiples dependencias o una larga secuencia de decisiones.
Fortalezas clave
Comprensin del cdigo base
Un modelo de programacin til debe comprender cmo interactan las diferentes partes de un proyecto. Debe ser capaz de identificar la causa de un error, determinar qu← archivos necesitan cambios y evitar introducir regresiones en otros lugares.
Claude Opus 5.5 es un candidato slido para evaluar en estos flujos de trabajo, especialmente cuando la tarea requiere atencin sostenida a la estructura y los requisitos de un proyecto.
Instrucciones complejas y redaccin
Muchas tareas profesionales implican instrucciones detalladas que no pueden reducirse a una sola pregunta. Un usuario puede especificar una audiencia, tono, restricciones t←cnicas, reglas de formato y una lista de entregables requeridos.
Se puede evaluar a Claude en funcin de lo bien que sigue esas restricciones, mantiene la coherencia y produce un trabajo que requiere una edicin m■nima.
Flujos de trabajo con agentes de larga ejecucin
Para los equipos de desarrollo, es posible que un agente de IA necesite inspeccionar un proyecto, realizar cambios, ejecutar pruebas, interpretar errores y revisar su implementacin.
La cantidad de pasos completados con ←xito suele ser m£s significativa que la calidad de la primera respuesta.
Cu£les son las limitaciones?
Un modelo capaz an puede sobrecomplicar una tarea, hacer suposiciones incorrectas o consumir asignaciones de uso sustanciales durante una sesin larga.
Los l■mites de acceso y las reglas de suscripcin tambi←n importan. Las discusiones de la comunidad mencionan con frecuencia los l■mites de uso, incluso cuando los usuarios est£n satisfechos con la calidad del modelo.
Las tarifas de API est£ndar publicadas para Claude Opus 5.5 son de $4 por milln de tokens de entrada y $20 por milln de tokens de salida. Estas son m£s bajas que las tarifas est£ndar de Astra, aunque el costo real depende de los patrones de uso, el almacenamiento en cach← y los servicios adicionales.
Consulta la documentacin oficial de Claude Opus de Anthropic para obtener informacin actualizada sobre productos y precios.
Qu← nos dicen realmente las evaluaciones comparativas?
Las puntuaciones de las evaluaciones comparativas son tiles para comprender las capacidades de un modelo, pero no cuentan toda la historia.
Diferentes pruebas miden diferentes habilidades. Un modelo que funciona bien en un benchmark largo de ingenier■a de software puede no ser la mejor opcin para investigacin basada en hechos, redaccin o an£lisis visual.
El anuncio de Argon de Google y los resultados de evaluacin publicados de GPT-6 Astra proporcionan varios puntos de comparacin tiles.
Resultados seleccionados de evaluaciones comparativas de programacin
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Aproximadamente 78% | 74.1% | Aproximadamente 74% |
| FrontierSWE v2 | Ver evaluacin publicada por Google | Ventaja reportada en las comparaciones disponibles | Ver evaluacin publicada por Google |
| Terminal-Bench 4.0 | Ver evaluacin publicada por Google | 57.9% en los resultados publicados por OpenAI | Pueden aplicarse diferentes resultados de evaluacin |
Fuentes: Anuncio de Argon de Google, Documentacin del modelo Astra de OpenAI y la comparacin de octubre de 2026 de Argon y sus competidores.
Importante: Estas cifras deben tratarse como resultados reportados, no como una comparacin independiente totalmente controlada. Los resultados pueden diferir segn la versin del modelo, el entorno de prueba, el acceso a herramientas, la configuracin de razonamiento y la fecha de evaluacin. Cuando las fuentes originales no establecen una cifra directamente comparable, la tabla evita deliberadamente inventar una.
Los resultados disponibles tambi←n ilustran por qu← una clasificacin universal es engaosa. Se ha reportado que Argon lidera en DeepSWE v1.1, mientras que Astra u Opus pueden desempearse de manera diferente en otras evaluaciones de ingenier■a de software.
Un mejor enfoque es preguntarse qu← evaluacin comparativa se asemeja a tu carga de trabajo real.
- Para el mantenimiento de cdigo, prioriza las tareas reales en repositorios y las tasas de aprobacin de pruebas.
- Para la investigacin, mide la precisin f£ctica y si las citas respaldan las afirmaciones.
- Para flujos de trabajo con agentes, mide la finalizacin de extremo a extremo y la recuperacin ante errores.
- Para la redaccin comercial, evala la precisin, el cumplimiento de instrucciones y el tiempo de edicin.
La evaluacin comparativa es un punto de partida. Tu propia tarea es la prueba final.
Qu← dicen los usuarios de Reddit sobre estos modelos?
Reddit ofrece una perspectiva diferente a los anuncios oficiales. Los usuarios discuten los aspectos del rendimiento del modelo que notan durante el trabajo diario, incluyendo la calidad del cdigo, la creatividad, la velocidad, los l■mites de uso y la cantidad de orientacin que requiere un modelo.
Estas discusiones son evidencia til de las prioridades de los usuarios, pero son anecdticas. Una publicacin no establece que un modelo sea objetivamente mejor para todos los usuarios.
Gemini 4 Argon: Puntuaciones impresionantes, pero el acceso sigue siendo una preocupacin
En la discusin de r/singularity sobre los benchmarks de Gemini 4 Argon, los usuarios debatieron sobre los resultados reportados por Google en programacin, ciberseguridad y tareas profesionales.
Una pregunta recurrente fue si el rendimiento del modelo se traducir■a en beneficios pr£cticos y cu£ndo estar■a disponible un acceso m£s amplio.
Esto crea una distincin til para un art■culo comparativo: el liderazgo en evaluaciones comparativas no es lo mismo que la utilidad cotidiana. Los usuarios necesitan una forma de probar el modelo en sus propias tareas antes de decidir si vale la pena adoptarlo.
GPT-6 Astra vs. Claude Opus 5.5: Calidad, velocidad y l■mites de uso
La discusin de r/ClaudeAI que compara Opus 5.5 con GPT-6 Astra ilustra lo r£pido que pueden cambiar las preferencias de la comunidad entre los lanzamientos de modelos.
Los participantes describieron diferentes experiencias con los modelos. Algunos prefirieron Astra, mientras que otros elogiaron las capacidades de Opus 5.5 pero criticaron la cantidad de orientacin que a veces necesitaban proporcionar.
La leccin m£s amplia es que la calidad del modelo depende en parte de la tarea y del flujo de trabajo del usuario. Un modelo que funciona bien para un desarrollador puede ser menos adecuado para los requisitos de otro proyecto.
Los l■mites de uso son otra preocupacin. En una discusin de Reddit sobre la eleccin entre Opus 5.5 y Astra, un usuario plante preguntas sobre agotamiento del uso y si cambiar de suscripcin ofrecer■a un mejor valor.
Para los usuarios frecuentes, el costo del trabajo sostenido puede importar tanto como la calidad de las respuestas individuales.
Una tarea creativa simple puede producir resultados diferentes
En una comparacin de Reddit entre Opus 5.5, GPT-6 Astra y otros modelos, los usuarios discutieron dar a varios modelos la misma instruccin para crear una animacin corta de un avin de papel.
Las respuestas reflejaron diferentes preferencias: algunos usuarios favorecieron la calidad de la animacin, mientras que otros prefirieron la interpretacin o la direccin creativa de un modelo diferente.
Este es un recordatorio til de que las comparaciones de modelos no se limitan a la programacin y al razonamiento. Para el trabajo creativo, la calidad de la produccin puede ser subjetiva, y el modelo m£s apropiado depende del resultado que desee el usuario.
Qu← podemos aprender de las discusiones?
A lo largo de estos hilos, destacan cuatro temas:
- El rendimiento en el mundo real importa m£s que una puntuacin titular. Los usuarios quieren modelos que resuelvan sus problemas espec■ficos.
- El cumplimiento de instrucciones afecta la productividad. Un modelo slido es m£s til cuando comprende las restricciones sin aclaraciones repetidas.
- Los l■mites de uso afectan la experiencia general. Los resultados de alta calidad son menos valiosos si los usuarios no pueden mantener su flujo de trabajo.
- Diferentes tareas recompensan diferentes fortalezas. La produccin creativa, la programacin, la investigacin y la automatizacin no deben evaluarse utilizando los mismos criterios.
Estas observaciones deber■an fundamentar las pruebas de este art■culo, en lugar de reemplazarlas.
Cmo comparar los tres modelos en tareas del mundo real
La comparacin m£s til dar■a a los tres modelos la misma tarea, los mismos materiales de entrada y los mismos criterios de evaluacin.
Si los tres modelos est£n disponibles para ti, las siguientes pruebas pueden ayudarte a determinar cu£l se adapta a tu flujo de trabajo.
Prueba 1: Programacin y depuracin
Proporciona a cada modelo el mismo cdigo base pequeo que contenga un error reproducible. P■dele que identifique el problema, implemente una solucin, escriba pruebas y explique los cambios.
Evala:
- Si se solucion el error original
- Si las pruebas existentes an se aprueban
- Si se introducen nuevos errores
- Cu£ntas instrucciones de seguimiento se necesitan
- Tiempo total y uso de tokens
Un modelo que produce una explicacin plausible pero no supera las pruebas no debe considerarse el ganador.
Prueba 2: Investigacin y an£lisis de documentos
Proporciona el mismo conjunto de informes, tablas y documentos fuente. Pide a cada modelo que resuma la evidencia, extraiga cifras importantes, identifique contradicciones y prepare un informe corto con referencias.
Mide la precisin f£ctica, la calidad de las citas, la cobertura de la informacin importante y la cantidad de correccin manual requerida.
Esta prueba es especialmente til para analistas, estudiantes, consultores y equipos de contenido.
Prueba 3: Ejecucin de proyectos de mltiples pasos
Asigna a cada modelo una tarea que requiera varios entregables, como analizar una idea de producto, desarrollar un plan de proyecto, crear una tabla de tareas y preparar un informe final.
Evala si sigue la secuencia requerida, mantiene la coherencia entre los entregables y verifica el resultado final.
Si el entorno proporciona herramientas, registra si el modelo las usa correctamente. Mant←n la inteligencia del modelo separada de las capacidades de la plataforma que lo ejecuta.
Prueba 4: Redaccin y cumplimiento de instrucciones
Proporciona un informe de redaccin detallado con un pblico objetivo, tono, puntos requeridos, longitud y restricciones.
Compara los resultados en cuanto a precisin f£ctica, legibilidad, estructura, originalidad y cumplimiento con el informe.
Para los equipos de marketing, esto puede revelar qu← modelo produce borradores iniciales utilizables y cu£l requiere m£s edicin.
Utiliza un marco de puntuacin coherente
Una evaluacin simple de 100 puntos puede hacer que los resultados sean m£s f£ciles de comparar.
| Criterio | Peso sugerido |
|---|---|
| Precisin y correccin | 30 |
| Finalizacin de la tarea | 25 |
| Cumplimiento de instrucciones | 15 |
| Calidad de la produccin | 15 |
| Velocidad y eficiencia | 10 |
| Costo | 5 |
| Total | 100 |
Los pesos deben cambiar segn la tarea. Por ejemplo, las pruebas de programacin deben poner m£s ←nfasis en el cdigo funcional y la aprobacin de pruebas, mientras que las pruebas de investigacin deben priorizar la precisin f£ctica y la calidad de las fuentes.
No publiques una puntuacin como una prueba independiente a menos que realmente hayas ejecutado el experimento. Si el acceso a Argon est£ restringido, utiliza una comparacin claramente etiquetada de los resultados publicados y reserva la seccin de pruebas independientes para los modelos que realmente puedas evaluar.
Comparacin de precios: Qu← modelo ofrece un mejor valor?
Las tarifas de API est£ndar publicadas para estos modelos proporcionan un punto de partida til.
| Modelo | Entrada por 1M de tokens | Salida por 1M de tokens |
|---|---|---|
| Gemini 4 Argon | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
Fuentes: Google, OpenAI y Anthropic.
Con estas tarifas est£ndar publicadas, Argon tiene el precio por token indicado m£s bajo, seguido de Opus 5.5 y Astra. Sin embargo, esto no convierte autom£ticamente a Argon en la opcin pr£ctica m£s barata para todos los usuarios, especialmente mientras el acceso siga siendo restringido.
Ejemplo: Una tarea que utiliza 100,000 tokens de entrada y 20,000 tokens de salida
Asumiendo que se aplican las tarifas publicadas, sin descuentos por almacenamiento en cach←, tarifas de herramientas u otros cargos:
- Gemini 4 Argon: $0.20 de entrada + $0.20 de salida = $0.40
- GPT-6 Astra: $1.00 de entrada + $1.00 de salida = $2.00
- Claude Opus 5.5: $0.40 de entrada + $0.40 de salida = $0.80
Este es un ejemplo de costo por token, no una afirmacin de que los modelos utilicen la misma cantidad de tokens para finalizar la misma tarea.
Para una comparacin m£s justa, calcula el costo de producir un resultado exitoso. Si un modelo necesita cinco reintentos y otro completa la tarea en un solo intento, sus costos efectivos pueden diferir significativamente de la relacin est£ndar de precio por token.
Los planes de suscripcin tambi←n tienen sus propios precios, l■mites y reglas de uso. No compares los precios de las API directamente con las tarifas de suscripcin como si fueran equivalentes.
Qu← modelo de IA es el mejor para tus necesidades?
El modelo adecuado depende de lo que hagas, con qu← frecuencia uses la IA y cmo sea un resultado exitoso.
Para desarrolladores de software
Considera probar GPT-6 Astra y Claude Opus 5.5 en tu cdigo base real. Ambos est£n posicionados para un trabajo de ingenier■a exigente, pero su rendimiento relativo depender£ de tu lenguaje, herramientas y la complejidad del proyecto.
Tambi←n vale la pena seguir a Gemini 4 Argon por sus resultados reportados en ingenier■a de software, sujeto a acceso y verificacin independiente.
Para investigadores y analistas
Prioriza la extraccin precisa de informacin, las citas confiables, el manejo de documentos largos y la capacidad de distinguir los hechos de las suposiciones.
Para trabajos que involucren grandes colecciones de archivos, prueba si el modelo puede encontrar detalles relevantes sin pasar por alto evidencia contradictoria.
Para creadores de contenido y especialistas en marketing
Compara lo bien que cada modelo sigue un informe de contenido, mantiene un tono constante, organiza la informacin y produce borradores que requieren una edicin m■nima.
Un flujo de trabajo pr£ctico podr■a incluir investigacin de palabras clave, elaboracin de esquemas, redaccin de borradores, verificacin de hechos y adaptacin de contenido para diferentes audiencias. La revisin humana sigue siendo esencial, especialmente para las afirmaciones basadas en hechos y el contenido de SEO.
Para usuarios de negocios
Enfcate en la finalizacin de tareas, el an£lisis de documentos, los flujos de trabajo en hojas de c£lculo, los informes y la confiabilidad de los resultados.
Para tareas recurrentes, incluso una pequea reduccin en el tiempo de revisin manual puede importar m£s que una modesta mejora en las puntuaciones de las evaluaciones comparativas.
Para usuarios conscientes del presupuesto
Compara el costo real de completar tus tareas comunes en lugar de seleccionar un modelo bas£ndote nicamente en su inteligencia anunciada.
Si un modelo menos costoso cumple constantemente con tus requisitos, puede ser la mejor opcin para el d■a a d■a. Reserva los modelos m£s caros para trabajos donde sus capacidades adicionales marquen una diferencia medible.
Cmo explorar modelos de IA y completar tareas en ChatGOAT AI
Comparar modelos es til, pero el beneficio real de la IA proviene de aplicarla a tu propio trabajo.
ChatGOAT AI proporciona un espacio de trabajo de IA para los modelos y herramientas compatibles, lo que ayuda a los usuarios a explorar flujos de trabajo de redaccin, investigacin, an£lisis y creacin asistidos por IA sin tratar cada tarea como un experimento independiente.
Cuando Gemini 4 Argon, GPT-6 Astra y Claude Opus 5.5 est£n habilitados en el selector de modelos actual de ChatGOAT, los usuarios pueden explorar sus respuestas dentro de la plataforma y evaluar qu← enfoque funciona mejor para sus necesidades. La disponibilidad puede variar segn el modelo y la integracin, as■ que consulta la lista de modelos activos antes de comenzar.
Qu← puedes hacer con IA en ChatGOAT AI?
Utiliza la IA para generar ideas de art■culos, crear esquemas, redactar publicaciones de blog, reescribir p£rrafos, resumir materiales largos o adaptar contenido para diferentes audiencias.
Por ejemplo, un especialista en SEO puede desarrollar un esquema de blog, redactar un art■culo comparativo, preparar respuestas a preguntas frecuentes y revisar el contenido para mejorar la claridad y la intencin de bsqueda.
Analizar informacin y documentos
La IA puede ayudar a extraer puntos clave de los materiales proporcionados, comparar informes, organizar hallazgos de investigacin y convertir notas no estructuradas en un resumen m£s claro.
Por ejemplo, un usuario de negocios puede convertir las notas de una reunin en un plan de accin, crear una tabla comparativa y preparar un resumen ejecutivo conciso.
Crear tablas estructuradas y planes de proyectos
Utiliza la IA para organizar comparaciones de productos, preparar listas de tareas, crear matrices de investigacin y elaborar planes de proyectos estructurados.
Un equipo de marketing podr■a usar este flujo de trabajo para comparar las caracter■sticas de los competidores, mapear palabras clave en p£ginas de destino y organizar un calendario de contenidos.
Asistencia en programacin y resolucin de problemas
Para flujos de trabajo de programacin compatibles, la IA puede explicar cdigo no familiar, sugerir pasos de depuracin, redactar funciones y ayudar a organizar la documentacin t←cnica.
Prueba siempre el cdigo generado y revisa los cambios antes de usarlos en produccin.
Explorar la creacin de im£genes
ChatGOAT AI tambi←n ofrece capacidades de generacin de im£genes mediante IA a trav←s de sus herramientas y modelos de im£genes compatibles. Esto puede ayudar a los usuarios a crear ilustraciones, conceptos visuales, gr£ficos para redes sociales y otros recursos creativos.
La generacin de im£genes es una capacidad separada del razonamiento del modelo de texto. No asumas que cada modelo de esta comparacin puede generar im£genes directamente solo porque el espacio de trabajo incluye herramientas de im£genes.
Crear un flujo de trabajo m£s eficiente
En lugar de tratar cada tarea como una instruccin aislada, los usuarios pueden dividir un proyecto en pasos: investigacin, planificacin, borrador, verificacin y entrega final.
El flujo de trabajo m£s til es aquel que produce resultados precisos con menos trabajo repetitivo, no necesariamente el que utiliza el modelo m£s avanzado para cada paso.
Explora ChatGOAT AI para ver los modelos y herramientas de IA actualmente compatibles y disponibles para tu flujo de trabajo.
Preguntas frecuentes
Es Gemini 4 Argon mejor que GPT-6 Astra?
No en todas las situaciones. Google ha reportado resultados slidos para Argon en evaluaciones comparativas seleccionadas de ingenier■a y trabajo profesional, mientras que OpenAI publica resultados slidos para Astra en varias evaluaciones exigentes. Las restricciones de acceso y las diferencias en los m←todos de prueba hacen que una clasificacin universal sea prematura.
Es Claude Opus 5.5 mejor que GPT-6 Astra para programar?
Ambos est£n diseados para tareas exigentes de ingenier■a de software. La mejor opcin depende del cdigo base, el lenguaje de programacin, las herramientas disponibles y la calidad de la implementacin final. Compara las tasas de aprobacin de pruebas, los riesgos de regresin, el nmero de iteraciones y el costo total en la misma tarea.
Qu← modelo es mejor para el razonamiento complejo?
GPT-6 Astra y Gemini 4 Argon est£n posicionados para el razonamiento complejo y el trabajo de mltiples pasos, mientras que Claude Opus 5.5 est£ diseado para flujos de trabajo exigentes profesionales y con agentes. Utiliza pruebas espec■ficas de tareas para determinar qu← modelo funciona mejor para tus necesidades.
Qu← modelo es el m£s barato?
Bas£ndose en las tarifas est£ndar de API publicadas anteriormente, Gemini 4 Argon tiene el precio por token m£s bajo, seguido de Claude Opus 5.5 y GPT-6 Astra. Sin embargo, la disponibilidad restringida de Argon afecta si la mayor■a de los usuarios realmente pueden acceder a ese precio. El costo total de la tarea tambi←n depende del uso de tokens, los reintentos, el almacenamiento en cach← y las herramientas.
Puedo usar Gemini 4 Argon en este momento?
Google anunci inicialmente Argon para ciberdefensores de confianza a trav←s del programa Fairwind, con planes de acceso m£s amplio. Consulta el ltimo anuncio oficial de Google para conocer cambios en la disponibilidad antes de depender de ←l para un proyecto.
Puedo comparar estos modelos en ChatGOAT AI?
Puedes explorar los modelos y herramientas compatibles con el espacio de trabajo actual de ChatGOAT AI. Para comparar los tres directamente, verifica que Gemini 4 Argon, GPT-6 Astra y Claude Opus 5.5 est←n disponibles en el selector de modelos actual. Si uno no est£ disponible, compara su documentacin publicada con los resultados pr£cticos de los modelos accesibles.
Qu← modelo es el mejor para el trabajo diario?
No hay una respuesta universal. Considera las tareas que realizas con m£s frecuencia, qu← tan precisos deben ser los resultados, la cantidad de edicin requerida, tu presupuesto y los l■mites de uso de tu plataforma preferida. Probar algunas tareas representativas es m£s til que elegir nicamente por reputacin.
Veredicto final: Elige el modelo que mejor complete tu trabajo
Gemini 4 Argon, GPT-6 Astra y Claude Opus 5.5 representan diferentes enfoques de la asistencia avanzada de IA. Argon ha reportado fortalezas en evaluaciones seleccionadas de ingenier■a y trabajo profesional, Astra se dirige a tareas exigentes de razonamiento y uso del ordenador, y Opus 5.5 se centra en agentes de programacin y flujos de trabajo profesionales de larga ejecucin.
El mejor modelo no es necesariamente el que tiene la puntuacin m£s alta o la API m£s cara. Es aquel que completa con confiabilidad tus tareas, sigue tus instrucciones, se ajusta a tu presupuesto y requiere la menor intervencin innecesaria.
Utiliza las evaluaciones comparativas oficiales para reducir tus opciones, las discusiones de Reddit para entender las preguntas que se hacen los usuarios reales y pruebas pr£cticas constantes para tomar la decisin final.
Con ChatGOAT AI, puedes explorar modelos y herramientas de IA compatibles para redaccin, investigacin, an£lisis y trabajo creativo en un solo espacio de trabajo. Comienza con una tarea que realmente necesites completar, compara la calidad de los resultados y elige el flujo de trabajo que facilite tu trabajo.