Wichtigste Erkenntnisse
- Kimi K3.1 Pro verfügt über ein Kontextfenster von 1 Million Token und ist für Programmierung, 3D-Erstellung, Finanzrecherchen und lang laufende Agentenaufgaben konzipiert.
- Die API kostet 2 $ pro Million Input-Token und 10 $ pro Million Output-Token, wobei gecachte Inputs mit einem Rabatt von 90 % verfügbar sind.
- Kimi erreicht 65,7 % bei Terminal-Bench 4.0, was nahe an den Wert von Claude Opus 5.5 (66,4 %) herankommt und vor GPT-6 Astra (58,2 %) liegt.
- Kimi ist führend bei mehreren Benchmarks für lange Kontexte und Finanzanwendungen, darunter SWE-Marathon v1.1 und OfficeQA Pro v2.
- GPT-6 Astra schneidet bei Terminal-Bench Science 0.1 deutlich besser ab, was darauf hindeutet, dass es für wissenschaftliche und forschungsorientierte Agenten-Workflows stärker sein könnte.
- Kimis niedrigerer Token-Preis bedeutet nicht zwangsläufig eine niedrigere Endrechnung, da Agentenaufgaben viele Output-Token verbrauchen können.
- ChatGOAT AI ermöglicht Benutzern den Zugriff auf Kimi K3.1 Pro neben Claude Opus 5.5, GPT-6 Astra, Gemini, Grok, DeepSeek und anderen Modellen in einer einzigen Benutzeroberfläche.
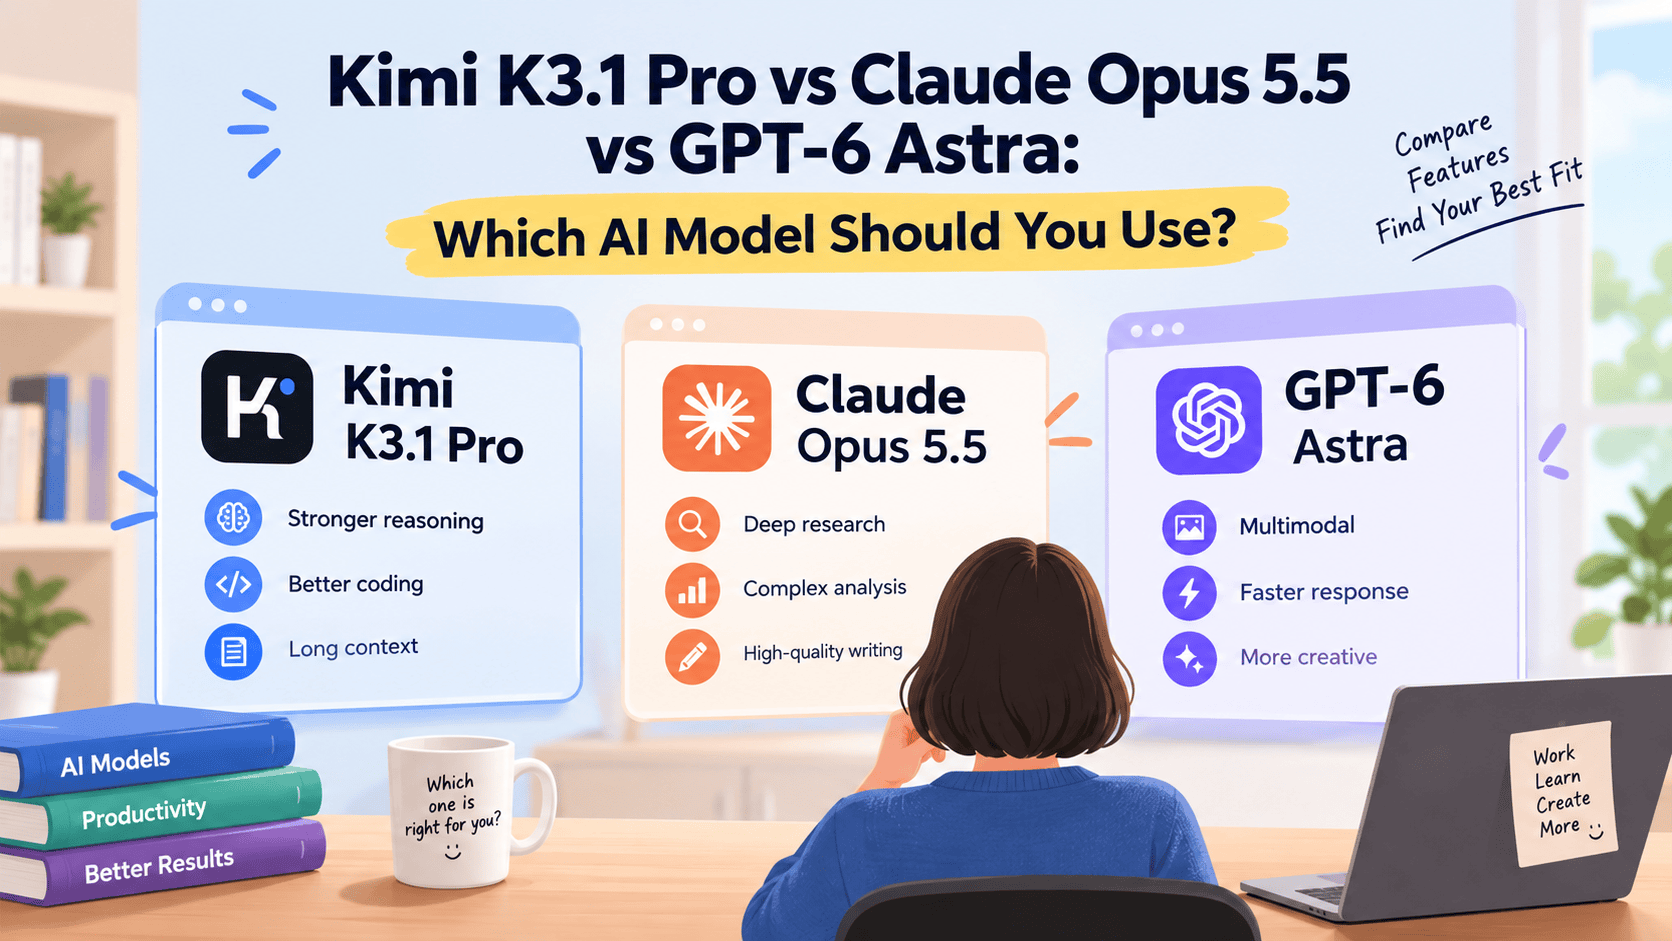
Kimi K3.1 Pro vs. Claude Opus 5.5 vs. GPT-6 Astra: Welches KI-Modell sollten Sie verwenden?
Bei der Auswahl eines KI-Modells geht es längst nicht mehr nur darum, das „cleverste“ auszuwählen. Das beste Modell hängt davon ab, was Sie entwickeln: einen Programmier-Agenten, einen Finanzforschungsassistenten, einen 3D-Prototypen, einen Forschungs-Workflow oder eine kostensensitive Produktions-App.
Dieser Vergleich betrachtet Kimi K3.1 Pro, Claude Opus 5.5 und GPT-6 Astra anhand realer Aufgaben, Benchmark-Ergebnissen, Preisen und praktischen Stärken.
Was ist Kimi K3.1 Pro?
Kimi K3.1 Pro ist das erste Modell der K3.1-Serie von Moonshot AI und das bisher leistungsfähigste Modell des Unternehmens. Es ist ein Modell mit 3 Billionen Parametern und einem Kontextfenster von 1 Million Token, wodurch es sich für große Codebasen, umfangreiche Berichte, mehrstufige Agentenaufgaben und komplexe Forschungsprojekte eignet.
Moonshot positioniert K3.1 Pro um vier wesentliche Verbesserungen herum:
- Programmierung
- 3D-Erstellung
- Finanzrecherche
- Langfristige Agentenfunktionen
Es unterstützt zudem Tools wie Unity, Unreal, Godot und Three.js, was es für Entwickler interessant macht, die Spiele, interaktive Webseiten und 3D-Erlebnisse entwickeln.
Preise für Kimi K3.1 Pro
| Tarif / Zugriff | Preis | Hinweise |
|---|---|---|
| API-Input | 2 $ pro Million Token | Niedriger als der vorherige Input-Preis von Kimi K3 (3 $). |
| API-Output | 10 $ pro Million Token | Niedriger als der vorherige Output-Preis von Kimi K3 (15 $). |
| Gecachter Input | Ca. 0,20 $ pro Million Token | Basierend auf einem Cache-Rabatt von 90 %. |
| Highspeed-Version | Etwa das Doppelte der Standardpreise | Bietet eine ca. 2- bis 3-mal schnellere Ausgabe bei ähnlicher Intelligenz. |
Der niedrige Listenpreis ist attraktiv, aber es ist wichtig, die tatsächliche Token-Nutzung zu verfolgen. In einem Artificial-Analysis-Test verbrauchte Kimi etwa 150 Millionen Output-Token, was über dem Median von 87 Millionen liegt und die Gesamtkosten für lange Agentenaufgaben erhöhen kann.
Benchmarks für Kimi K3.1 Pro
Kimi K3.1 Pro schneidet insbesondere bei Programmier-Agenten, langfristiger Softwareentwicklung, Web-Recherche und der Analyse von Finanzdokumenten sehr gut ab. Es ist jedoch nicht für jede Aufgabe das beste Modell.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Was es bedeutet |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | 58,2 % | Kimi liegt bei der Terminal-Programmieragentenarbeit fast gleichauf mit Claude. |
| SWE-Marathon v1.1 | 51,7 % | 46,3 % | 42,5 % | Kimi ist führend bei langfristiger Softwareentwicklung. |
| HLE-Full mit Tools | 70,0 % | 67,7 % | 57,2 % | Kimi zeigt starke Leistungen bei schwierigem Wissens-Reasoning mit Tools. |
| BrowseComp | 92,1 % | 90,8 % | 91,5 % | Alle drei sind stark in der Web-Recherche. |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | Kimi ist stark bei der Analyse von Finanz- und BüroDokumenten. |
| Terminal-Bench Science 0.1 | 38,1 | 63,3 | 68,1 | GPT-6 Astra ist führend bei wissenschaftsorientierten Terminal-Workflows. |
Die wichtigste Lehre ist einfach: Kimi ist nicht nur ein „billigeres Claude“. Es ist äußerst wettbewerbsfähig bei agentenbasierter Programmierung und dokumentenlastiger Arbeit, aber GPT-6 Astra ist möglicherweise die bessere Option für wissenschaftliche Forschungsworkflows.
Kimi K3.1 Pro vs. Claude Opus 5.5 vs. GPT-6 Astra
1. Beheben von Fehlern in einer echten Codebasis
Aufgabe: Übergeben Sie jedem Modell dasselbe Repository mit mehreren versteckten Fehlern. Bitten Sie es, das Problem zu lokalisieren, einen Fix zu schreiben, Tests hinzuzufügen und die Änderung zu erklären.
Was zu messen ist:
- Ob die Ursache gefunden wird
- Anzahl der Wiederholungsversuche
- Ob Tests bestehen
- Code-Qualität
- Gesamt-Token und Kosten
Erwartetes Ergebnis: Kimi schneidet bei langfristigen Engineering-Benchmarks gut ab, aber unabhängige Tests mit echten Repositories deuten darauf hin, dass es beim Beheben von Legacy-Fehlern nicht immer führend ist. Ein Drittanbietertest ergab, dass Kimi bei einer realen Fehlerbehebungsbewertung 36 Punkte erzielte und damit hinter den 41,7 Punkten von Claude Opus 5.5 zurückblieb.
Beste Wahl: Claude Opus 5.5 für schwieriges Debugging von Legacy-Code; Kimi K3.1 Pro für größere Refactorings und agentengesteuerte Entwicklung.
2. Verwandeln eines PRD in eine funktionierende Web-App
Aufgabe: Stellen Sie ein Produktspezifikationsdokument (PRD) zur Verfügung und bitten Sie jedes Modell, eine funktionierende Webanwendung zu erstellen, einschließlich Frontend, Backend, Datenbankschema und Bereitstellungsanweisungen.
Was zu messen ist:
- Vollständigkeit der Funktionen
- Code-Organisation
- UI-Qualität
- Umgang mit einer Anforderungsänderung mitten im Projekt
- Ob die App ohne manuelle Reparatur läuft
Erwartetes Ergebnis: Kimi ist für agentenbasierte Programmierung konzipiert und unterstützt Front-End- und 3D-orientierte Workflows, aber unabhängige Evaluierungen legen nahe, dass es einigen westlichen Flaggschiffmodellen beim visuellen Feinschliff, bei Animationen und bei der Website-Erstellung möglicherweise noch hinterherhinkt.
Beste Wahl: Kimi für schnelle Engineering-Prototypen; Claude oder GPT-6 Astra, wenn visuelle Qualität und iteratives Design Priorität haben.
3. Analyse eines langen Finanzberichts
Aufgabe: Laden Sie einen 300-seitigen Geschäftsbericht, Branchenbericht und eine Tabellenkalkulation hoch. Bitten Sie das Modell, Finanzkennzahlen zu extrahieren, Risiken zu identifizieren, eine Dreijahresprognose zu erstellen und für jede Behauptung Seitenzahlen zu zitieren.
Was zu messen ist:
- Genauigkeit der extrahierten Zahlen
- Qualität der Zitate
- Fähigkeit, Daten dokumentenübergreifend zu verknüpfen
- Qualität des Finanzmodells
- Halluzinationsrate
Erwartetes Ergebnis: Dies ist einer der stärksten Anwendungsfälle von Kimi. Es erzielte 64,4 Punkte bei OfficeQA Pro v2 und lag damit vor Claude Opus 5.5 mit 62,2 und GPT-6 Astra mit 54,4 Punkten.
Beste Wahl: Kimi K3.1 Pro für lange Finanzdokumente, Tabellenkalkulationsanalysen und forschungsintensive geschäftliche Aufgaben.
4. Erstellen eines 3D-Prototypen
Aufgabe: Bitten Sie jedes Modell, anhand einer kurzen Beschreibung eine interaktive Three.js-Szene, ein Godot-Minispiel oder einen Unity-Prototypen zu erstellen.
Was zu messen ist:
- Asset-Qualität
- Vollständigkeit der Interaktion
- Tool-Nutzung
- Visueller Feinschliff
- Fähigkeit zur Überarbeitung nach Feedback
Erwartetes Ergebnis: Kimi ist in dieser Kategorie stark, da Moonshot gezielt die 3D-Erstellung und Tool-Integration verbessert hat. Es ist jedoch nicht automatisch das beste kreative Modell; unabhängige Tests zeigten Lücken bei einigen 3D- und Website-Generierungsaufgaben.
Beste Wahl: Kimi für schnelle, spielbare Prototypen; Claude oder GPT-6 Astra für kreative Ergebnisse mit höherem Feinschliff, abhängig von Ihren Testergebnissen.
5. Mehrstufige Online-Recherche
Aufgabe: Bitten Sie jedes Modell, einen Markt zu erforschen, 10 wichtige Unternehmen zu identifizieren, Behauptungen zu überprüfen und einen Bericht mit Quellen zu erstellen.
Was zu messen ist:
- Quellenqualität
- Faktische Genauigkeit
- Fähigkeit, Wiederholungen zu vermeiden
- Tiefe der Analyse
- Zuverlässigkeit der Zitate
Erwartetes Ergebnis: Kimi erzielte 92,1 % bei BrowseComp und lag damit knapp vor Claude Opus 5.5 und GPT-6 Astra. Dies deutet darauf hin, dass es sich hervorragend für den webbasierten Informationsabruf eignet.
Beste Wahl: Kimi für allgemeine Web-Recherchen; GPT-6 Astra für wissenschaftliche Forschung und technische Untersuchungen.
6. Kosten- und Geschwindigkeitstest
Aufgabe: Führen Sie denselben 10-stufigen Agenten-Workflow für jedes Modell aus und vergleichen Sie Gesamtkosten, Latenz, Output-Token, Wiederholungen und die finale Qualität.
| Metrik | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| API-Input-Preis | 2 $ / Million Token | Höher | Variiert je nach Anbieter und Tarif. |
| API-Output-Preis | 10 $ / Million Token | Höher | Variiert je nach Anbieter und Tarif. |
| Artificial-Analysis-Aufgabenkosten | 2,11 $ | 5,98 $ | 3,26 $ |
| Output-Token-Nutzung | In einigen Agententests hoch | Im zitierten Test niedriger | Im zitierten Test moderat |
| Am besten geeignet für | Langer Kontext, Programmieragenten, Finanzen | Anspruchsvolle Softwareentwicklung | Forschungs- und wissenschaftliche Agenten |
Kimis niedrigerer Preis ist real, aber Ihre Endrechnung hängt davon ab, wie viele Token das Modell verbraucht. Bei repetitiven Prompts kann Caching einen großen Unterschied machen.
Welches Modell sollten Sie wählen?
| Anwendungsfall | Bestes Modell | Warum |
|---|---|---|
| Lange Finanzdokumente | Kimi K3.1 Pro | Starke OfficeQA-Leistung und 1M-Token-Kontext. |
| Agentenbasierte Programmierung | Kimi K3.1 Pro oder Claude Opus 5.5 | Kimi ist bei einigen langfristigen Programmiertests führend; Claude bleibt exzellent bei der Terminal-Programmierung. |
| Behebung von Legacy-Fehlern | Claude Opus 5.5 | Stärker bei einigen unabhängigen Tests zur Fehlerbehebung in echten Repositories. |
| Wissenschaftliche Forschungsagenten | GPT-6 Astra | Führt Terminal-Bench Science 0.1 mit deutlichem Vorsprung an. |
| Kostensensitive API-Apps | Kimi K3.1 Pro | Niedrigere aufgeführte Input-/Output-Preise und starker Benchmark-Wert. |
| 3D- und Spielprototypen | Kimi K3.1 Pro | Entwickelt für 3D-Erstellung und Tools wie Unity, Unreal, Godot und Three.js. |
| Allgemeine Web-Recherche | Kimi K3.1 Pro | Bei BrowseComp leicht vorne. |
So testen Sie diese Modelle selbst
Verlassen Sie sich nicht nur auf Benchmark-Diagramme. Führen Sie denselben Prompt für jedes Modell aus und bewerten Sie die Ergebnisse.
Verwenden Sie dieses einfache Test-Framework:
- Wählen Sie eine Aufgabe aus, die Sie tatsächlich jede Woche ausführen.
- Schreiben Sie einen detaillierten Prompt mit klaren zu erbringenden Leistungen.
- Führen Sie ihn auf Kimi K3.1 Pro, Claude Opus 5.5 und GPT-6 Astra aus.
- Erfassen Sie die Qualität des Abschlusses, erforderliche Bearbeitungen, Latenz und Token-Nutzung.
- Wiederholen Sie den Test dreimal.
- Berechnen Sie die Kosten pro nutzbarem Ergebnis, nicht nur die Kosten pro Million Token.
Dieser Ansatz hilft Ihnen, den häufigsten Fehler zu vermeiden: ein Modell zu wählen, weil es einen Benchmark gewinnt, anstatt weil es in Ihrem Workflow am besten abschneidet.
Probieren Sie Kimi K3.1 Pro auf ChatGOAT AI aus
Sie benötigen keine separaten Konten oder API-Schlüssel, um diese Modelle zu vergleichen. ChatGOAT AI ist eine All-in-One-KI-Plattform, die Zugriff auf mehrere führende Modelle bietet, darunter Kimi K3.1 Pro, Claude Opus 5.5, GPT-6 Astra, Gemini 4 Carbon, Grok 4.7 und DeepSeek, in einem einzigen Workspace.
Mit ChatGOAT AI können Sie:
- Direkt in Ihrem Browser mit Kimi K3.1 Pro chatten.
- Kimi mit demselben Prompt mit Claude Opus 5.5 und GPT-6 Astra vergleichen.
- KI für Programmierung, Recherche, Schreiben, Tabellenkalkulationen, Präsentationen, Bilder und mehrstufige Agentenaufgaben nutzen.
- Zwischen Modellen wechseln, ohne Ihren Workflow neu aufzubauen oder mehrere Abonnements zu verwalten.
Wenn Sie beispielsweise einen Finanzbericht analysieren, können Sie Kimi K3.1 Pro bitten, Kennzahlen zu extrahieren und ein Modell zu erstellen, dann Claude Opus 5.5 bitten, die Logik zu überprüfen, oder GPT-6 Astra, Marktrisiken zu erforschen. Dieser „Modellwechsel“-Workflow ist oft nützlicher als sich auf einen einzigen KI-Anbieter festzulegen.
Häufig gestellte Fragen (FAQ)
Ist Kimi K3.1 Pro besser als Claude Opus 5.5?
Das hängt von der Aufgabe ab. Kimi ist bei einigen langfristigen Programmier-, Finanzanalyse- und Abruf-Benchmarks führend, während Claude Opus 5.5 bei Terminal-Bench 4.0 leicht voraus bleibt und für bestimmte reale Debugging-Aufgaben stärker sein kann.
Ist Kimi K3.1 Pro besser als GPT-6 Astra?
Für Langkontext-Programmierung, Finanzdokumente und allgemeine Web-Recherchen ist Kimi äußerst wettbewerbsfähig. Für wissenschaftliche Terminal-Workflows hat GPT-6 Astra basierend auf den Ergebnissen von Terminal-Bench Science 0.1 einen klaren Vorteil.
Wie viel kostet Kimi K3.1 Pro?
Kimi K3.1 Pro kostet über die API 2 $ pro Million Input-Token und 10 $ pro Million Output-Token. Gecachter Input ist für ca. 0,20 $ pro Million Token verfügbar.
Hat Kimi K3.1 Pro wirklich 1M Kontext?
Ja. Moonshot gibt an, dass K3.1 Pro ein Kontextfenster von 1 Million Token unterstützt, was für große Codebasen, lange Berichte und die Analyse mehrerer Dokumente nützlich ist.
Kann ich Kimi K3.1 Pro zum Programmieren verwenden?
Ja. Programmierung ist eine seiner Hauptstärken, insbesondere agentenbasierte Programmierung, langfristige Softwareentwicklung und terminalbasierte Entwicklungsaufgaben.
Kann ich Kimi K3.1 Pro auf ChatGOAT AI verwenden?
Ja. ChatGOAT AI führt Kimi K3.1 Pro neben Claude Opus 5.5, GPT-6 Astra, Gemini, Grok und DeepSeek in seiner Liste der verfügbaren Modelle auf.
Welches Modell ist am besten für Anfänger geeignet?
Für Anfänger ist ChatGOAT AI der ideale Einstieg, da Sie dort mehrere Modelle an einem Ort ausprobieren können. Nutzen Sie Kimi für lange Dokumente und Programmierung, Claude für sorgfältige Softwareentwicklung und GPT-6 Astra für forschungsintensive Aufgaben.
Sollte ich Kimi wählen, weil es billiger ist?
Nicht immer. Kimi hat einen niedrigeren Token-Preis, aber Agentenaufgaben können viele Output-Token generieren. Testen Sie den vollständigen Workflow und vergleichen Sie die Endkosten, nicht nur den veröffentlichten Tarif.