Hlavní poznatky
- Kimi K3.1 Pro disponuje kontextovým oknem o velikosti 1 milionu tokenů a je navržen pro programování, tvorbu 3D, finanční výzkum a dlouhodobé úlohy agentů.
- Jeho API stojí 2 dolary za milion vstupních tokenů a 10 dolarů za milion výstupních tokenů, přičemž cacherovaný vstup je k dispozici s 90% slevou.
- Kimi dosahuje skóre 65,7 % v benchmarku Terminal-Bench 4.0, což je blízko hodnotě 66,4 % u Claude Opus 5.5 a předčí to 58,2 % u GPT-6 Astra.
- Kimi vede v několika benchmarkech pro dlouhý kontext a finance, včetně SWE-Marathon v1.1 a OfficeQA Pro v2.
- GPT-6 Astra si vede mnohem lépe v benchmarku Terminal-Bench Science 0.1, což naznačuje, že může být silnější pro vědecké pracovní postupy a agenty zaměřené na výzkum.
- Nižší cena tokenů u Kimi nemusí vždy znamenat nižší celkový účet, protože úlohy agentů mohou spotřebovat velké množství výstupních tokenů.
- ChatGOAT AI umožňuje uživatelům přistupovat ke Kimi K3.1 Pro spolu s modely Claude Opus 5.5, GPT-6 Astra, Gemini, Grok, DeepSeek a dalšími v jediném rozhraní.
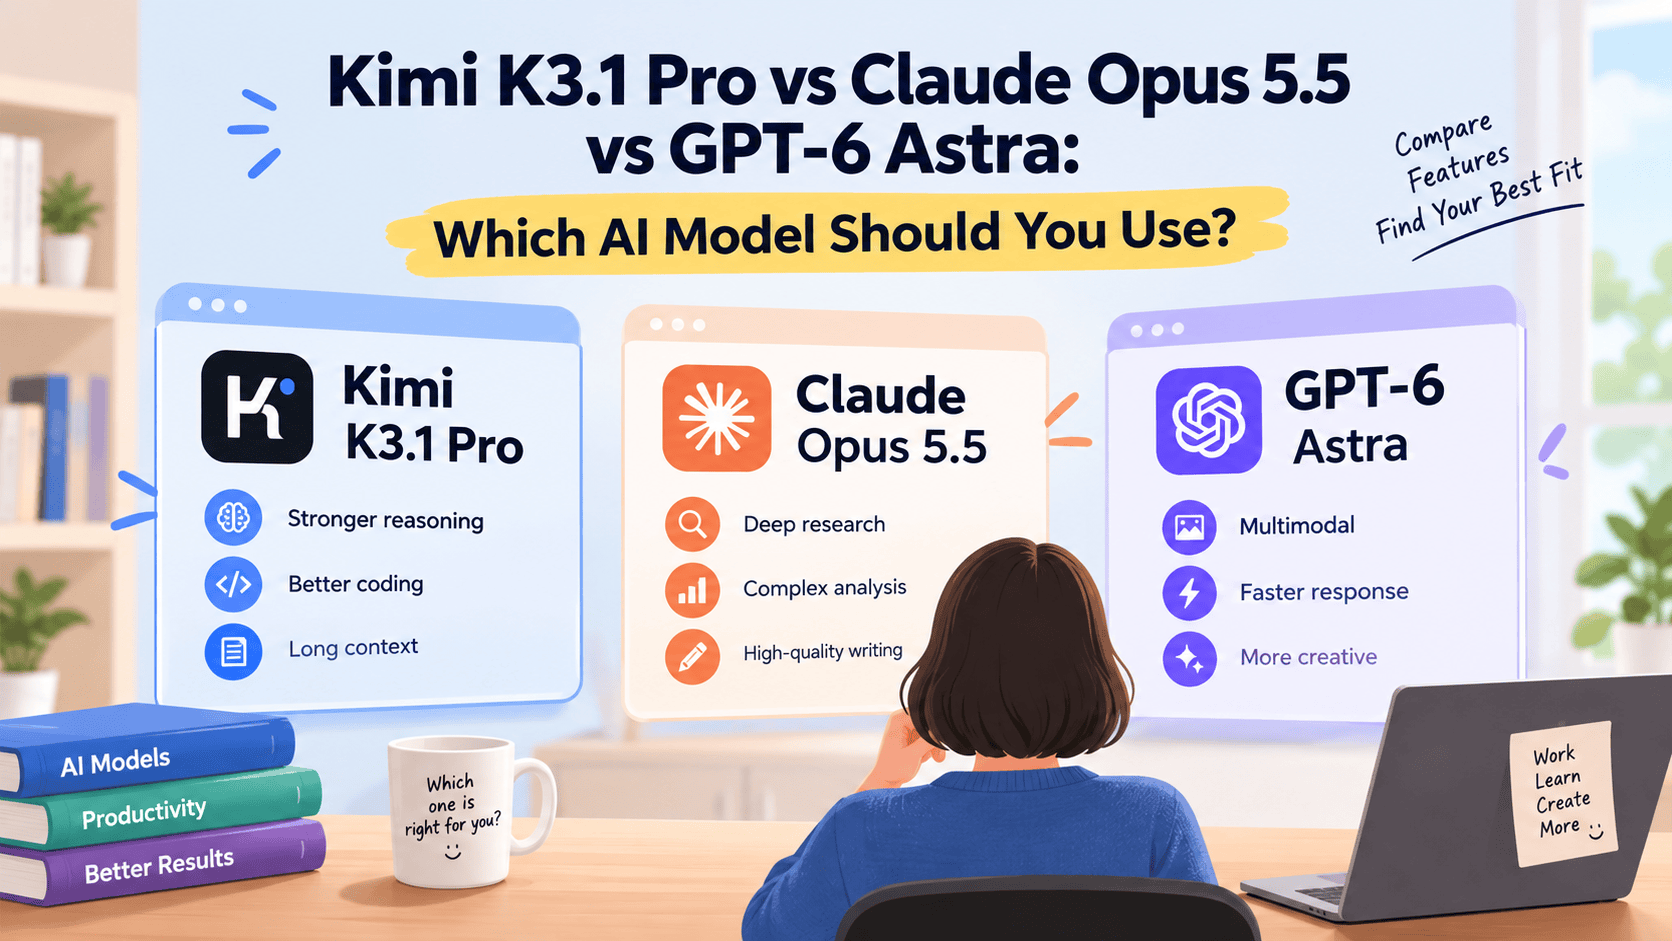
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra: Který model AI byste měli používat?
Výběr modelu AI již není jen o zvolení toho „nejchytřejšího“. Nejlepší model závisí na tom, co vytváříte: kódovacího agenta, asistenta pro finanční výzkum, 3D prototyp, výzkumný pracovní postup nebo produkční aplikaci citlivou na náklady.
Toto srovnání se zabývá modely Kimi K3.1 Pro, Claude Opus 5.5 a GPT-6 Astra pomocí reálných úloh, výsledků benchmarků, cen a praktických silných stránek.
Co je Kimi K3.1 Pro?
Kimi K3.1 Pro je prvním modelem v sérii K3.1 společnosti Moonshot AI a dosud nejschopnějším modelem této společnosti. Jde o model se 3 biliony parametrů s kontextovým oknem o velikosti 1 milionu tokenů, díky čemuž se hodí pro rozsáhlé kódové základy, rozsáhlé zprávy, vícestupňové úlohy agentů a komplexní výzkumné projekty.
Společnost Moonshot staví model K3.1 Pro kolem čtyř hlavních vylepšení:
- Programování
- Tvorba 3D
- Finanční výzkum
- Dlouhodobé schopnosti agentů
Podporuje také nástroje jako Unity, Unreal, Godot a Three.js, což je zajímavé pro vývojáře vytvářející hry, interaktivní weby a 3D zážitky.
Ceník Kimi K3.1 Pro
| Plán / Přístup | Cena | Poznámky |
|---|---|---|
| Vstup přes API | 2 $ za milion tokenů | Nižší než předchozí vstupní cena 3 $ u Kimi K3. |
| Výstup přes API | 10 $ za milion tokenů | Nižší než předchozí výstupní cena 15 $ u Kimi K3. |
| Cacherovaný vstup | Přibližně 0,20 $ za milion tokenů | Založeno na 90% slevě na mezipaměť. |
| Vysokorychlostní verze | Približně 2násobek standardní ceny | Nabízí zhruba 2–3krát rychlejší výstup při podobné inteligenci. |
Nízká katalogová cena je lákavá, ale je důležité sledovat skutečné využití tokenů. V jednom testu Artificial Analysis spotřeboval Kimi přibližně 150 milionů výstupních tokenů, což je nad mediánem 87 milionů, což může zvýšit celkové náklady na dlouhé úlohy agentů.
Benchmarky Kimi K3.1 Pro
Kimi K3.1 Pro si vede obzvláště dobře u kódovacích agentů, dlouhodobého softwarového inženýrství, webového výzkumu a analýzy finančních dokumentů. Není však nejlepším modelem pro každou úlohu.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Co to znamená |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65,7 % | 66,4 % | 58,2 % | Kimi je téměř na stejné úrovni jako Claude v práci kódovacího agenta v terminálu. |
| SWE-Marathon v1.1 | 51,7 % | 46,3 % | 42,5 % | Kimi vede v dlouhodobém softwarovém inženýrství. |
| HLE-Full s nástroji | 70,0 % | 67,7 % | 57,2 % | Kimi podává silné výkony v obtížném znalostním uvažování s nástroji. |
| BrowseComp | 92,1 % | 90,8 % | 91,5 % | Všechny tři modely jsou silné ve webovém výzkumu. |
| OfficeQA Pro v2 | 64,4 | 62,2 | 54,4 | Kimi je silný pro analýzu finančních a kancelářských dokumentů. |
| Terminal-Bench Science 0.1 | 38,1 | 63,3 | 68,1 | GPT-6 Astra vede u pracovních postupů v terminálu zaměřených na vědu. |
Hlavní ponaučení je jednoduché: Kimi není jen „levnější Claude“. Je vysoce konkurenceschopný v kódování agentů a práci náročné na dokumenty, ale GPT-6 Astra může být lepší volbou pro pracovní postupy ve vědeckém výzkumu.
Kimi K3.1 Pro vs Claude Opus 5.5 vs GPT-6 Astra
1. Oprava chyb ve skutečném kódovém základu
Úloha: Poskytněte každému modelu stejný repozitář s několika skrytými chybami. Požádejte jej, aby problém lokalizoval, napsal opravu, přidal testy a vysvětlil změnu.
Co měřit:
- Zda najde hlavní příčinu
- Počet opakovaných pokusů
- Zda testy procházejí
- Kvalita kódu
- Celkový počet tokenů a náklady
Očekávaný výsledek: Kimi si vede dobře v benchmarkech dlouhodobého inženýrství, ale nezávislé testy na reálných repozitářích naznačují, že nemusí vždy vést v opravování starších chyb. Jeden nezávislý test zjistil, že Kimi dosáhl skóre 36 v hodnocení opravy chyb v reálném světě, což je pod hodnotou 41,7 u Claude Opus 5.5.
Nejlepší volba: Claude Opus 5.5 pro ladění obtížného staršího kódu; Kimi K3.1 Pro pro rozsáhlejší refaktorování a vývoj řízený agenty.
2. Přeměna PRD na funkční webovou aplikaci
Úloha: Poskytněte dokument s požadavky na produkt (PRD) a požádejte každý model, aby vytvořil funkční webovou aplikaci, včetně frontendu, backendu, schématu databáze a pokynů k nasazení.
Co měřit:
- Úplnost funkcí
- Organizace kódu
- Kvalita uživatelského rozhraní
- Zpracování změny požadavku uprostřed projektu
- Zda aplikace běží bez ruční opravy
Očekávaný výsledek: Kimi je navržen pro kódování agenty a podporuje frontendové a 3D orientované pracovní postupy, ale nezávislá hodnocení naznačují, že může stále zaostávat za některými západními vlajkovými modely v oblasti vizuálního vzhledu, animací a tvorby webových stránek.
Nejlepší volba: Kimi pro rychlé inženýrské prototypy; Claude nebo GPT-6 Astra, pokud je prioritou vizuální kvalita a iterativní design.
3. Analýza dlouhé finanční zprávy
Úloha: Nahrajte 300stránkovou výroční zprávu, průmyslovou zprávu a tabulku. Požádejte model, aby extrahoval finanční metriky, identifikoval rizika, vytvořil tříletou prognózu a uvedl čísla stránek pro každé tvrzení.
Co měřit:
- Přesnost extrahovaných čísel
- Kvalita citací
- Schopnost propojovat data napříč dokumenty
- Kvalita finančního modelu
- Míra halucinací
Očekávaný výsledek: Toto je jeden z nejsilnějších případů použití pro Kimi. Dosáhl skóre 64,4 v benchmarku OfficeQA Pro v2, čímž předčil Claude Opus 5.5 s 62,2 a GPT-6 Astra s 54,4.
Nejlepší volba: Kimi K3.1 Pro pro dlouhé finanční dokumenty, analýzu tabulek a obchodní práci náročnou na výzkum.
4. Vytvoření 3D prototypu
Úloha: Požádejte každý model, aby vytvořil interaktivní scénu v Three.js, minihru v Godotu nebo prototyp v Unity na základě krátkého zadání.
Co měřit:
- Kvalita aktiv
- Úplnost interakce
- Využití nástrojů
- Vizuální čistota
- Schopnost provádět úpravy po zpětné vazbě
Očekávaný výsledek: Kimi je v této kategorii silný, protože Moonshot specificky vylepšil tvorbu 3D a integraci nástrojů. Není však automaticky tím nejlepším kreativním modelem; nezávislé testování odhalilo nedostatky v některých 3D úlohách a generování webových stránek.
Nejlepší volba: Kimi pro rychlé hratelné prototypy; Claude nebo GPT-6 Astra pro kreativní výstupy s vyšší estetikou, v závislosti na výsledcích vašich testů.
5. Vícestupňový online výzkum
Úloha: Požádejte každý model, aby provedl výzkum trhu, identifikoval 10 důležitých společností, ověřil tvrzení a vytvořil zprávu se zdroji.
Co měřit:
- Kvalita zdrojů
- Faktická přesnost
- Schopnost vyhnout se opakování
- Hloubka analýzy
- Spolehlivost citací
Očekávaný výsledek: Kimi dosáhl skóre 92,1 % v BrowseComp, čímž mírně předčil Claude Opus 5.5 a GPT-6 Astra. To naznačuje, že je vysoce schopný při získávání informací z webu.
Nejlepší volba: Kimi pro obecný webový výzkum; GPT-6 Astra pro vědecký výzkum a technické vyšetřování.
6. Test nákladů a rychlosti
Úloha: Spusťte stejný 10krokový pracovní postup agenta na každém modelu a porovnejte celkové náklady, latenci, výstupní tokeny, opakované pokusy a konečnou kvalitu.
| Metrika | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Cena vstupu přes API | 2 $ / milion tokenů | Vyšší | Liší se podle poskytovatele a plánu. |
| Cena výstupu přes API | 10 $ / milion tokenů | Vyšší | Liší se podle poskytovatele a plánu. |
| Náklady na úlohu v Artificial Analysis | 2,11 $ | 5,98 $ | 3,26 $ |
| Využití výstupních tokenů | V některých testech agentů vysoké | V citovaném testu nižší | V citovaném testu střední |
| Nejlepší pro | Dlouhý kontext, kódovací agenty, finance | Náročné softwarové inženýrství | Výzkum a vědečtí agenti |
Nižší cena Kimi je skutečná, ale vaše konečná faktura závisí na tom, kolik tokenů model spotřebuje. U opakujících se promptů může ukládání do mezipaměti (caching) znamenat velký rozdíl.
Který model byste si měli vybrat?
| Případ použití | Nejlepší model | Proč |
|---|---|---|
| Dlouhé finanční dokumenty | Kimi K3.1 Pro | Silný výkon v OfficeQA a kontext o velikosti 1M tokenů. |
| Kódování agenty | Kimi K3.1 Pro nebo Claude Opus 5.5 | Kimi vede v některých dlouhodobých testech kódování; Claude zůstává vynikající v terminálovém kódování. |
| Opravy chyb v legacy kódu | Claude Opus 5.5 | Silnější v některých nezávislých testech oprav chyb v reálných repozitářích. |
| Vědečtí výzkumní agenti | GPT-6 Astra | Vede v Terminal-Bench Science 0.1 s velkým náskokem. |
| API aplikace citlivé na náklady | Kimi K3.1 Pro | Nižší uváděné ceny vstupu/výstupu a silná hodnota v benchmarku. |
| 3D a herní prototypy | Kimi K3.1 Pro | Vytvořen pro tvorbu 3D a nástroje jako Unity, Unreal, Godot a Three.js. |
| Obecný webový výzkum | Kimi K3.1 Pro | Mírně vpředu v benchmarku BrowseComp. |
Jak si tyto modely vyzkoušet sami
Spoléhejte se nejen na grafy benchmarků. Spusťte stejný prompt přes každý model a ohodnoťte výsledky.
Použijte tento jednoduchý testovací rámec:
- Vyberte jednu úlohu, kterou skutečně děláte každý týden.
- Napište jeden podrobný prompt s jasnými výstupy.
- Spusťte ho na modelech Kimi K3.1 Pro, Claude Opus 5.5 a GPT-6 Astra.
- Zaznamenejte kvalitu dokončení, potřebné úpravy, latenci a využití tokenů.
- Test opakujte třikrát.
- Spočítejte náklady na použitelný výsledek, nejen náklady na milion tokenů.
Tento přístup vám pomůže vyhnout se nejčastější chybě: volbě modelu proto, že vyhrává jeden benchmark, a ne proto, že funguje nejlépe ve vašem pracovním postupu.
Vyzkoušejte Kimi K3.1 Pro na ChatGOAT AI
K porovnání těchto modelů nepotřebujete samostatné účty ani klíče API. ChatGOAT AI je all-in-one platforma umělé inteligence, která poskytuje přístup k několika předním modelům, včetně Kimi K3.1 Pro, Claude Opus 5.5, GPT-6 Astra, Gemini 4 Carbon, Grok 4.7 a DeepSeek, v jednom pracovním prostoru.
S ChatGOAT AI můžete:
- Chatovat s Kimi K3.1 Pro přímo ve vašem prohlížeči.
- Porovnat Kimi s Claude Opus 5.5 a GPT-6 Astra pomocí stejného promptu.
- Používat AI pro kódování, výzkum, psaní, tabulky, prezentace, obrázky a vícestupňové úlohy agentů.
- Přepínat modely bez nutnosti předělávat pracovní postup nebo spravovat více předplatných.
Pokud například analyzujete finanční zprávu, můžete požádat Kimi K3.1 Pro o extrakci metrik a sestavení modelu, poté požádat Claude Opus 5.5 o revizi logiky nebo GPT-6 Astra o průzkum tržních rizik. Tento pracovní postup „přepínání modelů“ je často užitečnější než upisování se jedinému poskytovateli AI.
Časté dotazy
Je Kimi K3.1 Pro lepší než Claude Opus 5.5?
Záleží na úloze. Kimi vede v některých dlouhodobých kódovacích, finančně-analytických a vyhledávacích benchmarku, zatímco Claude Opus 5.5 zůstává mírně vpředu v Terminal-Bench 4.0 a může být silnější pro určité reálné úlohy ladění.
Je Kimi K3.1 Pro lepší než GPT-6 Astra?
Pro dlouhokontextové kódování, finanční dokumenty a obecný webový výzkum je Kimi vysoce konkurenceschopný. Pro vědecké terminálové pracovní postupy má GPT-6 Astra jasnou výhodu na základě výsledků Terminal-Bench Science 0.1.
Kolik Kimi K3.1 Pro stojí?
Kimi K3.1 Pro stojí přes API 2 dolary za milion vstupních tokenů a 10 dolarů za milion výstupních tokenů. Cacherovaný vstup je k dispozici za cca 0,20 dolaru za milion tokenů.
Má Kimi K3.1 Pro opravdu 1M kontext?
Ano. Moonshot uvádí, že K3.1 Pro podporuje kontextové okno o velikosti 1 milionu tokenů, což je užitečné pro rozsáhlé kódové základy, dlouhé zprávy a analýzu více dokumentů.
Mohu použít Kimi K3.1 Pro pro kódování?
Ano. Kódování je jednou z jeho hlavních silných stránek, zejména kódování pomocí agentů, dlouhodobé softwarové inženýrství a vývojové úlohy v terminálu.
Mohu používat Kimi K3.1 Pro na ChatGOAT AI?
Ano. ChatGOAT AI uvádí Kimi K3.1 Pro mezi svými dostupnými modely, vedle Claude Opus 5.5, GPT-6 Astra, Gemini, Grok a DeepSeek.
Který model je nejlepší pro začátečníky?
Pro začátečníky je nejlepší začít s ChatGOAT AI, protože vám umožňuje vyzkoušet více modelů na jednom místě. Pro dlouhé dokumenty a kódování použijte Kimi, pro pečlivé softwarové inženýrství Claude a pro úlohy náročné na výzkum GPT-6 Astra.
Mám si vybrat Kimi proto, že je levnější?
Ne vždy. Kimi má nižší cenu za token, ale úlohy agentů mohou generovat mnoho výstupních tokenů. Otestujte celý pracovní postup a porovnejte konečné náklady, nejen zveřejněnou sazbu.