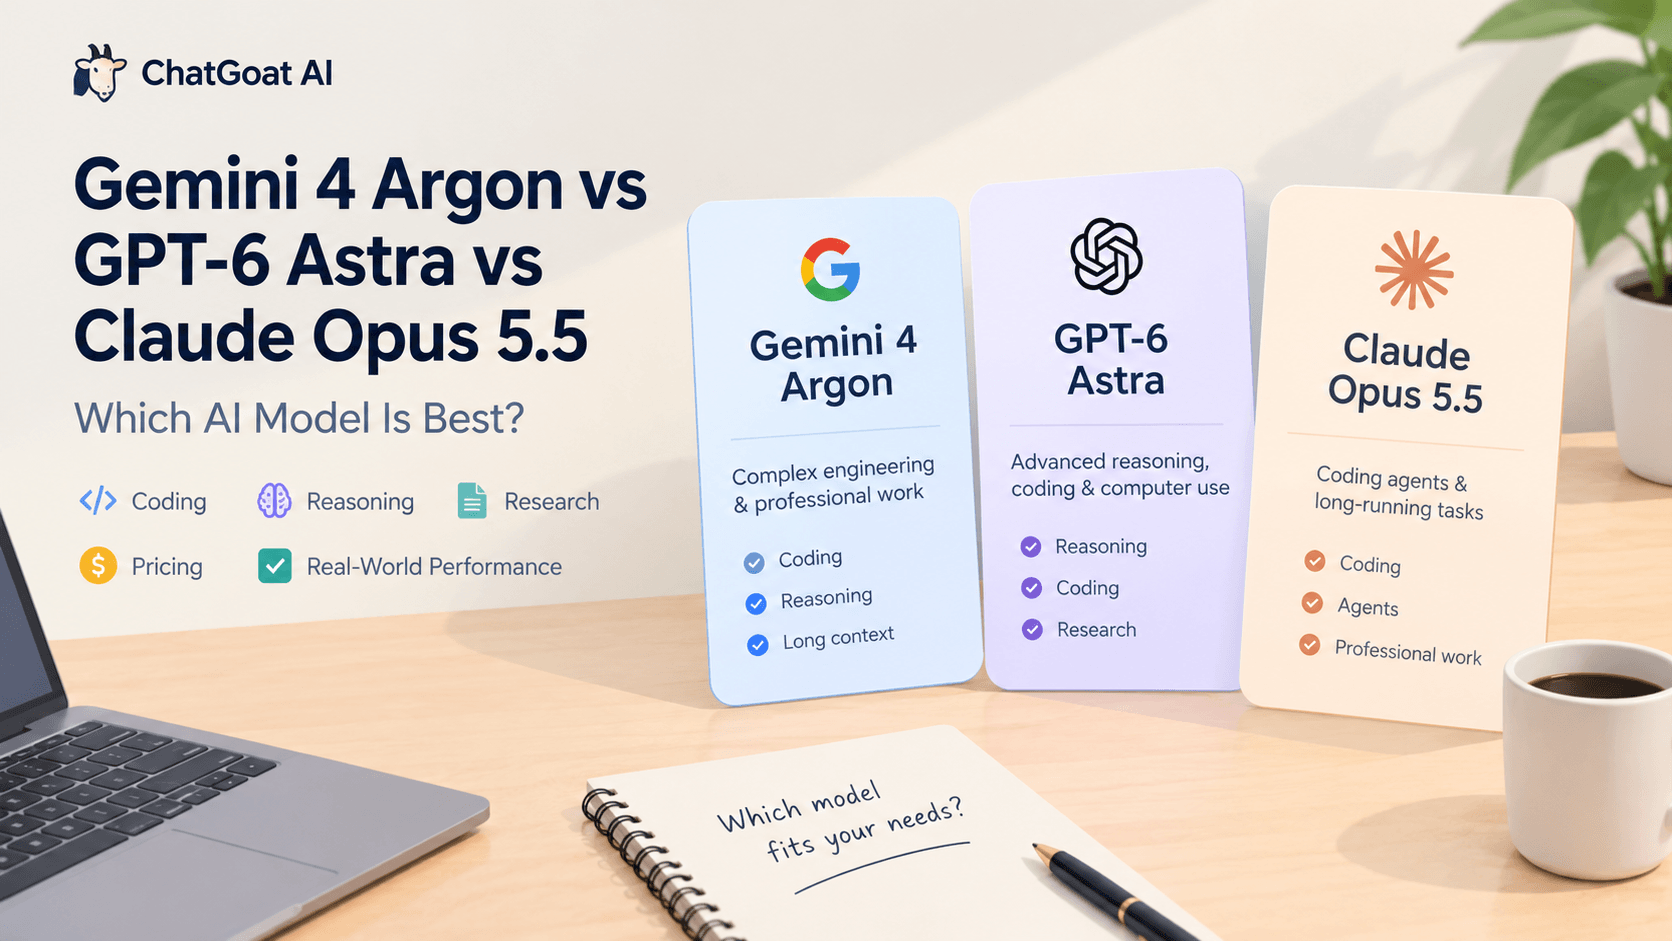
Souboj mezi Gemini 4 Argon, GPT-6 Astra a Claude Opus 5.5 poukazuje na důležitý posun v oblasti umělé inteligence. Dnešní přední modely se již neposuzují pouze podle toho, jak dobře odpovídají na otázky. Vývojáři, výzkumníci i běžní uživatelé požadují AI, která dokáže řešit složité problémy, porozumět rozsáhlým projektům, psát spolehlivý kód, analyzovat dokumenty a plnit vícekrokové úkoly s menším dohledem.
Každý model má jinou sadu silných stránek. Google staví Gemini 4 Argon do pozice modelu pro složité inženýrství, profesionální práci se znalostmi a obranu v oblasti kybernetické bezpečnosti. OpenAI představuje GPT-6 Astra jako model pro náročné uvažování, kódování, výzkum a úlohy využívající ovládání počítače. Anthropic zdůrazňuje schopnosti modelu Claude Opus 5.5 v oblasti softwarového inženýrství, dlouhodobě běžících agentů a profesionální práce.
Který model byste si však měli vybrat? Je Gemini 4 Argon v kódování skutečně lepší? Omluví GPT-6 Astra svou vyšší cenu API? Dokáže Claude Opus 5.5 dokončit komplikované projekty s méně pokyny?
Toto srovnání zkoumá oficiální výsledky benchmarků, ceny, dostupnost, praktické případy použití a diskuse z Redditu. Vysvětluje také, jak tyto modely vyhodnotit pro reálnou práci a jak prozkoumat pracovní postupy poháněné AI prostřednictvím ChatGOAT AI.
Rychlý verdikt: Gemini 4 Argon vs. GPT-6 Astra vs. Claude Opus 5.5
Neexistuje jediný vítěz pro každý úkol. Nejlepší volba závisí na práci, kterou potřebujete dokončit, na vašem rozpočtu a na tom, zda máte k modelu přístup prostřednictvím preferované platformy.
| Srovnání | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Hlavní zaměření | Složité inženýrství a profesionální pracovní postupy | Pokročilé uvažování, kódování, výzkum a ovládání počítače | Kódovací agenti a dlouhodobé profesionální úlohy |
| Kódování | Silné výsledky ve vybraných benchmarkách softwarového inženýrství | Silné výsledky v kódování náročném na uvažování a technických úlohách | Navržen pro složité kódování a pracovní postupy agentů |
| Uvažování | Navržen pro složité vícekrokové řešení problémů | Vytvořen pro náročné uvažování a profesionální práci | Silný v plnění složitých pokynů a dlouhodobé práci |
| Práce s dlouhým kontextem | Oznámeno až 1 milion výstupních tokenů | Kontextové okno s 1,05 milionu tokenů | Dlouhodobé pracovní postupy agentů a velké projekty |
| Standardní cena API za vstup | 2 $ za milion tokenů | 10 $ za milion tokenů | 4 $ za milion tokenů |
| Standardní cena API za výstup | 10 $ za milion tokenů | 50 $ za milion tokenů | 20 $ za milion tokenů |
| Dostupnost | Zpočátku omezeno na důvěryhodné obránce v oblasti kybernetické bezpečnosti | Dostupný prostřednictvím podporovaných produktů a API OpenAI | Dostupný prostřednictvím podporovaných platforem Claude a vývojářských platforem |
Zdroje: Oznámení společnosti Google o Gemini 4 Argon, dokumentace k modelu GPT-6 Astra od OpenAI a dokumentace ke Claude Opus od Anthropic.
Tyto modely by neměly být hodnoceny pouze na základě ceny nebo jednoho benchmarku. Model, který stojí méně za token, může k dokončení úkolu vyžadovat více opakovaných pokusů, zatímco model s působivým výsledkem v benchmarku nemusí být běžnému uživateli přístupný.
Praktický závěr: Porovnejte kvalitu konečného výsledku, potřebný čas, počet oprav a skutečné náklady na dokončení úkolu.
Gemini 4 Argon: Vytvořen pro složité inženýrství a znalostní práci
Společnost Google oznámila Gemini 4 Argon 30. září 2026 a prezentuje jej jako špičkový model pro reálné softwarové inženýrství, podnikovou znalostní práci a obranu v oblasti kybernetické bezpečnosti.
Na rozdíl od modelu navrženého především pro každodenní konverzace je Argon prezentován jako systém schopný zvládat dlouhé, propojené úlohy. Ty mohou zahrnovat zkoumání rozsáhlých technických informací, identifikaci problémů, plánování posloupnosti kroků a vytvoření konečného výsledku.
Klíčové silné stránky
Složité softwarové inženýrství
Argon prokázal silné výsledky ve vybraných benchmarkách softwarového inženýrství. Oznámení společnosti Google zdůrazňuje inženýrské úlohy s dlouhým horizontem, kde si systém AI musí udržet kontext při řešení komplikovaného problému.
Mezi potenciální aplikace patří revize rozsáhlé kódové základny, identifikace příčiny chyby, plánování migrace a vyhodnocení, zda navrhované změny řeší původní problém.
Profesionální výzkum a analýza dokumentů
Google rovněž vyzdvihuje právní, finanční a další podnikovou znalostní práci. Díky tomu jsou úlohy s velkým množstvím dokumentů důležitou oblastí k vyhodnocení, zejména pokud model musí propojovat informace napříč několika soubory.
Obchodní analytik by mohl například využít pracovní postup AI k sumarizaci zpráv, extrakci finančních údajů, porovnání předpokladů a přípravě strukturovaného přehledu pro kontrolu člověkem.
Dlouhý výstupní text
Společnost Google oznámila pro Argon maximální výstupní limit až jeden milion tokenů. Jedná se o povolený výstup, nikoli o totéž jako kontextové okno. Tento rozdíl je při srovnávání modelů důležitý, protože množství informací, které model může přijmout, a množství, které může vygenerovat, jsou odlišné schopnosti.
Jaká jsou omezení?
Největším praktickým omezením je přístup. V době oznámení společnost Google zaváděla Argon pro důvěryhodné obránce kybernetické bezpečnosti prostřednictvím programu Fairwind Program, přičemž širší dostupnost je plánována na pozdější fázi.
To znamená, že publikované výsledky by neměly být automaticky považovány za nezávisle reprodukovatelné běžnými uživateli.
Vysoké skóre v benchmarku také nezaručuje, že Argon překoná ostatní modely v každém programovacím jazyce, výzkumné úloze nebo reálném projektu.
Další informace naleznete v oficiálním oznámení společnosti Google o Gemini 4 Argon.
GPT-6 Astra: Pokročilé uvažování, kódování a ovládání počítače
OpenAI popisuje GPT-6 Astra jako svůj model pro náročné profesionální úlohy, včetně složitého uvažování, vývoje softwaru, výzkumu, tvorby dokumentů a ovládání počítače.
Jeho hodnota se neomezuje na poskytnutí dobré odpovědi v jediné interakci. U vhodných pracovních postupů je cílem promyslet problém, využít dostupné nástroje a směřovat k jasně definovanému výsledku.
Klíčové silné stránky
Pokročilé uvažování
GPT-6 Astra je určen pro problémy, které vyžadují více než jen vyhledání faktu nebo vygenerování krátké odpovědi. Lze jej vyhodnocovat v oblasti matematického uvažování, plánování, složitých technických otázek a úloh s více omezeními.
Produktový manažer by jej mohl například požádat o porovnání konkurenčních produktových strategií, identifikaci rizik, vytvoření rozhodovacího rámce a vypracování plánu implementace.
Vývoj a ladění softwaru
Astra může vývojářům pomoci generovat kód, kontrolovat stávající implementace, diagnostikovat chyby a řešit složitější inženýrské úlohy.
Mezi užitečné testy patří ladění neznámého projektu, úprava více souborů, generování jednotkových testů a ověřování, zda konečná implementace splňuje požadavky.
Ovládání počítače a pracovní postupy agentů
OpenAI rovněž uvádí schopnosti související s ovládáním počítače. Skutečná automatizace však závisí na nástrojích, oprávněních a bezpečnostních prvcích poskytovaných prostředím, ve kterém model běží.
Schopnost modelu naplánovat úkol neznamená, že mu každé chatovací rozhraní automaticky umožňuje prohlížet webové stránky, ovládat aplikace nebo spouštět kód.
Jaká jsou omezení?
GPT-6 Astra má vyšší standardní cenu za tokeny API než ostatní dva modely v tomto srovnání. Jeho publikované sazby jsou 10 $ za milion vstupních tokenů a 50 $ za milion výstupních tokenů před započtením případného cachování, poplatků za nástroje a dalších poplatků.
Pro uživatele, kteří provádějí mnoho dlouhých konverzací nebo rozsáhlé automatizované pracovní postupy, se náklady mohou rychle nasčítat.
Model by měl být proto vyhodnocován podle kvality dokončené práce, nikoli pouze podle jeho samotné inteligence. Pokud méně nákladná alternativa poskytuje pro běžný úkol stejně spolehlivé výsledky, nemusí být nutné platit za dražší model.
Přečtěte si více v dokumentaci k GPT-6 Astra od OpenAI.
Claude Opus 5.5: Kódovací agenti a dlouhodobé úlohy
Claude Opus 5.5 je zaměřen na náročné softwarové inženýrství, dlouhodobé pracovní postupy agentů a profesionální práci. Pro mnoho vývojářů spočívá jeho přitažlivost v možnosti delegovat komplikovaný úkol a zároveň zachovat původní požadavky po celou dobu procesu.
To je obzvláště důležité, pokud projekt zahrnuje několik souborů, více závislostí nebo dlouhou posloupnost rozhodnutí.
Klíčové silné stránky
Porozumění kódové základně
Užitečný kódovací model musí rozumět tomu, jak spolu různé části projektu interagují. Měl by být schopen identifikovat příčinu chyby, určit, které soubory vyžadují změny, a vyvarovat se zanesení regresních chyb jinde.
Claude Opus 5.5 je silným kandidátem k vyhodnocení pro tyto pracovní postupy, zejména pokud úkol vyžaduje dlouhodobou pozornost struktuře a požadavkům projektu.
Složité pokyny a psaní textu
Mnohé profesionální úlohy zahrnují podrobné pokyny, které nelze zredukovat na jedinou otázku. Uživatel může specifikovat cílové publikum, tón, technická omezení, pravidla formátování a seznam požadovaných výstupů.
Claude lze hodnotit podle toho, jak dobře tato omezení dodržuje, udržuje konzistenci a vytváří práci, která vyžaduje minimální úpravy.
Dlouhodobé pracovní postupy agentů
Pro vývojové týmy může být zapotřebí, aby agent AI prozkoumal projekt, provedl změny, spustil testy, interpretoval chyby a upravil svou implementaci.
Počet úspěšně dokončených kroků je často výpovědnější než kvalita první odpovědi.
Jaká jsou omezení?
Schopný model může úkol stále příliš zkomplikovat, učinit nesprávné předpoklady nebo během dlouhé relace spotřebovat značnou část limitů využití.
Záleží také na limitech přístupu a pravidlech předplatného. Diskuse v komunitě často zmiňují limity využití, i když jsou uživatelé s kvalitou modelu spokojeni.
Publikované standardní sazby API pro Claude Opus 5.5 jsou 4 $ za milion vstupních tokenů a 20 $ za milion výstupních tokenů. Tyto sazby jsou nižší než standardní sazby modelu Astra, i když skutečné náklady závisí na způsobu využití, cachování a dalších službách.
Aktuální informace o produktu a cenách naleznete v oficiální dokumentaci ke Claude Opus od Anthropic.
Co nám benchmarky ve skutečnosti říkají?
Výsledky benchmarků jsou užitečné pro pochopení schopností modelu, ale neříkají celý příběh.
Různé testy měří různé dovednosti. Model, který dosahuje dobrých výsledků v dlouhém benchmarku softwarového inženýrství, nemusí být nejlepší volbou pro faktografický výzkum, psaní nebo vizuální analýzu.
Oznámení o modelu Argon od společnosti Google a publikované výsledky hodnocení GPT-6 Astra poskytují několik užitečných bodů pro srovnání.
Výsledky vybraných benchmarků kódování
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| DeepSWE v1.1 | Přibližně 78 % | 74,1 % | Přibližně 74 % |
| FrontierSWE v2 | Viz publikované hodnocení společnosti Google | Uváděná výhoda v dostupných srovnáních | Viz publikované hodnocení společnosti Google |
| Terminal-Bench 4.0 | Viz publikované hodnocení společnosti Google | 57,9 % v publikovaných výsledcích OpenAI | Mohou platit odlišné výsledky hodnocení |
Zdroje: Oznámení o modelu Argon od společnosti Google, dokumentace k modelu Astra od OpenAI a srovnání modelu Argon s konkurencí z října 2026.
Důležité: Tyto údaje by měly být považovány za uváděné výsledky, nikoli za plně kontrolované nezávislé srovnání. Výsledky se mohou lišit podle verze modelu, testovacího prostředí, přístupu k nástrojům, nastavení uvažování a data hodnocení. Tam, kde původní zdroje neuvádějí přímo srovnatelné číslo, se tabulka záměrně vyhýbá jeho vymýšlení.
Dostupné výsledky také ukazují, proč je univerzální žebříček zavádějící. Podle zpráv Argon vede v DeepSWE v1.1, zatímco Astra a Opus mohou dosahovat odlišných výsledků v jiných hodnoceních softwarového inženýrství.
Lepším přístupem je položit si otázku, který benchmark se nejvíce podobá vaší skutečné pracovní zátěži.
- Pro údržbu kódu upřednostňujte úlohy na reálných repozitářích a míru úspěšnosti testů.
- Pro výzkum měřte faktickou přesnost a to, zda citace podporují tvrzení.
- Pro pracovní postupy agentů měřte dokončení úkolu od začátku do konce a schopnost zotavení z chyb.
- Pro obchodní psaní vyhodnocujte přesnost, dodržování pokynů a čas potřebný na úpravy.
Benchmark je výchozí bod. Vaše vlastní úloha je konečným testem.
Co o těchto modelech říkají uživatelé na Redditu?
Reddit poskytuje jiný pohled než oficiální oznámení. Uživatelé diskutují o aspektech výkonu modelů, kterých si všímají při každodenní práci, včetně kvality kódu, kreativity, rychlosti, limitů využití a množství navádění, které model vyžaduje.
Tyto diskuse jsou užitečným důkazem uživatelských priorit, jsou však anekdotické. Příspěvek nedokazuje, že jeden model je objektivně lepší pro každého uživatele.
Gemini 4 Argon: Působivé výsledky, ale přístup zůstává problémem
V diskusi na r/singularity o benchmarkách Gemini 4 Argon uživatelé probírali uváděné výsledky společnosti Google v oblastech kódování, kybernetické bezpečnosti a profesionálních úloh.
Jednou z opakujících se otázek bylo, zda se výkon modelu promítne do praktických výhod a kdy bude k dispozici širší přístup.
To vytváří užitečný rozdíl pro srovnávací článek: prvenství v benchmarku není totéž co každodenní užitečnost. Uživatelé potřebují způsob, jak model otestovat na svých vlastních úlohách, než se rozhodnou, zda stojí za to jej zavést.
GPT-6 Astra vs. Claude Opus 5.5: Kvalita, rychlost a limity využití
Diskuse na r/ClaudeAI srovnávající Opus 5.5 s GPT-6 Astra ilustruje, jak rychle se mohou preference komunity mezi vydáními modelů měnit.
Účastníci popisovali různé zkušenosti s modely. Někteří preferovali Astru, zatímco jiní chválili schopnosti Opus 5.5, ale kritizovali množství pokynů, které mu někdy museli poskytovat.
Širším poučením je, že kvalita modelu závisí částečně na úloze a pracovním postupu uživatele. Model, který funguje dobře u jednoho vývojáře, může být méně vhodný pro požadavky jiného projektu.
Dalším problémem jsou limity využití. V diskusi na Redditu o volbě mezi Opus 5.5 a Astra vznesl jeden uživatel dotazy ohledně vyčerpání limitů a toho, zda by změna předplatného nenabídla výhodnější hodnotu.
Pro časté uživatele mohou mít náklady na dlouhodobou práci stejný význam jako kvalita jednotlivých odpovědí.
I jednoduchý kreativní úkol může přinést různé výsledky
Ve srovnání modelů Opus 5.5, GPT-6 Astra a dalších modelů na Redditu uživatelé diskutovali o tom, jak zadali několika modelům stejné zadání pro vytvoření krátké animace papírové vlaštovky.
Odpovědi odrážely různé preference: někteří uživatelé dalo přednost kvalitě animace, zatímco jiní preferovali interpretaci nebo kreativní směrování jiného modelu.
To je užitečné připomenutí, že srovnání modelů se neomezuje pouze na kódování a uvažování. U kreativní práce může být kvalita výstupu subjektivní a nejvhodnější model závisí na výsledku, který uživatel požaduje.
Co se můžeme z těchto diskusí naučit?
Napříč těmito vlákny vynikají čtyři témata:
- Výkon v reálném světě je důležitější než titulní skóre. Uživatelé chtějí modely, které řeší jejich konkrétní problémy.
- Dodržování pokynů ovlivňuje produktivitu. Silný model je užitečnější, když rozumí omezením bez opakovaného ujasňování.
- Limity využití ovlivňují celkový dojem. Vysoce kvalitní výsledky mají nižší hodnotu, pokud uživatelé nemohou udržet svůj pracovní postup.
- Různé úlohy vyžadují různé silné stránky. Kreativní výstup, kódování, výzkum a automatizace by neměly být hodnoceny podle stejných kritérií.
Tyto poznatky by měly sloužit jako podklad pro testy v tomto článku, nikoli je nahrazovat.
Jak porovnat tyto tři modely v úlohách z reálného světa
Nejúžitečnější srovnání by všem třem modelům zadalo stejný úkol, stejné vstupní materiály a stejná kritéria hodnocení.
Pokud máte k dispozici všechny tři modely, následující testy vám mohou pomoci určit, který z nich nejlépe vyhovuje vašemu pracovnímu postupu.
Test 1: Kódování a ladění
Dejte každému modelu stejnou malou kódovou základnu obsahující reprodukovatelnou chybu. Požádejte jej, aby identifikoval problém, implementoval opravu, napsal testy a vysvětlil změny.
Měřte:
- Zda je původní chyba opravena
- Zda stávající testy stále procházejí
- Zda byly zaneseny nové chyby
- Kolik doplňujících dotazů je potřeba
- Celkový čas a spotřebu tokenů
Model, který poskytne věrohodné vysvětlení, ale nesplní testy, by neměl být považován za vítěze.
Test 2: Výzkum a analýza dokumentů
Poskytněte stejnou sadu zpráv, tabulek a zdrojových dokumentů. Požádejte každý model, aby shrnul poznatky, extrahoval důležitá čísla, identifikoval rozporuplné informace a připravil krátkou zprávu s odkazy.
Měřte faktickou přesnost, kvalitu citací, pokrytí důležitých informací a množství vyžadovaných ručních oprav.
Tento test je obzvláště užitečný pro analytiky, studenty, konzultanty a obsahové týmy.
Test 3: Realizace vícekrokového projektu
Zadejte každému modelu úkol, který vyžaduje několik výstupů, jako je analýza nápadu na produkt, vypracování plánu projektu, vytvoření tabulky úkolů a příprava závěrečné zprávy.
Vyhodnoťte, zda dodržuje požadovanou posloupnost, udržuje konzistenci mezi výstupy a kontroluje konečný výsledek.
Pokud prostředí poskytuje nástroje, zaznamenejte, zda je model používá správně. Oddělujte inteligenci modelu od schopností platformy, na které běží.
Test 4: Psaní textu a dodržování pokynů
Poskytněte podrobné zadání pro psaní s určením cílového publika, tónu, požadovaných bodů, délky a omezení.
Porovnejte výsledky z hlediska faktické přesnosti, čitelnosti, struktury, originality a dodržení zadání.
Pro marketingové týmy to může odhalit, který model vytváří použitelné první návrhy a který vyžaduje rozsáhlejší úpravy.
Používejte konzistentní rámec hodnocení
Jednoduché 100bodové hodnocení může usnadnit porovnání výsledků.
| Kritérium | Navrhovaná váha |
|---|---|
| Přesnost a správnost | 30 |
| Dokončení úkolu | 25 |
| Dodržování pokynů | 15 |
| Kvalita výstupu | 15 |
| Rychlost a efektivita | 10 |
| Náklady | 5 |
| Celkem | 100 |
Váhy by se měly měnit podle typu úkolu. Například testy kódování by měly klást větší důraz na funkční kód a úspěšné testy, zatímco testy výzkumu by měly upřednostňovat faktickou přesnost a kvalitu zdrojů.
Nezveřejňujte skóre jako nezávislý test, pokud jste experiment skutečně neprovedli. Pokud je přístup k modelu Argon omezen, použijte jasně označené srovnání publikovaných výsledků a sekci nezávislého testování vyhraďte pro modely, které můžete skutečně vyhodnotit.
Srovnání cen: Který model nabízí lepší hodnotu?
Standardní sazby API publikované pro tyto modely poskytují užitečný výchozí bod.
| Model | Vstup za 1M tokenů | Výstup za 1M tokenů |
|---|---|---|
| Gemini 4 Argon | 2 $ | 10 $ |
| GPT-6 Astra | 10 $ | 50 $ |
| Claude Opus 5.5 | 4 $ | 20 $ |
Zdroje: Google, OpenAI a Anthropic.
Při těchto publikovaných standardních sazbách má Argon nejnižší uvedenou cenu za tokeny, následuje Opus 5.5 a Astra. To však automaticky neznamená, že Argon je nejlevnější praktickou volbou pro každého uživatele, zejména pokud přístup k němu zůstává omezený.
Příklad: Úkol využívající 100 000 vstupních tokenů a 20 000 výstupních tokenů
Za předpokladu, že platí publikované sazby, bez slev na cachování, poplatků za nástroje nebo jiných poplatků:
- Gemini 4 Argon: 0,20 $ vstup + 0,20 $ výstup = 0,40 $
- GPT-6 Astra: 1,00 $ vstup + 1,00 $ výstup = 2,00 $
- Claude Opus 5.5: 0,40 $ vstup + 0,40 $ výstup = 0,80 $
Jedná se o příklad nákladů na tokeny, nikoli o tvrzení, že modely spotřebují k dokončení téhož úkolu stejný počet tokenů.
Pro spravedlivější srovnání spočítejte náklady na vytvoření jednoho úspěšného výsledku. Pokud jeden model vyžaduje pět opakování a jiný dokončí úkol na jeden pokus, jejich efektivní náklady se mohou výrazně lišit od standardního poměru cen tokenů.
Plány předplatného mají také své vlastní ceny, limity a pravidla použití. Nespovnávejte ceny API přímo s poplatky za předplatné, jako by byly rovnocenné.
Který AI model je nejlepší pro vaše potřeby?
Správný model závisí na tom, co děláte, jak často AI používáte a jak vypadá úspěšný výsledek.
Pro softwarové vývojáře
Zvažte otestování GPT-6 Astra a Claude Opus 5.5 na vaší skutečné kódové základně. Oba modely jsou zaměřeny na náročnou inženýrskou práci, ale jejich relativní výkon bude záviset na vašem jazyce, nástrojích a složitosti projektu.
Gemini 4 Argon stojí rovněž za sledování kvůli uváděným výsledkům v oblasti softwarového inženýrství, s výhradou dostupnosti a nezávislého ověření.
Pro výzkumníky a analytiky
Upřednostňujte přesnou extrakci informací, spolehlivé citace, zpracování dlouhých dokumentů a schopnost rozlišit fakta od předpokladů.
U práce zahrnující rozsáhlé kolekce souborů otestujte, zda model dokáže najít relevantní podrobnosti, aniž by přehlédl rozporuplné důkazy.
Pro tvůrce obsahu a marketéry
Porovnejte, jak dobře každý model dodržuje zadání obsahu, udržuje konzistentní tón, organizuje informace a vytváří návrhy, které vyžadují minimální úpravy.
Praktický pracovní postup může zahrnovat výzkum klíčových slov, vytvoření osnovy, psaní návrhu, kontrolu faktů a přizpůsobení obsahu pro různá publika. Kontrola člověkem zůstává nezbytná, zejména u faktických tvrzení a SEO obsahu.
Pro firemní uživatele
Zaměřte se na dokončování úkolů, analýzu dokumentů, pracovní postupy v tabulkových procesorech, výkaznictví a spolehlivost výstupů.
U opakujících se úkolů může i malé zkrácení času ruční kontroly znamenat více než mírné zlepšení výsledků v benchmarku.
Pro uživatele dbalé na rozpočet
Porovnejte skutečné náklady na dokončení vašich běžných úkolů, místo abyste vybírali model pouze na základě jeho propagované inteligence.
Pokud levnější model konzistentně splňuje vaše požadavky, může být lepší každodenní volbou. Dražší modely si vyhraďte pro práci, kde jejich dodatečné schopnosti přinášejí měřitelný rozdíl.
Jak prozkoumat AI modely a plnit úlohy na ChatGOAT AI
Porovnávání modelů je užitečné, ale skutečný přínos AI spočívá v jejím použití při vaší vlastní práci.
ChatGOAT AI poskytuje pracovní prostředí AI pro podporované modely a nástroje, čímž uživatelům pomáhá objevovat psaní, výzkum, analýzu a kreativní pracovní postupy s podporou AI, aniž by museli ke každému úkolu přistupovat jako k samostatnému experimentu.
Pokud jsou modely Gemini 4 Argon, GPT-6 Astra a Claude Opus 5.5 povoleny v aktuálním výběru modelů ChatGOAT, mohou uživatelé zkoumat jejich odpovědi přímo v platformě a vyhodnotit, který přístup nejlépe vyhovuje jejich potřebám. Dostupnost se může lišit podle modelu a integrace, proto před zahájením zkontrolujte aktuální seznam modelů.
Co můžete dělat s AI na ChatGOAT AI?
Využijte AI k vymýšlení nápadů na články, vytváření osnov, psaní příspěvků na blog, přepisování odstavců, sumarizaci dlouhých materiálů nebo přizpůsobení obsahu pro různá publika.
SEO specialista může například vypracovat osnovu blogu, napsat srovnávací článek, připravit odpovědi na časté dotazy (FAQ) a upravit obsah z hlediska srozumitelnosti a vyhledávacího záměru.
Analyzovat informace a dokumenty
AI může pomoci extrahovat klíčové body z poskytnutých materiálů, porovnávat zprávy, organizovat zjištění z výzkumu a proměnit nestrukturované poznámky v jasnější přehled.
Firemní uživatel může například proměnit poznámky ze schůzky v akční plán, vytvořit srovnávací tabulku a připravit stručný přehled pro vedení.
Vytvářet strukturované tabulky a plány projektů
Využijte AI k organizaci srovnání produktů, přípravě seznamů úkolů, vytváření výzkumných matic a sestavování strukturovaných plánů projektů.
Marketingový tým by mohl tento pracovní postup využít k porovnání funkcí konkurence, mapování klíčových slov na cílové stránky a organizaci obsahového kalendáře.
Podporovat kódování a řešení problémů
U podporovaných kódovacích pracovních postupů může AI vysvětlit neznámý kód, navrhnout kroky pro ladění, napsat funkce a pomoci uspořádat technickou dokumentaci.
Vygenerovaný kód vždy otestujte a změny zkontrolujte před jejich použitím v produkčním prostředí.
ChatGOAT AI poskytuje také schopnosti generování obrázků pomocí AI prostřednictvím podporovaných obrazových nástrojů a modelů. Ty mohou uživatelům pomoci vytvářet ilustrace, vizuální koncepty, grafiku pro sociální sítě a další kreativní podklady.
Generování obrázků je odlišná schopnost od uvažování textových modelů. Nepředpokládejte, že každý model v tomto srovnání dokáže generovat obrázky přímo jen proto, že pracovní prostředí obsahuje obrazové nástroje.
Vytvořit efektivnější pracovní postup
Místo toho, aby uživatelé přistupovali ke každému úkolu jako k izolovanému zadání, mohou projekt rozdělit do kroků: výzkum, plánování, psaní návrhu, kontrola a finální odevzdání.
Nejúžitečnější pracovní postup je ten, který přináší přesné výsledky s menším množstvím opakované práce, nikoli nutně ten, který používá nepokročilejší model pro každý krok.
Prozkoumejte ChatGOAT AI a podívejte se na aktuálně podporované modely a AI nástroje dostupné pro váš pracovní postup.
Často kladené otázky (FAQ)
Je Gemini 4 Argon lepší než GPT-6 Astra?
Ne v každé situaci. Společnost Google uvedla silné výsledky modelu Argon ve vybraných benchmarkách inženýrství a profesionální práce, zatímco OpenAI publikuje silné výsledky modelu Astra v několika náročných hodnoceních. Omezení přístupu a rozdíly v metodách testování dělají univerzální žebříček předčasným.
Je Claude Opus 5.5 lepší než GPT-6 Astra pro kódování?
Oba modely jsou navrženy pro náročné úlohy softwarového inženýrství. Lepší volba závisí na kódové základně, programovacím jazyce, dostupných nástrojích a kvalitě konečné implementace. Porovnejte míru úspěšnosti testů, rizika regresních chyb, počet iterací a celkové náklady na téže úloze.
Který model je nejlepší pro složité uvažování?
GPT-6 Astra a Gemini 4 Argon jsou oba zaměřeny na složité uvažování a vícekrokovou práci, zatímco Claude Opus 5.5 je navržen pro náročné profesionální pracovní postupy a agenty. Použijte testy specifické pro danou úlohu, abyste určili, který model podává nejlepší výkon pro vaše potřeby.
Který model je nejlevnější?
Na základě výše uvedených standardních publikovaných sazeb API má Gemini 4 Argon nejnižší cenu za token, následuje Claude Opus 5.5 a GPT-6 Astra. Omezená dostupnost modelu Argon však ovlivňuje to, zda většina uživatelů může tyto ceny skutečně využít. Celkové náklady na úkol závisí také na spotřebě tokenů, opakovaných pokusech, cachování a nástrojích.
Mohu Gemini 4 Argon používat hned teď?
Společnost Google zpočátku oznámila Argon pro důvěryhodné obránce kybernetické bezpečnosti prostřednictvím programu Fairwind Program, přičemž se plánuje širší přístup. Než na něj spolehnete při projektu, zkontrolujte nejnovější oficiální oznámení společnosti Google ohledně změn v dostupnosti.
Mohu tyto modely porovnat na ChatGOAT AI?
Můžete prozkoumat modely a nástroje podporované v aktuálním pracovním prostředí ChatGOAT AI. Chcete-li všechny tři porovnat přímo, ověřte, zda jsou Gemini 4 Argon, GPT-6 Astra a Claude Opus 5.5 dostupné v aktuálním výběru modelů. Pokud některý z nich není k dispozici, porovnejte jeho publikovanou dokumentaci s praktickými výsledky z dostupných modelů.
Který model je nejlepší pro každodenní práci?
Neexistuje univerzální odpověď. Zvažte úlohy, které provádíte nejčastěji, jak přesné musejí být výsledky, množství vyžadovaných úprav, váš rozpočet a limity využití vaší preferované platformy. Otestování několika reprezentativních úloh je užitečnější než výběr pouze na základě pověsti.
Závěrečný verdikt: Vyberte si model, který nejlépe dokončí vaši práci
Gemini 4 Argon, GPT-6 Astra a Claude Opus 5.5 představují různé přístupy k pokročilé asistenci AI. Argon vykazuje silné stránky ve vybraných hodnoceních inženýrství a profesionální práce, Astra se zaměřuje na náročné uvažování a úlohy ovládání počítače a Opus 5.5 se soustředí na kódovací agenty a dlouhodobé profesionální pracovní postupy.
Nejlepší model nemusí být nutně ten s nejvyšším skóre nebo nejdražším API. Je to ten, který spolehlivě dokončí vaše úlohy, dodržuje vaše pokyny, odpovídá vašemu rozpočtu a vyžaduje nejméně zbytečných zásahů.
Použijte oficiální benchmarky k zúžení možností, diskuse na Redditu k pochopení otázek, které si pokládají skuteční uživatelé, a konzistentní praktické testy k učinění konečného rozhodnutí.
S ChatGOAT AI můžete prozkoumávat podporované AI modely a nástroje pro psaní, výzkum, analýzu a kreativní práci v jednom pracovním prostředí. Začněte úkolem, který skutečně potřebujete dokončit, porovnejte kvalitu výsledků a vyberte si pracovní postup, který vám usnadní práci.