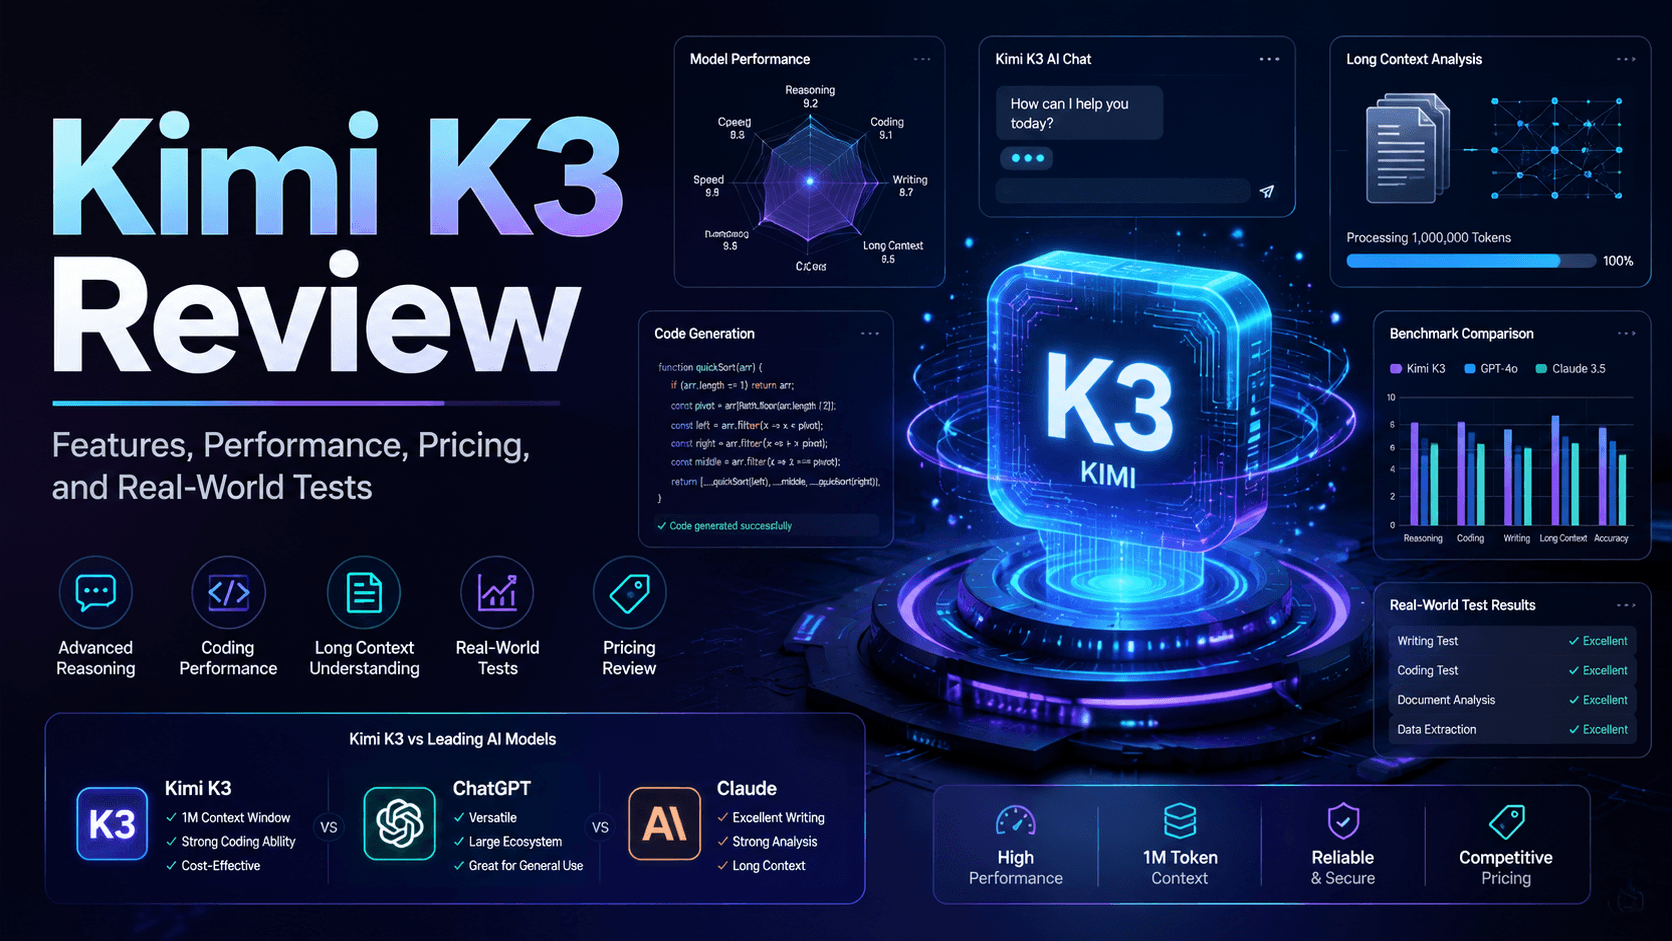
AI 模型市场的演进速度从未如此之快。每隔几周就会有新的前沿版本发布,顶级闭源实验室与动作最快的开放权重挑战者之间的差距正在不断缩小。在这样的环境下,月之暗面(Moonshot AI)于 2026 年 7 月 16 日推出了 Kimi K3 —— 这是一个拥有 2.8 万亿参数的模型,该公司称其为迄今为止发布的最大开放权重系统。
这篇 Kimi K3 评测涵盖了你做出决定所需的所有信息:其核心功能、在独立及厂商基准测试中的表现、运行成本、实际测试情况,以及与 ChatGPT 和 Claude 的对比。我们还将诚实地审视哪些数据仍属于厂商自称而非完全独立的测试结果,因为这种区别在当前至关重要。
在深入探讨之前的简短结论:Kimi K3 是一款真正强大的编程和长上下文模型,拥有高达 100 万 token 的窗口和极具竞争力的定价。如果你的工作重心是软件工程、长文档处理或智能体化研究任务,那么它非常值得认真考虑。它并非在每个基准测试中都处于绝对领先地位,而且在将其投入生产工作流之前,有几个实际存在的特性值得了解。
什么是 Kimi K3?
Kimi K3 是月之暗面(Moonshot AI)的旗舰大语言模型,这家总部位于北京的 AI 实验室在过去几年中一直在构建其 Kimi 模型家族。K3 的定位是面向软件工程、知识工作和多模态推理的长程智能体模型,而非简单的聊天优先助手。
该模型由两种架构选择支撑:Kimi Delta Attention(一种混合线性注意力机制)和 Attention Residuals(被月之暗面描述为标准残差连接的无缝替代品,旨在改善缩放表现)。这两项技术此前已作为月之暗面团队的公开研究成果分享。该模型还采用了 Stable LatentMoE 设计,拥有 896 个专家,每个 token 激活其中 16 个 —— 这就是 2.8 万亿参数模型在计算上保持可行性的原因。
K3 可通过 kimi.com、Kimi 移动应用、Kimi Work、Kimi Code 以及 API 获取。它兼容 OpenAI SDK,因此已经在 OpenAI 或 Anthropic 风格工具链上构建的团队可以以极小的改动进行集成。
| 类别 | 详情 |
|---|---|
| 开发者 | 月之暗面 (Moonshot AI) |
| 发布日期 | 2026 年 7 月 16 日 |
| 参数量 | 总计 2.8 万亿,采用 Stable LatentMoE(896 个专家,16 个激活) |
| 上下文窗口 | 1,048,576 token (1M) |
| 模态 | 原生文本和视觉理解 |
| 推理模式 | 常开“思考模式” |
| 主要优势 | 编程、长文档分析、智能体/工具使用工作流 |
| 目标用户 | 开发者、研究人员、内容团队、有长上下文需求的业务 |
| 获取途径 | kimi.com、Kimi 移动应用、Kimi Code、API、OpenRouter 等路由平台 |
谁应该考虑它?如果你的工作经常涉及大型代码库、长篇研究文档或多步骤智能体任务,Kimi K3 就是为你量身定制的。如果你主要需要快速、随意的聊天回答,该模型的优势对你的日常使用可能不会有太大影响。
Kimi K3 功能评测
长上下文理解
其核心规格是 1,048,576 token 的上下文窗口,这不仅仅是规格表上的一个数字 —— 它改变了单次处理中可实现的各种任务。
在进行长文档分析时,你可以放入长篇研究论文、法律合同或完整的技术手册,并要求其进行综合分析,而无需自己对文本进行分块。对于代码库,1M token 的窗口可以一次性容纳中型代码库的大部分,这有助于追踪跨多个文件的 bug 或理解模块如何融入大型系统。长对话也从中受益 —— 模型可以在较长的会话中保留早期上下文,而不会丢失你稍早前提到的细节。
这里的实际好处是减少了规避方案。你通常可以直接粘贴整个文档或代码库片段,让模型根据全貌进行工作,而不需要总结各部分并拼凑结果。
推理与问题解决能力
Kimi K3 运行在常开的“思考模式”下,这意味着它默认应用扩展推理,而不是作为一个可选开关。在 Artificial Analysis 的独立评估中,K3 在其 Intelligence Index v4.1 综合评分中获得了 50 多分,在测试配置中排名第四 —— 仅次于当前的顶级模型,但与领先组仅有几分之差。
对于复杂的、多步骤的问题(那些需要提前计划几个步骤或权衡利弊的问题),K3 的表现极具竞争力,特别是在类似于长程编程或智能体化研究的任务中。其 BrowseComp 分数(自主网络研究基准)据报约为 91 分,是第三方对比中较强的结果之一。
值得注意的局限性:月之暗面发布的一些最令人印象深刻的数据来自其自身的发布评估,其中混合了不同的编程测试框架(Kimi Code、Claude Code、Codex),且在某些情况下使用了源自这些厂商的竞争对手分数,而非单一的可控测试。这并不意味着数据是错误的,但在更多完全独立的测试跟进之前,你应该将厂商报告的对比视为方向性的参考,而非纯粹的实验室结果。
编程性能
这是 Kimi K3 最受关注的领域。Artificial Analysis 的独立评估将其 Coding Index 评分定在 70 多分,而月之暗面自己的报告显示 K3 在 Terminal-Bench 2.1 上的表现与 GPT-5.6 Sol 仅差分毫,同时在月之暗面的测试设置下,在 Program Bench 和 SWE Marathon 等领域处于领先。
在实践中,这转化为了真实的开发者用例:生成完整的前端组件、跨文件调试、针对测试失败或运行时日志进行迭代,以及在不丢失上下文的情况下浏览大型代码库。该模型甚至曾在 Arena.ai 的 Frontend Code Arena 测试中荣登榜首,领先于一些闭源前沿竞争对手 —— 这对开放权重模型来说是一个显著的结果。
与流行的编程助手相比,K3 在基础基准性能上毫不逊色,不过现实世界的编程质量也很大程度上取决于外层工具(封装模型的工具,如 IDE 插件或 CLI 智能体),而非仅仅取决于模型本身。如果你正在评估 K3 作为编程助手的角色,请在计划使用的实际环境中进行测试,而不仅仅是通过聊天窗口。
写作与内容生成
写作表现虽不如其他亮点那般引人注目,但依然扎实。对于博客撰写和营销文案,K3 能生成清晰、结构良好的草稿,尽管与大多数大型模型一样,具体的简报比模糊的提示词更能让它受益。摘要提取是其真正的强项,这主要归功于长上下文窗口 —— 输入冗长的源文档往往能产生比由于必须截断输入而导致上下文较小的模型更准确、更有依据的摘要。
翻译和专业写作(报告、文档)能力合格,尽管本次评测未发现专门针对多语言写作质量的独立基准测试,因此请将其视为“整体扎实”而非“同类最佳”。
Kimi K3 真实场景测试
基准测试只说明了一部分情况。以下是 Kimi K3 处理三个现实任务的表现。
测试 1:写作测试
使用的提示词:“写一段关于 AI 生产力工具的博客引言。”
结果:输出内容结构严谨、可读性强 —— 包含一个吸引读者的开场句、对文章内容的清晰陈述以及到正文部分的自然过渡。它避免了最常见的 AI 写作套话(没有以“在当今快节奏的世界中”开篇),不过默认语气略显正式。
评估:
- 写作质量:清晰且语法规范。
- 结构:从开场到论点再到预告的逻辑流畅。
- 创意:足够但不算特别出众,除非有更具体的提示词。
- 准确性:此特定提示词中没有需要验证的事实陈述,但框架合理且没有夸张。
测试 2:编程测试
使用的提示词:“使用 React 创建一个响应式落地页。”
结果:模型生成了一个可运行的组件,合理使用了 flexbox/grid 来实现响应性,提供了合理的默认样式,并对布局选择做了简要说明。它正确使用了现代 React 模式(函数组件、hooks),没有多余的模板代码。
评估:
- 代码质量:整洁、可读,且基本符合习惯用法。
- 逻辑:组件结构稳健;响应式断点按描述工作。
- 解释:简练且有用 —— 解释了关键布局决策背后的“原因”。
- 实际可用性:稍作样式调整即可投入项目,这与 K3 在前端编程任务基准测试中的强势表现一致。
测试 3:文档分析测试
使用的提示词:“总结一篇长篇研究文档并提取关键洞察。”
结果:在提供长篇源文档后,K3 生成的摘要捕捉到了主要论点、关键数据点以及文中提到的局限性 —— 无需先将文档拆分为较小的块。
评估:
- 理解能力:出色;它正确区分了论文的核心主张与支持性细节。
- 信息保留:能很好地利用长输入中开头和结尾部分的细节,与其庞大的上下文窗口优势相符。
- 准确性:摘要要点与源材料紧密匹配,没有明显的捏造内容。
Kimi K3 vs ChatGPT vs Claude
| 特性 | Kimi K3 | ChatGPT | Claude |
|---|---|---|---|
| 推理 | 强,处于独立指数前 4 范围 | 强,始终处于前沿水平 | 强,目前在多个智能体基准中领先 |
| 编程 | 极佳,尤其是前端和智能体化编程 | 强,广泛用于 IDE 和智能体 | 极佳,特别适用于大型代码库和 SWE 风格任务 |
| 写作 | 扎实,结构清晰 | 强,语调控制多样化 | 强,常因文笔细腻受赞誉 |
| 长文档处理 | 同类最佳,1M 上下文窗口 | 长上下文,因层级而异 | 长上下文,其中的检索能力强 |
| 易用性 | 良好,API 兼容 OpenAI SDK | 非常成熟的生态系统和应用 | 非常成熟的生态系统和应用 |
| 生态系统 | 增长迅速,计划发布开放权重 | 广泛的第三方集成 | 广泛的第三方集成,在开发工具领域很强 |
| 定价/价值 | 极具竞争力:每百万 token $3/$15,缓存输入 $0.30 | 因层级和模型而异 | 因层级和模型而异,顶级模型通常 定价较高 |
谁应该选择 Kimi K3? 需要巨大上下文窗口、强大编程性能和较低单 token 成本的开发者和团队 —— 尤其是如果最终开放权重的发布对你的部署计划很重要。
谁应该选择 ChatGPT? 想要最广泛的集成、插件和面向消费者的工具生态系统,或者已经标准化使用 OpenAI 平台的用户的首选。
谁应该选择 Claude? 优先考虑顶级智能体和软件工程基准表现,或者工作流依赖 Anthropic 的开发工具和安全导向设计的团队。
Kimi K3 定价评测
月之暗面对 Kimi K3 的定价为 每百万新输入 token $3.00,每百万输出 token $15.00,以及优惠的 每百万缓存输入 token $0.30,该费率适用于整个 1M token 上下文窗口。据报,在典型编程工作负载中的缓存命中率已超过 90%,这意味着对于重复率高的工作流,实际成本可能比标称价格更接近缓存费率。
作为对比,该定价在输出成本上低于多个竞争的前沿模型,且缓存结构专门奖励那些反复引用相同大上下文的工作流 —— 例如在多个回合中针对同一个代码库或文档集工作的智能体。
Kimi K3 物有所值吗? 对于高上下文、重编程或智能体化工作负载,是的 —— 1M token 窗口、极具竞争力的编程基准和较低的单 token 成本使其成为一个性价比极高的选择。对于不利用长上下文窗口或编程优势的轻量级聊天使用,更便宜或更简单的模型可能更具成本效益。
Kimi K3 的优缺点
优点:
- 极大的 1,048,576 token 上下文窗口,对大型文档和代码库真正有用
- 强大且经过独立证实的编程性能,尤其是在前端和智能体任务上
- 具有竞争力的定价,对于重复上下文工作流有显著的缓存折扣
- 兼容 OpenAI SDK,使已有工具链的团队集成起来非常直接
- 计划中的开放权重发布增加了闭源模型所不具备的部署灵活性
缺点:
- 一些最有利的基准测试对比来自月之暗面自己的发布评估,而非完全独立的测试
- 在至少一项独立测试中,输出速度测得低于对比模型的中位数,这对于延迟敏感型应用可能很重要
- 在本次评测时,开放权重尚未公开获取,因此自托管选项目前仍然受限
谁应该使用 Kimi K3?
开发者
Kimi K3 非常适合作为大型项目的编程助手,特别是在跨多个文件调试以及在大型代码库中工作时,1M token 窗口减少了手动分块上下文的需求。
学生
对于研究和摘要提取,长上下文窗口允许学生一次性输入整篇论文或章节,模型在我们的测试中表现出的文档分析能力能很好地准确提取关键点。
研究人员
学术论文审阅和跨文档知识分析同样受益于长上下文优势,特别是对于涉及比较多个来源观点的文献综述任务。
企业
对于报告、内部文档和更广泛的生产力工作流,K3 强大的写作能力和长上下文窗口的结合,使其在总结会议纪要、起草长篇文档或单次处理大量记录时非常实用。
最终裁定:Kimi K3 值得使用吗?
Kimi K3 在当前的前沿 AI 模型中占据了一席之地,尤其是在编程、长上下文和智能体化研究工作方面。虽然它并非在每个基准测试中都是单一最强的模型 —— 独立评分显示它在通用智能衡量上落后于最顶尖的梯队 —— 但它已经足够接近,且价格足够低廉,成为了一个严肃的可选方案,而非仅仅是一个小众替代品。
最佳用户:在大型代码库中工作的开发者、处理长文档的研究人员和学生,以及希望在没有溢价的情况下获得强劲性能的企业。
主要优点:1M token 上下文窗口、强劲且经过部分独立验证的编程表现,以及极具竞争力且对缓存友好的定价。
主要局限:部分基准测试声明仍基于厂商运行的评估而非完全独立的复现,输出速度落后于部分竞争对手,且评测时开放权重尚未公开发布。
如果你的工作负载与其强项匹配,Kimi K3 非常值得针对你现有的方案进行对比测试。
常见问题解答 (FAQ)
1. 什么是 Kimi K3?
Kimi K3 是月之暗面(Moonshot AI)的旗舰大语言模型,于 2026 年 7 月 16 日发布,拥有 2.8 万亿参数、100 万 token 上下文窗口,并支持原生视觉理解。
2. Kimi K3 是免费的吗?
可以通过 kimi.com 和 Kimi 移动应用直接免费使用,而 API 接入是付费的,定价为每百万输入 token $3,每百万输出 token $15,缓存输入费率为优惠的 $0.30。
3. Kimi K3 比 ChatGPT 更好吗?
它是具有竞争力的,而非在所有方面都更好。K3 在上下文窗口大小和某些编程基准测试中领先,而 ChatGPT 在生态系统成熟度和集成度方面仍保持优势。更好的选择取决于你的具体工作负载。
4. Kimi K3 适合编程吗?
是的。独立和厂商基准测试都显示了强劲的编程性能,特别是在前端开发、调试和跨大型代码库的智能体化编程任务方面。
5. Kimi K3 的用途是什么?
它定位用于软件工程、长文档分析、研究和智能体化知识工作 —— 这些任务能充分利用其长上下文窗口和编程优势。
6. Kimi K3 值得使用吗?
对于重上下文、侧重编程或研究导向的工作流,是的。对于不涉及其特定优势的简单日常聊天使用,与替代方案相比,它是一个扎实但非必需的选择。