Viktiga slutsatser
- Claude Fable 5.1 utökar Claude Fable 5 med starkare långvarig agentbaserad kodning, flerstegsforskning samt hantering av dokument, kalkylblad och presentationer, till samma priser för input- och output-tokens.
- Cache-läsningar är ungefär 75 procent billigare än tidigare, vilket har störst betydelse för utvecklare som kör upprepade sessioner eller sessioner med lång kontext.
- Claude Mythos 5.1 är samma underliggande modell som Fable 5.1, men den är endast tillgänglig via inbjudan genom Project Glasswing och byggd för arbete inom cybersäkerhet och livsvetenskap som behöver färre produktionsrestriktioner.
- Rapporterade förbättringar i benchmarks jämfört med Fable 5 är störst inom kodning och arbetsflödesuppgifter för företag, inte bara marginella förbättringar i resonemang.
- Du kan prova Claude Fable 5.1 utan någon API-konfiguration via chattplattformar som ChatGoat AI.
Vad är Claude Fable 5.1?
Claude Fable 5.1 är Anthropics nuvarande toppmodell för kodning, forskning och kunskapsarbete, placerad över Claude Opus 5 i sortimentet för de svåraste uppgifterna. Anthropics egen vägledning är att de flesta fortfarande bör börja med Opus 5 för vardaglig användning och vända sig till Fable 5.1 när en uppgift kräver avancerade resonemang, en lång rad steg eller när Opus 5 redan brister även vid högre ansträngningsinställningar.
Denna inramning är viktig eftersom den berättar vem Fable 5.1 faktiskt är utformad för.
Utvecklare – Modellen är byggd för långvariga agentbaserade kodningssessioner, vilket innebär uppgifter där den behöver planera, skriva kod, testa den, upptäcka fel och justera över många steg snarare än att bara producera ett kodblock och stanna. Den introducerar också en betafunktion som visar läsbara framstegsuppdateringar medan den arbetar genom verktygsanrop, så att du slipper titta på en tom skärm under en lång uppgift.
Innehållsskapare – För SEO- och marknadsföringsarbete ligger den praktiska nyttan i flerstegs innehållsprojekt, forskningstunga texter som behöver hämta information från flera källor, och redigeringsrundor som kräver att modellen behåller mycket kontext om varumärkets röst och tidigare utkast utan att tappa bort tidigare instruktioner.
Forskare – Med ett kontextfönster på 1 miljon tokens kan Fable 5.1 hantera stora volymer källmaterial, vilket innebär långa rapporter, flera forskningsrapporter eller omfattande transkriptioner i en enda konversation utan att behöva sammanfatta och mata in information på nytt hela tiden.
Företag – Den tydligaste affärsrelevanta siffran som Anthropic har publicerat är på AutomationBench, ett benchmark utformat för att återspegla arbetsflödesuppgifter i företag, där Fable 5.1 fick betydligt högre poäng än både Fable 5 och Opus 5. Det pekar på starkare prestanda för den typ av repetitivt, regelbaserat arbete som företag vill automatisera.
Claude Mythos 5.1 förklarad: Vad gör den annorlunda?
Claude Mythos 5.1 är inte en separat modell på samma sätt som Fable 5.1 och Opus 5 är separata. Anthropic har bekräftat att Fable 5.1 och Mythos 5.1 är exakt samma underliggande modell. Det som skiljer dem åt är åtkomsten och säkerhetskonfigurationen som omger den.
Mythos 5.1 är endast tillgänglig för organisationer som accepterats i Project Glasswing, i allmänhet cybersäkerhetsföretag och forskningsgrupper inom livsvetenskap som har ett legitimt behov av förmågor som Anthropic begränsar i den allmänna versionen. Anthropics tester visade att Mythos 5.1:s kemiska och biologiska förmågor är högre än Mythos 5, även om de fortfarande ligger under nästa risknivå enligt Anthropics Responsible Scaling Policy, och dess cybersäkerhetsförmåga under lättade säkerhetsåtgärder är den högsta som uppmätts bland Anthropics hittills släppta modeller, samtidigt som den fortfarande befinner sig i kategorin för lägre risk i Anthropics Frontier Compliance Framework.
För nästan alla som läser denna artikel är Mythos 5.1 inte något du behöver eller ens kan anmäla dig till. Om du inte är en del av ett granskat program för cybersäkerhet eller livsvetenskap som arbetar direkt med Anthropic, AWS eller Google Cloud, ger Fable 5.1 dig samma underliggande intelligens med standardmässiga säkerhetsåtgärder på plats.
| Jämförelsepunkt | Claude Fable 5.1 | Claude Mythos 5.1 |
|---|---|---|
| Målanvändare | Utvecklare, skribenter, forskare, företag generellt | Granskade organisationer inom cybersäkerhet och livsvetenskap |
| Tillgänglighet | Allmänt tillgänglig via Claude API och molnplattformar | Endast via inbjudan genom Project Glasswing |
| Huvudsakligt syfte | Allmän kodning, forskning och kunskapsarbete | Känslig forskning inom cyber och biologi med färre restriktioner |
| Bästa användningsområden | SEO-innehåll, kodningsprojekt, dokumentanalys, agenter | Sårbarhetsforskning, biosäkerhetsarbete, defensiva cyberuppgifter |
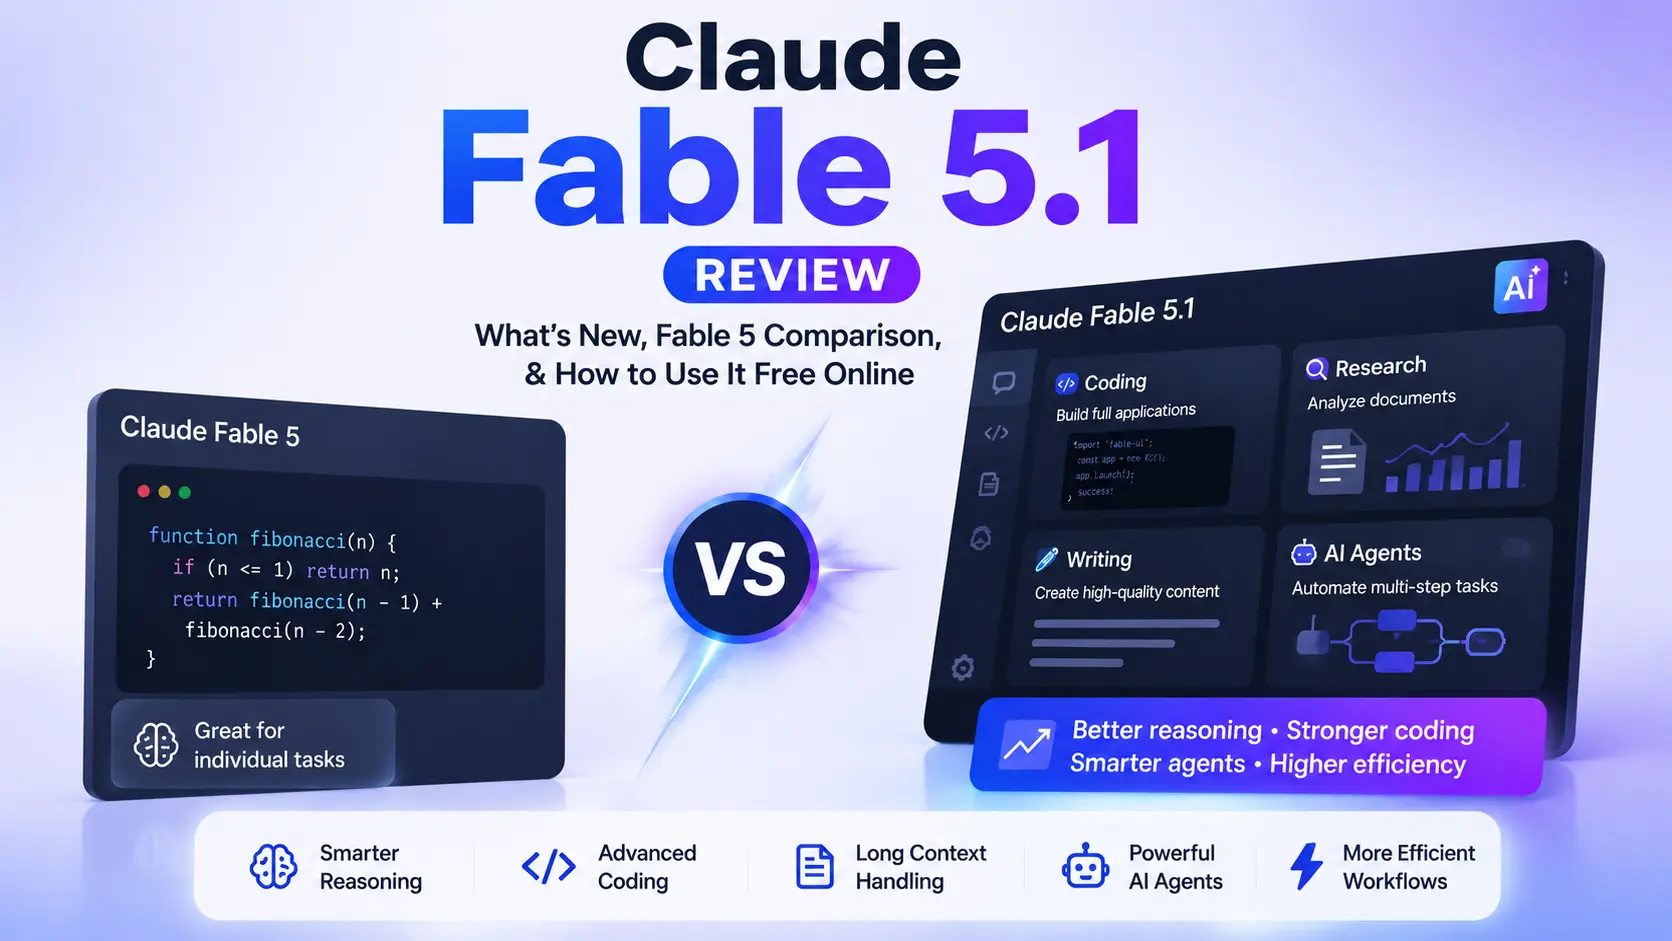
Claude Fable 5.1 mot Claude Fable 5: Vad har ändrats?
Detta är den jämförelse som de flesta som söker på detta ämne faktiskt vill ha, så det är värt att vara exakt med vad Anthropic faktiskt har publicerat snarare än att gissa.
| Kategori | Claude Fable 5 | Claude Fable 5.1 |
|---|---|---|
| Kodning (Terminal Bench 4.0) | 42,0 procent | 55,8 procent |
| Kunskapsarbete (GDPval AA v2) | 1 723 | 1 853 |
| Arbetsflöden för företag (AutomationBench) | 17,1 procent | 31,4 procent |
| Kontextfönster | Stöd för stor kontext | 1 miljon tokens |
| Output-kapacitet | Standardgränser för output | Upp till 128 000 tokens per svar |
| Prissättning för cache-läsning | Standardtaxa | Cirka 75 procent billigare |
| Ansträngningskontroll | Fast per konversation | Justerbar under konversationens gång (beta) |
| Innehållets proveniens | Ingår ej | Inbyggd vattenmärkning för AI-genererad text |
Några av dessa siffror förtjänar ett sammanhang snarare än att läsas som ren marknadsföring. Anthropic har varit tydliga med att detta är poäng rapporterade av leverantören, inte oberoende verifierade rankningar, så betrakta dem som en riktningsvisare för var modellen har förbättrats mest snarare än en absolut sanning. Även med det förbehållet är hoppet i Terminal Bench och AutomationBench tillräckligt stort för att det troligen återspeglar en verklig förändring i hur modellen hanterar flerstegsuppgifter, inte bara brus mellan benchmark-körningar.
Vad kommer Fable 5-användare faktiskt att märka efter att ha bytt till Fable 5.1? Den mest praktiska förändringen rör planering och uppföljning. Fable 5 var redan kapabel vid enskilda uppgifter, vilket innebär att man ger den ett tydligt jobb och den utför det jobbet väl. Fable 5.1 är mer byggd för flerstegsprojekt som kräver planering, genomförande, granskning av vad den producerat och förbättring i en andra eller tredje vända utan att du behöver upprepa kontexten varje gång. Om ditt SEO-arbetsflöde innebär att du instruerar modellen en gång och sedan låter den skriva utkast, självgranska och förfina en artikel över flera steg, är det där uppgraderingen bör märkas mest.
Det finns också tre genomgripande förändringar som är värda att känna till om du eller ditt team anropar API:et direkt: tvingad verktygsanvändning returnerar nu ett fel istället för att tyst ignoreras, tidigare Claude-modeller kan inte läsa Fable 5.1:s interna tankeblock, och att redigera en tidigare vända i en konversation ogiltigförklarar dessa tankeblock. Inget av detta påverkar vardaglig chattanvändning, men det spelar roll om du har byggt automatiserade arbetsflöden ovanpå Fable 5.
Claude Fable 5.1 – Prestandagranskning och tester i verkligheten
Istället för att presentera uppdiktrade benchmark-körningar som om de vore kontrollerade tester, är här vad modellens faktiska designförändringar antyder för tre vanliga användningsområden, baserat på Anthropics publicerade förmågor.
Skriva en lång SEO-artikel
För en längre text är det delarna av arbetsflödet som rör översiktsplanering och redigering i flera steg som gynnas mest av förändringarna i Fable 5.1. Eftersom modellen kan hålla mycket mer kontext på en gång, kan den hålla reda på en fullständig innehållsinstruktion, konkurrentanteckningar och sökord tillsammans utan att tappa tråden mitt i ett långt utkast. Den justerbara ansträngningsinställningen innebär också att du kan be om ett snabbt första utkast med lägre ansträngning, för att sedan höja ansträngningsnivån för de faktiska utkasts- och redigeringsstadierna inom samma konversation, istället för att börja om.
Koda en webbapplikation
Detta är det område där Anthropics egna benchmark-siffror pekar tydligast på förbättring. En starkare Terminal Bench-poäng antyder bättre prestanda på realistiska kodningsuppgifter i flera steg som involverar att köra kommandon, kontrollera resultat och åtgärda problem snarare än att skriva en isolerad funktion. I praktiken bör detta innebära färre sessioner som stannar upp för att modellen tappar bort vad den redan försökt, och ett mer tillförlitligt beteende under en kodningssession som omfattar planering, skrivande, testning och felsökning.
Analysera komplexa dokument
Med ett kontextfönster på 1 miljon tokens och en output-kapacitet på 128 000 tokens är Fable 5.1 byggd för att ta in omfattande källmaterial, flera långa rapporter eller omfattande kontrakt, och producera en genuint lång, strukturerad output som svar, snarare än en kort sammanfattning som utelämnar detaljer. För forskningstungt arbete är den kombinationen av stor input och stor output en mer betydelsefull specifikation än något enskilt benchmark-resultat.
Claude Fable 5.1-funktioner du bör känna till
Förbättrat resonemang. Fable 5.1:s framsteg i benchmarks för kunskapsarbete tyder på en verklig förbättring i hanteringen av problem som kräver att man kopplar ihop flera bitar information snarare än att svara på en enskild, isolerad fråga.
Bättre kodningsförmåga. Hoppet i Terminal Bench 4.0 är den tydligaste signalen här, och det stämmer överens med Anthropics uttalade fokus på långvarig agentbaserad kodning.
Förståelse för lång kontext. Ett kontextfönster på 1 miljon tokens innebär att du kan arbeta med hela kodbaser, långa dokument eller omfattande forskningsmaterial i en och samma session.
Förbättrade arbetsflöden för AI-agenter. Betafunktionen som visar läsbara framstegsuppdateringar mellan verktygsanrop, plus ansträngningsjustering under pågående konversation, pekar båda mot en modell som är byggd för att styras och övervakas under långa automatiserade uppgifter, inte bara för enstaka prompter.
Bättre effektivitet. Sänkningen av priset för cache-läsning med cirka 75 procent är den mest konkreta effektivitetsvinsten, särskilt värdefull för alla som kör upprepade frågor mot samma stora kontext, till exempel ett dokument du analyserar genom många olika frågor.
Claude Fable 5.1 vs GPT 5.6 vs Gemini
OpenAI släppte sin GPT 5.6-familj, bestående av Sol, Terra och Luna, i juli 2026, och positionerade Sol som sitt flaggskepp för kodning, kunskapsarbete och cybersäkerhet, med Terra som ett balanserat mellanalternativ och Luna som budgetmodell. Googles Gemini-serie har fortsatt att konkurrera på liknande mark med sina egna versioner fokuserade på resonemang och lång kontext.
Det finns inget oberoende verifierat benchmark som jämför Fable 5.1, GPT 5.6 Sol och den senaste Gemini-modellen sida vid sida under identiska förhållanden, så alla specifika numeriska jämförelser du ser som hävdar att en modell slår en annan med en exakt procentsats bör behandlas med försiktighet, inklusive siffror publicerade av företagen själva om deras egna modeller.
Vad som kan sägas med rimlig säkerhet, baserat på vad varje företag har publicerat om sin egen modell:
- För utvecklare är både Fable 5.1 och GPT 5.6 Sol uttryckligen byggda kring långvariga kodningsuppgifter i flera steg snarare än generering av enstaka funktioner, och båda företagen rapporterar stora vinster jämfört med sina tidigare generationer i kodningstunga benchmarks. Valet mellan dem beror sannolikt på dina befintliga verktyg och hur varje modell hanterar just din kodbas, snarare än på ett enskilt benchmark-resultat.
- För skribenter är Fable 5.1:s större kontextfönster och justerbara ansträngningsnivå användbara för långformat, forskningstunt innehåll, även om skrivkvalitet är genuint subjektivt och värt att testa direkt mot din egen stilguide snarare än att lita på någon recension, inklusive denna.
- För allmänna användare erbjuder alla tre företagen nu en billigare nivå riktad mot vardagliga frågor, så om du främst ställer snabba frågor snarare än att köra långa agentuppgifter, spelar de praktiska skillnaderna mellan toppmodellerna mindre roll än pris och gränssnittets bekvämlighet.
Så använder du Claude Fable 5.1 gratis på ChatGoat AI
Om du inte behöver direkt API-åtkomst behöver du inte ställa in fakturering, hantera API-nycklar eller skriva någon kod för att prova Fable 5.1. Chattplattformar som ChatGoat AI ger dig tillgång till Claude-modeller, inklusive Fable 5.1, via ett vanligt webbläsargränssnitt.
Steg 1: Öppna ChatGoat AI
Gå till ChatGoat AI:s webbplats i din webbläsare. Ingen lokal installation krävs.
Steg 2: Välj Claude Fable 5.1 bland de tillgängliga AI-modellerna
Välj Fable 5.1 från modellistan innan du börjar din konversation, eftersom olika uppgifter kan kräva olika modeller beroende på kostnad och komplexitet.
Steg 3: Skriv in din prompt och börja chatta
Skriv din begäran på samma sätt som i vilket chattgränssnitt som helst, så svarar modellen direkt. Din konversationshistorik sparas för uppföljningsfrågor.
Huvudfördelen med detta tillvägagångssätt är att man slipper krångel med installationen. Det krävs ingen API-konfiguration, inget behov av att manuellt spåra tokenanvändning och inget separat utvecklarkonto, vilket gör det till en rimlig utgångspunkt för skrivande, kodningshjälp och dagliga forskningsuppgifter.
Exempel på prompt för skrivande:
"Skapa en SEO-optimerad artikelöversikt om AI-produktivitetsverktyg. Inkludera sökord, rubrikstruktur och FAQ-frågor."
Exempel på prompt för kodning:
"Bygg en React-dashboard med användarautentisering och förklara utvecklingsprocessen steg för steg."
Exempel på prompt för forskning:
"Analysera detta dokument och sammanfatta de viktigaste resultaten, organiserat efter ämne."
Bästa användningsområden för Claude Fable 5.1
För utvecklare passar Fable 5.1 bäst för långa kodningssessioner som involverar felsökning, refaktorering och projekt med flera filer där modellen behöver behålla kontexten över många steg.
För SEO-skribenter lämpar sig det större kontextfönstret och förmågan till redigering i flera steg för långformat innehåll, innehållsrevisioner som refererar till flera befintliga sidor samtidigt, och briefs som kombinerar sökordsanalys med varumärkets riktlinjer.
För studenter är modellens dokumenthanteringsförmåga användbar för att sammanfatta lång läsning, arbeta igenom problemuppsättningar som kräver flera steg och få tydliga förklaringar.
För företagsteam tyder framstegen i AutomationBench på en verklig nytta för repetitiva arbetsflödesuppgifter, såsom bearbetning av strukturerad data, utformning av standarddokument eller hantering av godkännandelogik i flera steg.
För alla dessa grupper är ChatGoat AI:s roll helt enkelt att ta bort friktionen med att växla mellan plattformar eller hantera separata API-konton för olika uppgifter, så att du kan växla mellan skrivande, kodning och forskningsarbete med samma modell och samma gränssnitt.
Claude Fable 5.1 – Prissättning och tillgänglighet
Fable 5.1 är prissatt till samma rater för input- och output-tokens som Fable 5, så det sker ingen direkt prisökning för standardanvändning. Den betydande prissättningsförändringen gäller cache-läsningar, som är cirka 75 procent billigare, en detalj som främst gynnar utvecklare och företag som kör stora volymer eller upprepade arbetsbelastningar via API:et.
Direkt API-åtkomst är vettigt om du bygger en applikation, behöver programmatisk kontroll eller kör stora volymer automatiserade uppgifter där kostnadseffektivitet per token spelar roll i stor skala. För tillfällig eller måttlig användning, särskilt för skrivande, forskning och vardagliga kodningsfrågor, är en chattplattform som ChatGoat AI ett enklare och ofta gratis eller billigt sätt att uppleva samma modell utan att behöva hantera API-fakturering direkt.
Är det värt att uppgradera till Claude Fable 5.1?
Vilka bör uppgradera:
- Utvecklare som kör långa kodningssessioner i flera steg där Fable 5 tidigare tappade kontexten eller stannade upp mitt i en uppgift.
- Forskare som arbetar med stora källdokument och behöver det utökade kontextfönstret.
- Innehållsskapare som hanterar långformatsprojekt med flera utkast som drar nytta av den större kontexten och den justerbara ansträngningsinställningen.
- Företag som automatiserar repetitiva arbetsflöden, givet den rapporterade förbättringen i AutomationBench.
Vilka som kanske inte behöver uppgradera:
Användare som främst ställer enkla frågor i ett steg, vill ha snabba fakta, korta förklaringar eller grundläggande korrekturläsning, kommer sannolikt inte att märka någon betydande skillnad mellan Fable 5 och Fable 5.1, eftersom de största rapporterade vinsterna specifikt gäller prestanda i långa flerstegsuppgifter snarare än kvaliteten på korta svar.
Användaråsikter och feedback från communityn
Tidiga diskussioner kring detta släpp tenderar att samlas kring några återkommande teman snarare än ett enskilt utlåtande.
Vad användarna gillar. Prissänkningen på cache-läsning får tydligt bifall från utvecklare som kör sessioner med stor eller upprepad kontext, eftersom det direkt sänker kostnaden för just den typ av arbete med lång kontext som Fable 5.1 är avsedd för. Funktionen för ansträngningsjustering mitt i en konversation välkomnas också generellt, eftersom den tar bort behovet av att starta om en session bara för att ändra hur hårt modellen arbetar med ett visst steg.
Vanliga betänkligheter. En del av diskussionen kring detta släpp fokuserar mindre på Fable 5.1 i sig och mer på det bredare mönstret av snabba modellsläpp i branschen, där användare ifrågasätter om ett nytt flaggskepp var fjärde månad gör det svårare att utvärdera verkliga förbättringar jämfört med stegvis marknadsföring. Det pågår också samtal om vattenmärkning för innehållets proveniens, där vissa användare stöder transparensåtgärder medan andra är osäkra på hur åtkomst till detektering kommer att hanteras framöver.
Verkliga förväntningar. Det allmänna intrycket är att Fable 5.1 betraktas som en solid, praktisk uppdatering snarare än ett dramatiskt språng, särskilt stark för kodning och agentbaserade arbetsflöden, med mer måttlig inverkan för användare som mestadels använder Claude för enkla konversationsuppgifter.
FAQ-sektion
Vad är Claude Fable 5.1?
Claude Fable 5.1 är Anthropics flaggskeppsmodell för kodning, forskning och kunskapsarbete, släppt den 1 september 2026 som en uppdatering till Claude Fable 5, med starkare långvarig agentförmåga och ett större kontextfönster.
Är Claude Fable 5.1 bättre än Claude Fable 5?
För långa flerstegsuppgifter som kodningsprojekt, automatisering av arbetsflöden i företag och dokumenttung forskning, visar Fable 5.1 betydligt högre rapporterade benchmark-poäng än Fable 5. För korta, enkla frågor är skillnaden mycket mindre märkbar.
Vad är Claude Mythos 5.1?
Claude Mythos 5.1 är samma underliggande modell som Fable 5.1, men med en annan säkerhetskonfiguration, och görs endast tillgänglig för granskade organisationer inom cybersäkerhet och livsvetenskap genom Anthropics program Project Glasswing.
Hur kan jag använda Claude Fable 5.1 online?
Du kan få tillgång till den via Anthropics egna Claude-produkter, via Claude API eller via tredjepartsplattformar som ChatGoat AI som erbjuder webbläsarbaserad åtkomst utan krav på API-konfiguration.
Kan jag använda Claude Fable 5.1 utan API-åtkomst?
Ja. Chattplattformar som ChatGoat AI låter dig välja Fable 5.1 och börja chatta direkt, utan att konfigurera API-nycklar eller fakturering.
Är Claude Fable 5.1 gratis?
Direkt API-åtkomst är avgiftsbelagd och baseras på tokenanvändning. Vissa chattplattformar erbjuder gratis eller billig åtkomst till Fable 5.1 genom sina egna abonnemang, vilket ofta är det enklaste sättet att prova modellen innan man överväger en direkt API-integration.