Belangrijkste leerpunten
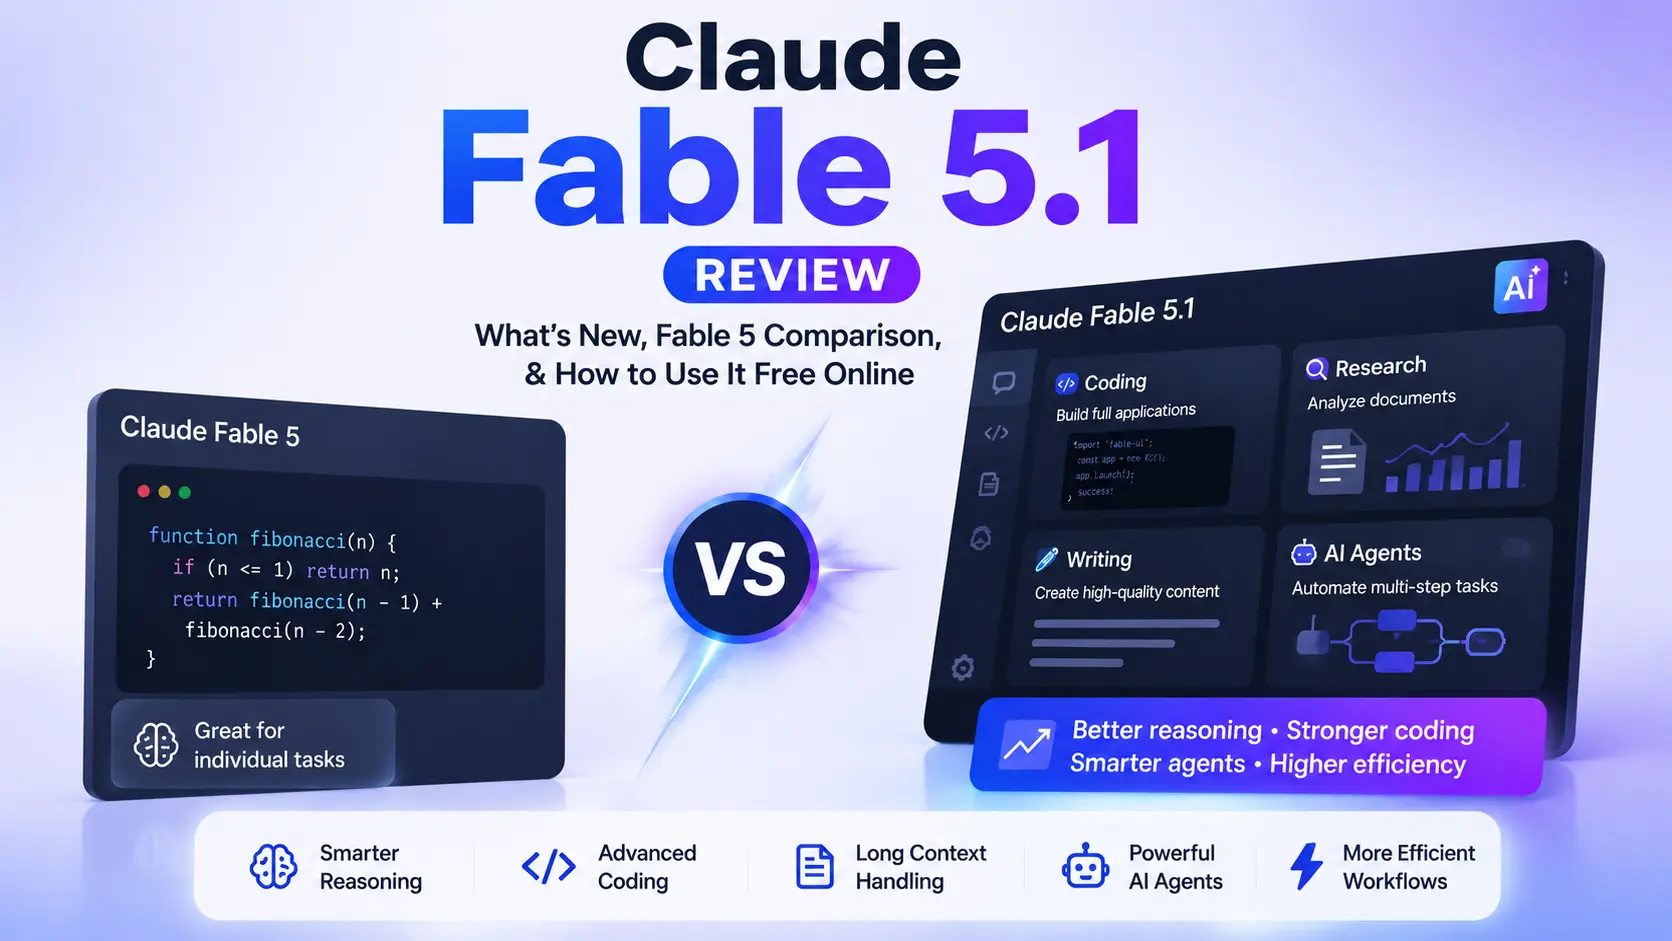
- Claude Fable 5.1 breidt Claude Fable 5 uit met sterkere, langdurige agentische codering, meerstaps onderzoek en verwerking van documenten, spreadsheets en dia's, tegen dezelfde tokenprijzen voor input en output.
- Cache-leesacties zijn ongeveer 75 procent goedkoper dan voorheen, wat vooral van belang is voor ontwikkelaars die herhaalde sessies of sessies met een lange context uitvoeren.
- Claude Mythos 5.1 is hetzelfde onderliggende model als Fable 5.1, maar is alleen op uitnodiging beschikbaar via Project Glasswing en gebouwd voor werk op het gebied van cybersecurity en biowetenschappen dat minder productierestricties nodig heeft.
- De gerapporteerde benchmarkwinsten ten opzichte van Fable 5 zijn het grootst bij codering en zakelijke workflowtaken, en niet slechts marginale verbeteringen in redeneren.
- U kunt Claude Fable 5.1 proberen zonder enige API-configuratie via chatplatforms zoals ChatGoat AI.
Wat is Claude Fable 5.1?
Claude Fable 5.1 is het huidige topmodel van Anthropic voor codering, onderzoek en kenniswerk, en staat boven Claude Opus 5 in de reeks voor de moeilijkste taken. Anthropic adviseert zelf dat de meeste mensen nog steeds met Opus 5 zouden moeten beginnen voor dagelijks gebruik, en naar Fable 5.1 moeten grijpen wanneer een taak veeleisende redenering, een lange reeks stappen vereist, of wanneer Opus 5 al tekortschiet, zelfs bij instellingen voor hogere inspanning.
Die inkadering is belangrijk omdat het aangeeft voor wie Fable 5.1 echt is ontworpen.
Ontwikkelaars - Het model is gebouwd voor langdurige agentische coderingssessies, wat taken betekent waarbij het moet plannen, code moet schrijven, deze moet testen, een fout moet opmerken en over vele stappen heen moet aanpassen, in plaats van ←←n blok code te produceren en te stoppen. Het introduceert ook een b│tafunctie die leesbare voortgangsupdates toont terwijl het door tool-aanroepen werkt, zodat u tijdens een lange taak niet naar een leeg scherm staart.
Contentcreators - Voor SEO- en marketingwerk ligt het praktische voordeel in meerstaps contentprojecten, onderzoeksintensieve stukken die uit verschillende bronnen moeten putten, en bewerkingsrondes waarbij het model veel context moet onthouden over uw merkstem en eerdere ontwerpen zonder eerdere instructies uit het oog te verliezen.
Onderzoekers - Met een contextvenster van 1 miljoen tokens kan Fable 5.1 grote hoeveelheden bronmateriaal bevatten, zoals lange rapporten, meerdere wetenschappelijke artikelen of uitgebreide transcripties, in ←←n enkel gesprek zonder dat informatie voortdurend hoeft te worden samengevat en opnieuw ingevoerd.
Bedrijven - Het duidelijkste zakelijk relevante getal dat Anthropic heeft gepubliceerd is op AutomationBench, een benchmark die bedoeld is om zakelijke workflowtaken te weerspiegelen, waar Fable 5.1 aanzienlijk hoger scoorde dan zowel Fable 5 als Opus 5. Dat wijst op sterkere prestaties bij het soort repetitief, op regels gebaseerd werk dat bedrijven willen automatiseren.
Claude Mythos 5.1 uitgelegd: Wat maakt het anders?
Claude Mythos 5.1 is geen apart model in de zin dat Fable 5.1 en Opus 5 dat wel zijn. Anthropic heeft bevestigd dat Fable 5.1 en Mythos 5.1 exact hetzelfde onderliggende model zijn. Wat verschilt is de toegang en de veiligheidsconfiguratie eromheen.
Mythos 5.1 is alleen beschikbaar voor organisaties die zijn toegelaten tot Project Glasswing, doorgaans cybersecuritybedrijven en onderzoeksgroepen in de biowetenschappen die een legitieme behoefte hebben aan mogelijkheden die Anthropic in de algemene release beperkt. Uit tests van Anthropic bleek dat de chemische en biologische mogelijkheden van Mythos 5.1 hoger zijn dan die van Mythos 5, hoewel ze nog steeds onder de volgende risicocategorie vallen volgens de Responsible Scaling Policy van Anthropic. De cybersecuritycapaciteit onder versoepelde veiligheidsmaatregelen is de hoogste die tot nu toe is gemeten onder de door Anthropic uitgebrachte modellen, terwijl deze nog steeds in de lagere risicocategorie van Anthropic's Frontier Compliance Framework valt.
Voor bijna iedereen die dit artikel leest, is Mythos 5.1 niet iets dat u nodig heeft of waarvoor u zich zelfs kunt aanmelden. Als u geen deel uitmaakt van een doorgelicht cybersecurity- of biowetenschappenprogramma dat rechtstreeks met Anthropic, AWS of Google Cloud samenwerkt, biedt Fable 5.1 u dezelfde onderliggende intelligentie met de standaard veiligheidsmaatregelen.
| Vergelijkingspunt | Claude Fable 5.1 | Claude Mythos 5.1 |
|---|---|---|
| Doelgebruikers | Ontwikkelaars, schrijvers, onderzoekers, algemene bedrijven | Doorgelichte cybersecurity- en biowetenschapsorganisaties |
| Beschikbaarheid | Breed beschikbaar via Claude API en cloudplatforms | Alleen op uitnodiging via Project Glasswing |
| Hoofddoel | Algemene doeleinden voor codering, onderzoek en kenniswerk | Gevoelig cyber- en biologieonderzoek met minder beperkingen |
| Beste gebruikssituaties | SEO-content, coderingsprojecten, documentanalyse, agents | Onderzoek naar kwetsbaarheden, biosecurity-werk, defensieve cyber-taken |
Claude Fable 5.1 vs Claude Fable 5: Wat is er veranderd?
Dit is de vergelijking waar de meeste mensen die naar dit onderwerp zoeken eigenlijk in genteresseerd zijn, dus het is de moeite waard om precies te zijn over wat Anthropic daadwerkelijk heeft gepubliceerd in plaats van te gissen.
| Categorie | Claude Fable 5 | Claude Fable 5.1 |
|---|---|---|
| Codering (Terminal Bench 4.0) | 42,0 procent | 55,8 procent |
| Kenniswerk (GDPval AA v2) | 1.723 | 1.853 |
| Zakelijke workflows (AutomationBench) | 17,1 procent | 31,4 procent |
| Contextvenster | Grote context ondersteund | 1 miljoen tokens |
| Outputcapaciteit | Standaard outputlimieten | Tot 128.000 tokens per antwoord |
| Cache-lees Tarieven | Standaard tarief | Ongeveer 75 procent goedkoper |
| Inspanningscontrole | Vast per gesprek | Aanpasbaar halverwege het gesprek (b│ta) |
| Herkomst van inhoud | Niet inbegrepen | Ingebouwde watermerken voor door AI gegenereerde tekst |
Enkele van deze cijfers verdienen context in plaats van als pure marketing te worden gelezen. Anthropic is duidelijk geweest dat dit door leveranciers gerapporteerde scores zijn, niet onafhankelijk geverifieerde ranglijsten, dus beschouw ze als een indicatie van waar het model het meest is verbeterd in plaats van als een absolute waarheid. Zelfs met dat voorbehoud is de sprong op Terminal Bench en AutomationBench groot genoeg dat het waarschijnlijk een echte verandering weerspiegelt in hoe het model meerstaps taken afhandelt, en niet alleen ruis tussen benchmarkruns.
Wat zullen Fable 5-gebruikers daadwerkelijk merken na de overstap naar Fable 5.1? De meest praktische verschuiving heeft betrekking op planning en uitvoering. Fable 5 was al bekwaam in individuele taken, wat betekent dat u het ←←n duidelijke opdracht geeft en het die opdracht goed uitvoert. Fable 5.1 is meer gebouwd voor meerstaps projecten die planning vereisen, het uitvoeren van het werk, het beoordelen van wat het heeft geproduceerd en het verbeteren in een tweede of derde ronde zonder dat u de context telkens opnieuw hoeft te vermelden. Als uw SEO-workflow inhoudt dat u het model ←←n keer instrueert en het vervolgens in verschillende beurten een artikel laat opstellen, zelf laat controleren en verfijnen, dan is dat waar de upgrade het meest tot uiting zou moeten komen.
Er zijn ook drie ingrijpende wijzigingen die u moet weten als u of uw team de API rechtstreeks aanroepen: gedwongen gebruik van tools geeft nu een foutmelding in plaats van stilletjes te worden genegeerd, eerdere Claude-modellen kunnen de interne denkblokken van Fable 5.1 niet lezen, and het bewerken van een eerdere beurt in een gesprek maakt die denkblokken ongeldig. Niets hiervan heeft invloed op informeel chatgebruik, maar het is wel belangrijk als u geautomatiseerde workflows bovenop Fable 5 hebt gebouwd.
Claude Fable 5.1 Prestatiebeoordeling en praktijktests
In plaats van verzonnen benchmarkruns te presenteren alsof het gecontroleerde tests zijn, ziet u hier wat de werkelijke ontwerpwijzigingen van het model suggereren voor drie veelvoorkomende gebruikssituaties, gebaseerd op de gepubliceerde mogelijkheden van Anthropic.
Een lang SEO-artikel schrijven
Voor een lang stuk zijn de onderdelen van de workflow die het meest profiteren van de wijzigingen in Fable 5.1 de schetsplanning en het bewerken in meerdere rondes. Omdat het model veel meer context tegelijk kan vasthouden, kan het een volledige contentbriefing, aantekeningen van concurrenten en zoekwoorden bij elkaar houden zonder de draad halverwege een lang concept kwijt te raken. De aanpasbare inspanningsinstelling betekent ook dat u in een eerste ronde om een snelle schets kunt vragen met minder inspanning, en vervolgens het inspanningsniveau kunt verhogen voor het daadwerkelijke schrijf- en bewerkingsproces binnen hetzelfde gesprek, in plaats van opnieuw te hoeven beginnen.
Een webapplicatie coderen
Dit is het gebied waar de eigen benchmarkcijfers van Anthropic het duidelijkst wijzen op verbetering. Een hogere Terminal Bench-score suggereert betere prestaties bij realistische, meerstaps coderingsopdrachten waarbij commando's worden uitgevoerd, resultaten worden gecontroleerd en problemen worden opgelost in plaats van een gesoleerde functie te schrijven. In de praktijk zou dit moeten betekenen dat er minder sessies vastlopen waarbij het model de draad kwijtraakt over wat het al heeft geprobeerd, en meer betrouwbaar gedrag gedurende een coderingssessie die planning, schrijven, testen en debuggen omvat.
Complexe documenten analyseren
Met een contextvenster van 1 miljoen tokens en een outputcapaciteit van 128.000 tokens is Fable 5.1 gebouwd om grote hoeveelheden bronmateriaal, verschillende lange rapporten of uitgebreide contracten te verwerken en een werkelijk lange, gestructureerde output te produceren, in plaats van een korte samenvatting waarbij details verloren gaan. Voor onderzoeksintensief werk is die combinatie van grote input en grote output een betekenisvollere specificatie dan welke individuele benchmarkscore dan ook.
Claude Fable 5.1-functies die u moet kennen
Verbeterd redeneren. De benchmarkwinsten van Fable 5.1 op het gebied van kenniswerk suggereren een re→le verbetering in het afhandelen van problemen die het verbinden van verschillende stukjes informatie vereisen, in plaats van het beantwoorden van een enkele, gesoleerde vraag.
Beter coderingsvermogen. De sprong op Terminal Bench 4.0 is hier het duidelijkste signaal, en het sluit aan bij de verklaarde focus van Anthropic op langdurige agentische codering.
Begrip van lange context. Een venster van 1 miljoen tokens betekent dat u kunt werken met volledige codebases, lange documenten of uitgebreid onderzoeksmateriaal in ←←n sessie.
Verbeterde AI-agent workflows. De b│tafunctie die leesbare voortgangsupdates toont tussen tool-aanroepen, plus de aanpassing van de inspanning halverwege het gesprek, wijzen beide op een model dat gebouwd is om te worden gestuurd en gemonitord tijdens lange geautomatiseerde taken, en niet alleen om ←←n keer te worden aangestuurd.
Betere effici→ntie. De prijsverlaging van ongeveer 75 procent voor cache-leesacties is de meest concrete effici→ntiewinst, wat bijzonder waardevol is voor iedereen die herhaalde zoekopdrachten uitvoert tegen dezelfde grote context, zoals een document dat u aan de hand van vele vragen analyseert.
Claude Fable 5.1 vs GPT 5.6 vs Gemini
OpenAI bracht in juli 2026 de GPT 5.6-familie uit, bestaande uit Sol, Terra en Luna, waarbij Sol werd gepositioneerd als het vlaggenschip voor codering, kenniswerk en cybersecurity, met Terra als een gebalanceerde optie in het middensegment en Luna als het budgetmodel. De Gemini-lijn van Google is op een vergelijkbaar terrein blijven concurreren met eigen releases die gericht zijn op redeneren en lange context.
Er is geen onafhankelijk geverifieerde benchmark die Fable 5.1, GPT 5.6 Sol en het nieuwste Gemini-model onder identieke omstandigheden direct met elkaar vergelijkt. Elke specifieke numerieke vergelijking die beweert dat het ene model het andere met een exact percentage verslaat, moet dus met voorzichtigheid worden behandeld, inclusief cijfers die door de bedrijven zelf over hun eigen modellen zijn gepubliceerd.
Wat met redelijke zekerheid kan worden gezegd, gebaseerd op wat elk bedrijf over zijn eigen model heeft gepubliceerd:
- Voor ontwikkelaars zijn zowel Fable 5.1 als GPT 5.6 Sol expliciet gebouwd rond langdurige, meerstaps coderingsopdrachten in plaats van het genereren van enkele functies, en beide bedrijven rapporteren grote winst ten opzichte van hun vorige generatie op coderingsintensieve benchmarks. De keuze tussen beide zal waarschijnlijk meer afhangen van uw bestaande tooling en hoe elk model omgaat met uw specifieke codebase, dan van een enkele benchmarkscore.
- Voor schrijvers zijn het grotere contextvenster van Fable 5.1 en de aanpasbare inspanningsinstelling nuttig voor lange, onderzoeksintensieve content, hoewel de schrijfkwaliteit oprecht subjectief is en het de moeite waard is om deze direct te testen tegen uw eigen stijlgids in plaats van te vertrouwen op een beoordeling, inclusief deze.
- Voor algemene gebruikers bieden alle drie de bedrijven nu een goedkoper niveau aan dat gericht is op alledaagse vragen. Dus als u voornamelijk korte vragen stelt in plaats van lange agentische taken uit te voeren, wegen de praktische verschillen tussen de topmodellen minder zwaar dan de prijs en het gemak van de interface.
Hoe u Claude Fable 5.1 gratis kunt gebruiken op ChatGoat AI
Als u geen directe API-toegang nodig heeft, hoeft u geen facturering in te stellen, API-sleutels te beheren of code te schrijven om Fable 5.1 te proberen. Chatplatforms zoals ChatGoat AI geven u toegang tot Claude-modellen, inclusief Fable 5.1, via een normale browserinterface.
Stap 1: Open ChatGoat AI
Ga in uw browser naar de website van ChatGoat AI. Er is geen lokale installatie vereist.
Stap 2: Selecteer Claude Fable 5.1 uit de beschikbare AI-modellen
Kies Fable 5.1 uit de modellijst voordat u uw gesprek begint, aangezien verschillende taken om verschillende modellen kunnen vragen, afhankelijk van de kosten en complexiteit.
Stap 3: Voer uw prompt in en begin met chatten
Typ uw verzoek op dezelfde manier als in elke andere chatinterface en het model reageert direct, waarbij uw gesprekgeschiedenis bewaard blijft voor vervolgvragen.
Het belangrijkste voordeel van deze aanpak is dat de drempel voor configuratie wegvalt. Er is geen API-configuratie, u hoeft het tokengebruik niet handmatig bij te houden en er is geen afzonderlijk ontwikkelaarsaccount vereist, wat het een redelijk startpunt maakt voor schrijven, hulp bij coderen en dagelijkse onderzoekstaken.
Voorbeeld schrijfprompt:
"Maak een SEO-geoptimaliseerde artikelschets over AI-productiviteitstools. Vermeld de doelzoekwoorden, de kopstructuur en de veelgestelde vragen."
Voorbeeld coderingsprompt:
"Bouw een React-dashboard met gebruikersauthenticatie en leg het ontwikkelingsproces stap voor stap uit."
Voorbeeld onderzoeksprompt:
"Analyseer dit document en vat de belangrijke bevindingen samen, georganiseerd per onderwerp."
Beste gebruikssituaties voor Claude Fable 5.1
Voor ontwikkelaars is Fable 5.1 het meest geschikt voor lange coderingssessies met debuggen, refactoring en projecten met meerdere bestanden waarbij het model de context over vele stappen moet vasthouden.
Voor SEO-schrijvers zijn de grotere context en de mogelijkheid om in meerdere rondes te bewerken ideaal voor lange content, content-audits waarbij naar verschillende bestaande pagina's tegelijk wordt verwezen, en briefings die zoekwoordenonderzoek combineren met richtlijnen voor de merkstem.
Voor studenten is het vermogen van het model om documenten te verwerken nuttig voor het samenvatten van lange teksten, het uitwerken van opdrachten die meerdere stappen vereisen en het krijgen van duidelijke uitleg in stappen.
Voor zakelijke teams suggereren de verbeteringen op AutomationBench een re→le bruikbaarheid voor repetitieve workflowtaken, zoals het verwerken van gestructureerde gegevens, het opstellen van standaarddocumenten of het afhandelen van meerstaps goedkeuringslogica.
Voor al deze groepen is de rol van ChatGoat AI simpelweg het wegnemen van de moeite om te wisselen tussen platforms of het beheren van afzonderlijke API-accounts voor verschillende taken, zodat u kunt schakelen tussen schrijf-, coderings- en onderzoekswerk met hetzelfde model en dezelfde interface.
Prijzen en beschikbaarheid van Claude Fable 5.1
Fable 5.1 heeft dezelfde tarieven voor input- en outputtokens als Fable 5, dus er is geen directe prijsverhoging voor standaardgebruik. De belangrijkste prijswijziging zit in de cache-leesacties, die ongeveer 75 procent goedkoper zijn. Dit is een detail waar vooral ontwikkelaars en bedrijven van profiteren die grote volumes of herhaalde context-werklasten via de API uitvoeren.
Directe API-toegang is zinvol als u een applicatie bouwt, programmatische controle nodig hebt of grote volumes geautomatiseerde taken uitvoert waarbij kosteneffici→ntie per token op schaal van belang is. Voor incidenteel of gemiddeld gebruik, met name voor schrijven, onderzoek en dagelijkse coderingsvragen, is een chatplatform zoals ChatGoat AI een eenvoudigere en vaak gratis of goedkope manier om hetzelfde model te ervaren zonder de API-facturering rechtstreeks te hoeven beheren.
Is Claude Fable 5.1 de upgrade waard?
Wie zou moeten upgraden:
- Ontwikkelaars die lange, meerstaps coderingssessies uitvoeren waarbij Fable 5 voorheen de context verloor of halverwege een taak vastliep.
- Onderzoekers die met grote brondocumenten werken en het uitgebreide contextvenster nodig hebben.
- Contentcreators die lange projecten met meerdere concepten beheren die profiteren van de grotere context en de aanpasbare inspanningsinstelling.
- Bedrijven die repetitieve workflows automatiseren, gezien de gerapporteerde verbetering op AutomationBench.
Wie de upgrade misschien niet nodig heeft:
Gebruikers die voornamelijk eenvoudige vragen in ←←n beurt stellen, snelle feiten, korte uitleg of eenvoudige tekstcorrectie nodig hebben, zullen waarschijnlijk geen significant verschil merken tussen Fable 5 and Fable 5.1. De grootste gerapporteerde verbeteringen zitten namelijk specifiek in de prestaties bij lange, meerstaps taken in plaats van de kwaliteit van korte antwoorden.
Gebruikersmeningen en feedback van de community
De vroege discussie rond deze release concentreert zich meestal op een paar consistente thema's in plaats van ←←n enkel oordeel.
Wat gebruikers waarderen. De prijsverlaging voor cache-leesacties krijgt duidelijke bijval van ontwikkelaars die sessies met grotere of herhaalde context uitvoeren, omdat het de kosten van precies het soort lange context-werk waar Fable 5.1 voor bedoeld is, rechtstreeks verlaagt. De functie voor het aanpassen van de inspanning halverwege het gesprek wordt ook over het algemeen verwelkomd, omdat het niet meer nodig is om een sessie opnieuw te starten om te veranderen hoe hard het model aan een bepaalde stap werkt.
Veelvoorkomende zorgen. Een deel van de discussie rond deze release richt zich minder op Fable 5.1 zelf en meer op het bredere patroon van snelle modelreleases in de hele industrie. Gebruikers vragen zich af of een nieuw vlaggenschip om de paar maanden het moeilijker maakt om echte verbeteringen te evalueren ten opzichte van incrementele marketing. Er is ook een voortdurende discussie over de watermerkfunctie voor de herkomst van inhoud, waarbij sommige gebruikers transparantiemaatregelen ondersteunen en anderen onzeker zijn over hoe de toegang tot detectie in de toekomst zal worden beheerd.
Re→le verwachtingen. Het algemene gevoel is dat Fable 5.1 wordt gezien als een solide, praktische update in plaats van een dramatische sprong voorwaarts. Het model is bijzonder sterk voor codering en agentische workflows, met een bescheidener effect voor gebruikers die Claude voornamelijk gebruiken voor eenvoudige gesprekstaken.
Veelgestelde vragen
Wat is Claude Fable 5.1?
Claude Fable 5.1 is het vlaggenschipmodel van Anthropic voor codering, onderzoek en kenniswerk, uitgebracht op 1 september 2026 als een update van Claude Fable 5, met sterkere langdurige agentische vermogens en een groter contextvenster.
Is Claude Fable 5.1 beter dan Claude Fable 5?
Voor lange, meerstaps taken zoals coderingsprojecten, automatisering van zakelijke workflows en onderzoek met veel documenten laat Fable 5.1 aanzienlijk hogere gerapporteerde benchmarkscores zien dan Fable 5. Voor korte, eenvoudige vragen is het verschil veel minder merkbaar.
Wat is Claude Mythos 5.1?
Claude Mythos 5.1 is hetzelfde onderliggende model als Fable 5.1, maar met een andere veiligheidsconfiguratie. Het is alleen beschikbaar voor doorgelichte cybersecurity- en biowetenschapsorganisaties via het Project Glasswing-programma van Anthropic.
Hoe kan ik Claude Fable 5.1 online gebruiken?
U kunt er toegang toe krijgen via Anthropic's eigen Claude-producten, via de Claude API, of via chatplatforms van derden, zoals ChatGoat AI, die browsergebaseerde toegang bieden zonder dat een API-configuratie vereist is.
Kan ik Claude Fable 5.1 gebruiken zonder API-toegang?
Ja. Via chatplatforms zoals ChatGoat AI kunt u Fable 5.1 selecteren en direct beginnen met chatten, zonder API-sleutels of facturering te hoeven configureren.
Is Claude Fable 5.1 gratis?
Directe API-toegang is betaald, op basis van tokengebruik. Sommige chatplatforms bieden gratis of goedkope toegang tot Fable 5.1 via hun eigen abonnementen, wat vaak de eenvoudigste manier is om het model te proberen voordat u een directe API-integratie overweegt.