Wichtigste Erkenntnisse
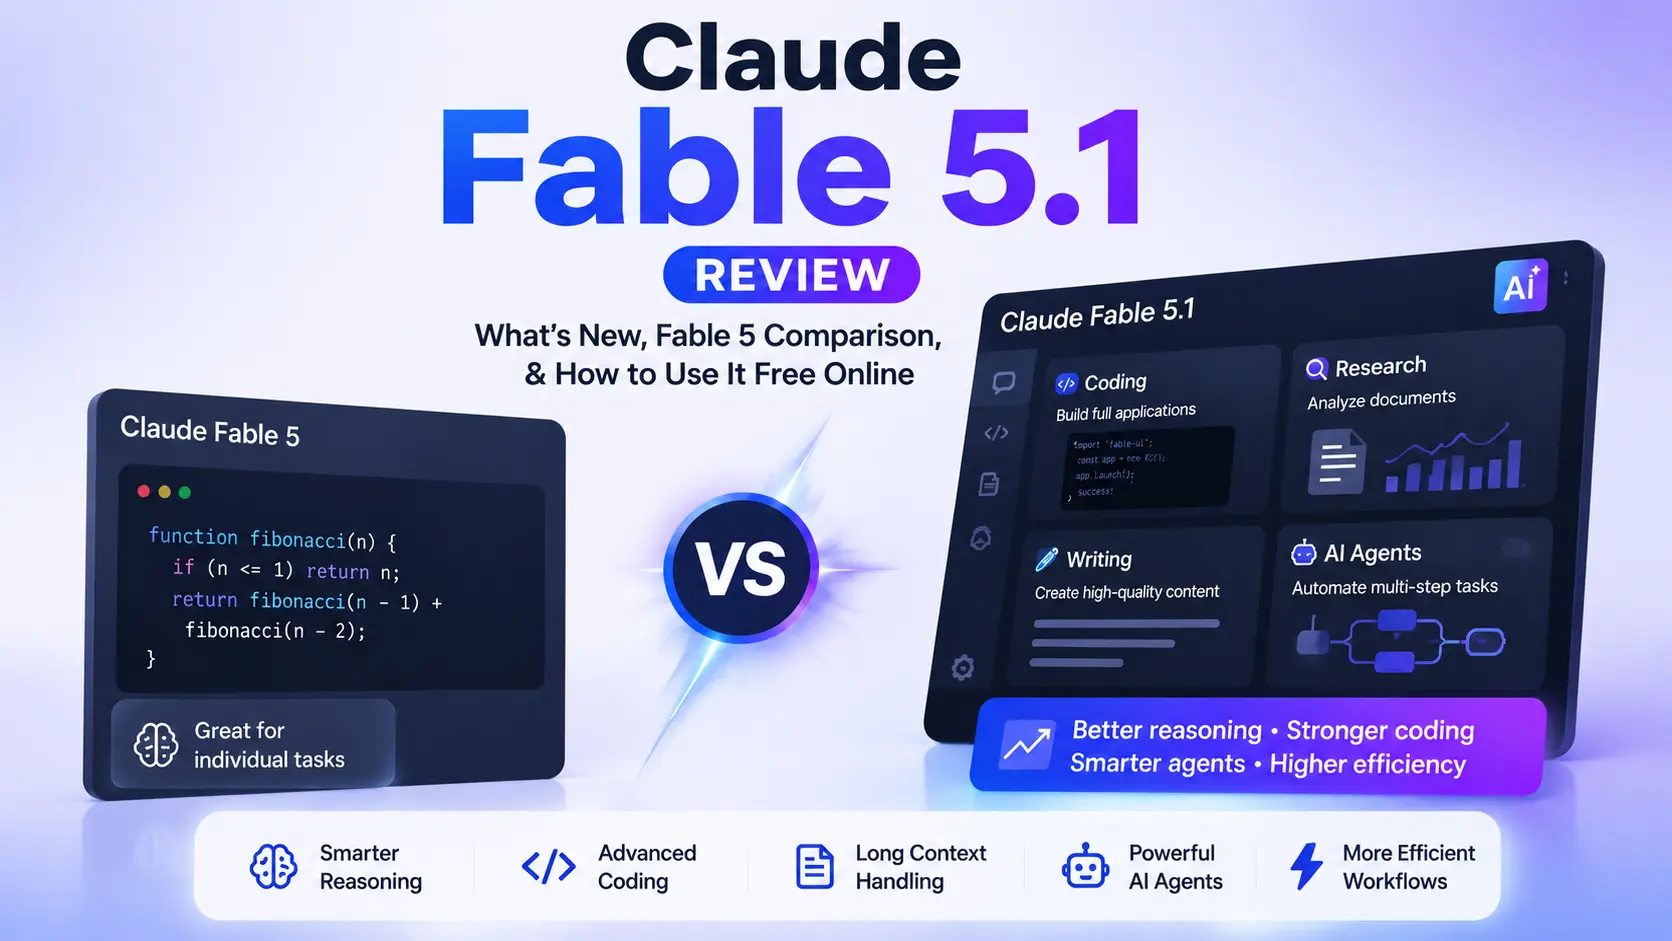
- Claude Fable 5.1 erweitert Claude Fable 5 um ein stärkeres, langfristiges agentenbasiertes Coding, mehrstufige Recherche sowie die Handhabung von Dokumenten, Tabellenkalkulationen und Präsentationen – zu den gleichen Token-Preisen für Input und Output.
- Cache-Lesevorgänge sind etwa 75 Prozent günstiger als zuvor, was vor allem für Entwickler wichtig ist, die wiederholte Sitzungen oder Sitzungen mit langem Kontext ausführen.
- Claude Mythos 5.1 basiert auf demselben Modell wie Fable 5.1, ist jedoch nur auf Einladung über Project Glasswing verfügbar und für Arbeiten in den Bereichen Cybersicherheit und Biowissenschaften konzipiert, die weniger Produktionseinschränkungen erfordern.
- Die gemeldeten Benchmark-Zuwächse gegenüber Fable 5 sind am größten bei Coding-Aufgaben und Geschäfts-Workflows, nicht nur bei geringfügigen Verbesserungen des logischen Denkens.
- Sie können Claude Fable 5.1 ohne API-Einrichtung über Chat-Plattformen wie ChatGoat AI ausprobieren.
Was ist Claude Fable 5.1?
Claude Fable 5.1 ist das derzeitige Top-Modell von Anthropic für Coding, Recherche und Wissensarbeit. Es steht in der Produktpalette über Claude Opus 5 für die schwierigsten Aufgaben. Anthropic empfiehlt selbst, dass die meisten Nutzer für den täglichen Gebrauch weiterhin mit Opus 5 beginnen sollten und erst dann zu Fable 5.1 greifen sollten, wenn eine Aufgabe anspruchsvolles logisches Denken, eine lange Abfolge von Schritten erfordert oder wenn Opus 5 selbst bei höheren Aufwandseinstellungen an seine Grenzen stößt.
Diese Einordnung ist wichtig, da sie zeigt, für wen Fable 5.1 wirklich konzipiert wurde.
Entwickler – Das Modell ist für langlaufende, agentenbasierte Coding-Sitzungen ausgelegt. Das bedeutet Aufgaben, bei denen es planen, Code schreiben, testen, Fehler bemerken und über viele Schritte hinweg Anpassungen vornehmen muss, anstatt nur einen Codeblock zu erstellen und dann aufzuhören. Zudem wird eine Beta-Funktion eingeführt, die lesbare Fortschrittsmeldungen anzeigt, während das Modell Tool-Aufrufe abarbeitet, damit man während einer langen Aufgabe nicht auf einen leeren Bildschirm starrt.
Content-Ersteller – Für SEO- und Marketingarbeit liegt der praktische Nutzen in mehrstufigen Content-Projekten, rechercheintensiven Beiträgen, die Informationen aus verschiedenen Quellen zusammenführen müssen, und Bearbeitungsphasen, bei denen das Modell viel Kontext über die Markenstimme und frühere Entwürfe behalten muss, ohne frühere Anweisungen aus den Augen zu verlieren.
Forscher – Mit einem Kontextfenster von 1 Million Token kann Fable 5.1 riesige Mengen an Quellmaterial – also lange Berichte, mehrere wissenschaftliche Arbeiten oder umfangreiche Transkripte – in einer einzigen Konversation verarbeiten, ohne Informationen ständig zusammenfassen und neu einspeisen zu müssen.
Unternehmen – Der klarste geschäftsrelevante Wert, den Anthropic veröffentlicht hat, stammt von AutomationBench, einem Benchmark für Geschäfts-Workflows. Hier schnitt Fable 5.1 deutlich besser ab als Fable 5 und Opus 5. Das deutet auf eine stärkere Leistung bei repetitiven, regelbasierten Arbeiten hin, die Unternehmen automatisieren möchten.
Claude Mythos 5.1 erklärt: Was macht den Unterschied?
Claude Mythos 5.1 ist kein eigenständiges Modell in der Art, wie Fable 5.1 und Opus 5 eigenständig sind. Anthropic hat bestätigt, dass Fable 5.1 und Mythos 5.1 exakt auf demselben Modell basieren. Der Unterschied liegt im Zugang und in der Sicherheitskonfiguration, mit der es umgeben ist.
Mythos 5.1 ist nur für Organisationen verfügbar, die in das Project Glasswing aufgenommen wurden. Dabei handelt es sich in der Regel um Cybersicherheitsfirmen und Forschungsgruppen aus den Biowissenschaften, die einen legitimen Bedarf an Funktionen haben, die Anthropic in der allgemeinen Version einschränkt. Tests von Anthropic ergaben, dass die chemischen und biologischen Fähigkeiten von Mythos 5.1 höher sind als bei Mythos 5, aber immer noch unter der nächsten Risikostufe der „Responsible Scaling Policy“ liegen. Die Cybersicherheitsfähigkeiten unter gelockerten Schutzmaßnahmen sind die höchsten, die bisher bei den veröffentlichten Modellen von Anthropic gemessen wurden, befinden sich jedoch weiterhin in der niedrigeren Risikokategorie des „Frontier Compliance Framework“ von Anthropic.
Für fast alle Leser dieses Artikels ist Mythos 5.1 nichts, was benötigt wird oder für das man sich anmelden kann. Wenn Sie nicht Teil eines geprüften Programms für Cybersicherheit oder Biowissenschaften sind, das direkt mit Anthropic, AWS oder Google Cloud zusammenarbeitet, bietet Ihnen Fable 5.1 die gleiche grundlegende Intelligenz mit den standardmäßigen Sicherheitsvorkehrungen.
| Vergleichspunkt | Claude Fable 5.1 | Claude Mythos 5.1 |
|---|---|---|
| Zielgruppe | Entwickler, Autoren, Forscher, allgemeine Unternehmen | Geprüfte Cybersicherheits- und Biowissenschaftsorganisationen |
| Verfügbarkeit | Allgemein verfügbar über Claude API und Cloud-Plattformen | Nur auf Einladung über Project Glasswing |
| Hauptzweck | Allgemeines Programmieren, Recherche und Wissensarbeit | Sensible Cyber- und Biologieforschung mit weniger Einschränkungen |
| Beste Anwendungsfälle | SEO-Inhalte, Coding-Projekte, Dokumentenanalyse, Agenten | Schwachstellenforschung, Biosicherheitsarbeit, defensive Cyber-Aufgaben |
Claude Fable 5.1 vs. Claude Fable 5: Was hat sich geändert?
Dies ist der Vergleich, den die meisten Leser tatsächlich suchen. Daher lohnt es sich, genau zu betrachten, was Anthropic veröffentlicht hat, anstatt zu spekulieren.
| Kategorie | Claude Fable 5 | Claude Fable 5.1 |
|---|---|---|
| Coding (Terminal Bench 4.0) | 42,0 Prozent | 55,8 Prozent |
| Wissensarbeit (GDPval AA v2) | 1.723 | 1.853 |
| Geschäfts-Workflows (AutomationBench) | 17,1 Prozent | 31,4 Prozent |
| Kontextfenster | Großer Kontext unterstützt | 1 Million Token |
| Ausgabekapazität | Standard-Ausgabelimits | Bis zu 128.000 Token pro Antwort |
| Preise für Cache-Reads | Standardtarif | Etwa 75 Prozent günstiger |
| Aufwandskontrolle | Festgelegt pro Konversation | Während der Konversation anpassbar (Beta) |
| Herkunft von Inhalten | Nicht enthalten | Integriertes Wasserzeichen für KI-generierten Text |
Einige dieser Zahlen bedürfen einer Einordnung. Anthropic hat klargestellt, dass dies vom Anbieter gemeldete Werte sind, keine unabhängig verifizierten Rankings. Betrachten Sie sie daher eher als Richtungsweiser dafür, wo sich das Modell am meisten verbessert hat, und nicht als absolute Wahrheit. Dennoch ist der Sprung bei Terminal Bench und AutomationBench groß genug, dass er wahrscheinlich eine echte Veränderung in der Art und Weise widerspiegelt, wie das Modell mehrstufige Aufgaben bewältigt, und nicht nur Rauschen zwischen Benchmark-Läufen ist.
Was werden Fable 5-Nutzer nach dem Wechsel zu Fable 5.1 tatsächlich bemerken? Die praktischste Veränderung betrifft die Planung und Umsetzung. Fable 5 war bereits bei Einzelaufgaben kompetent, also wenn man ihm einen klaren Auftrag gab und es diesen gut ausführte. Fable 5.1 ist stärker für mehrstufige Projekte ausgelegt, die Planung, Durchführung, Überprüfung der Ergebnisse und Verbesserungen in einem zweiten oder dritten Durchgang erfordern, ohne dass man den Kontext jedes Mal neu formulieren muss. Wenn Ihr SEO-Workflow vorsieht, das Modell einmal zu instruieren und es dann einen Artikel über mehrere Runden hinweg entwerfen, selbst prüfen und verfeinern zu lassen, sollte sich das Upgrade hier am deutlichsten bemerkbar machen.
Es gibt auch drei wesentliche Änderungen („Breaking Changes“), die wichtig sind, wenn Sie oder Ihr Team die API direkt aufrufen: Erzwungene Tool-Nutzung gibt jetzt einen Fehler zurück, anstatt stillschweigend ignoriert zu werden; frühere Claude-Modelle können die internen Denkblöcke von Fable 5.1 nicht lesen; und das Bearbeiten eines früheren Beitrags in einer Konversation macht diese Denkblöcke ungültig. Nichts davon betrifft die normale Chat-Nutzung, aber es ist wichtig, wenn Sie automatisierte Workflows auf Basis von Fable 5 erstellt haben.
Claude Fable 5.1 Leistungsbericht und Praxistests
Anstatt fiktive Benchmark-Läufe als kontrollierte Tests zu präsentieren, zeigt das Folgende, was die tatsächlichen Designänderungen des Modells basierend auf den von Anthropic veröffentlichten Fähigkeiten für drei gängige Anwendungsfälle bedeuten.
Einen langen SEO-Artikel schreiben
Bei einem Langform-Beitrag profitieren vor allem die Outline-Planung und die mehrstufige Bearbeitung von den Änderungen in Fable 5.1. Da das Modell weitaus mehr Kontext gleichzeitig erfassen kann, behält es das gesamte Content-Briefing, Notizen zu Wettbewerbern und Ziel-Keywords im Blick, ohne mitten im Entwurf den Faden zu verlieren. Die anpassbare Aufwandseinstellung ermöglicht es zudem, eine schnelle erste Outline mit geringerem Aufwand anzufordern und dann für das eigentliche Schreiben und Editieren innerhalb derselben Konversation die Aufwandsebene zu erhöhen.
Eine Webanwendung programmieren
Dies ist der Bereich, in dem die Benchmark-Zahlen von Anthropic am deutlichsten auf Verbesserungen hinweisen. Ein stärkeres Ergebnis beim Terminal Bench deutet auf eine bessere Leistung bei realistischen, mehrstufigen Coding-Aufgaben hin, bei denen Befehle ausgeführt, Ergebnisse geprüft und Probleme behoben werden müssen, anstatt nur eine isolierte Funktion zu schreiben. In der Praxis sollte dies weniger festgefahrene Sitzungen bedeuten, in denen das Modell den Überblick darüber verliert, was es bereits versucht hat, sowie ein zuverlässigeres Verhalten über eine Coding-Session hinweg, die Planung, Schreiben, Testen und Debuggen umfasst.
Komplexe Dokumente analysieren
Mit einem Kontextfenster von 1 Million Token und einer Ausgabekapazität von 128.000 Token ist Fable 5.1 dafür ausgelegt, umfangreiches Quellmaterial, mehrere lange Berichte oder umfassende Verträge aufzunehmen und daraufhin eine wirklich lange, strukturierte Antwort zu liefern, anstatt einer kurzen Zusammenfassung, die Details weglässt. Für rechercheintensive Arbeiten ist diese Kombination aus großem Input und großem Output ein bedeutenderer Wert als jeder einzelne Benchmark-Score.
Funktionen von Claude Fable 5.1, die Sie kennen sollten
Verbessertes logisches Denken. Die Benchmark-Zuwächse von Fable 5.1 bei Wissensaufgaben deuten auf eine echte Verbesserung bei der Bewältigung von Problemen hin, die das Verknüpfen mehrerer Informationen erfordern, anstatt nur eine einzelne, isolierte Frage zu beantworten.
Bessere Programmierfähigkeiten. Der Sprung beim Terminal Bench 4.0 ist hier das klarste Signal und deckt sich mit Anthropics Fokus auf langlaufendes agentenbasiertes Coding.
Verständnis langer Kontexte. Ein Fenster von 1 Million Token bedeutet, dass Sie mit ganzen Codebasen, langen Dokumenten oder umfangreichem Recherchematerial in einer einzigen Sitzung arbeiten können.
Verbesserte KI-Agenten-Workflows. Die Beta-Funktion, die lesbare Fortschritts-Updates zwischen Tool-Aufrufen anzeigt, sowie die Anpassung des Aufwands mitten in der Konversation deuten auf ein Modell hin, das darauf ausgelegt ist, während langer automatisierter Aufgaben gesteuert und überwacht zu werden, anstatt nur einmal angewiesen zu werden.
Höhere Effizienz. Die Reduzierung der Preise für Cache-Lesevorgänge um rund 75 Prozent ist der konkretste Effizienzgewinn, der besonders für alle wertvoll ist, die wiederholte Abfragen gegen denselben großen Kontext durchführen, wie zum Beispiel ein Dokument, das über viele Fragen hinweg analysiert wird.
Claude Fable 5.1 vs. GPT 5.6 vs. Gemini
OpenAI hat im Juli 2026 seine GPT 5.6-Familie veröffentlicht, bestehend aus Sol, Terra und Luna. Dabei wurde Sol als Flaggschiff für Coding, Wissensarbeit und Cybersicherheit positioniert, während Terra als ausgewogene Mittelklasse-Option und Luna als Budget-Modell dient. Googles Gemini-Linie konkurriert weiterhin auf ähnlichem Terrain mit eigenen Veröffentlichungen, die auf logisches Denken und langen Kontext fokussiert sind.
Es gibt keinen unabhängig verifizierten 1-zu-1-Benchmark, der Fable 5.1, GPT 5.6 Sol und das neueste Gemini-Modell unter identischen Bedingungen direkt vergleicht. Daher sollten alle spezifischen numerischen Vergleiche, die behaupten, ein Modell schlage ein anderes um einen exakten Prozentsatz, mit Vorsicht genossen werden – dies gilt auch für Zahlen, die die Unternehmen selbst über ihre eigenen Modelle veröffentlichen.
Was sich mit angemessener Zuversicht sagen lässt, basierend auf den Veröffentlichungen der Unternehmen über ihre Modelle:
- Für Entwickler sind sowohl Fable 5.1 als auch GPT 5.6 Sol explizit auf langlaufende, mehrstufige Coding-Aufgaben anstatt auf die Generierung einzelner Funktionen ausgelegt. Beide Unternehmen berichten von großen Fortschritten gegenüber ihrer Vorgängergeneration in coding-intensiven Benchmarks. Die Wahl wird wahrscheinlich eher von Ihren bestehenden Tools und der Art abhängen, wie jedes Modell Ihre spezifische Codebasis handhabt, als von einem einzelnen Benchmark-Wert.
- Für Autoren sind das größere Kontextfenster von Fable 5.1 und die anpassbare Aufwandseinstellung nützlich für umfangreiche, rechercheintensive Inhalte. Die Schreibqualität ist jedoch sehr subjektiv und sollte direkt anhand Ihres eigenen Styleguides getestet werden, anstatt sich auf eine Rezension zu verlassen – auch auf diese hier.
- Für allgemeine Nutzer bieten mittlerweile alle drei Unternehmen eine kostengünstigere Stufe für Alltagsfragen an. Wenn Sie also hauptsächlich kurze Fragen stellen, anstatt lange agentenbasierte Aufgaben auszuführen, fallen die praktischen Unterschiede zwischen den Top-Modellen weniger ins Gewicht als der Preis und der Komfort der Benutzeroberfläche.
So nutzen Sie Claude Fable 5.1 kostenlos auf ChatGoat AI
Wenn Sie keinen direkten API-Zugang benötigen, müssen Sie keine Abrechnung einrichten, keine API-Schlüssel verwalten oder Code schreiben, um Fable 5.1 auszuprobieren. Chat-basierte Plattformen wie ChatGoat AI bieten Ihnen Zugriff auf Claude-Modelle, einschließlich Fable 5.1, über eine normale Browser-Oberfläche.
Schritt 1: ChatGoat AI öffnen
Besuchen Sie die ChatGoat AI-Website in Ihrem Browser. Es ist keine lokale Installation erforderlich.
Schritt 2: Claude Fable 5.1 aus den verfügbaren KI-Modellen auswählen
Wählen Sie Fable 5.1 aus der Modellliste aus, bevor Sie Ihre Konversation beginnen, da verschiedene Aufgaben je nach Kosten und Komplexität unterschiedliche Modelle erfordern können.
Schritt 3: Prompt eingeben und chatten
Geben Sie Ihre Anfrage so ein, wie Sie es in jeder anderen Chat-Oberfläche tun würden. Das Modell antwortet direkt, und Ihr Konversationsverlauf bleibt für Folgefragen erhalten.
Der Hauptvorteil dieses Ansatzes besteht darin, dass die Hürden bei der Einrichtung entfallen. Es gibt keine API-Konfiguration, keine Notwendigkeit, den Token-Verbrauch manuell zu überwachen, und kein separates Entwicklerkonto. Dies macht es zu einem idealen Ausgangspunkt für das Schreiben, Hilfe beim Programmieren und tägliche Rechercheaufgaben.
Beispiel für einen Schreib-Prompt:
"Erstelle eine SEO-optimierte Artikel-Gliederung über KI-Produktivitätstools. Beziehe Ziel-Keywords, die Überschriftenstruktur und FAQ-Fragen mit ein."
Beispiel für einen Coding-Prompt:
"Erstelle ein React-Dashboard mit Benutzerauthentifizierung und erkläre den Entwicklungsprozess Schritt für Schritt."
Beispiel für einen Recherche-Prompt:
"Analysiere dieses Dokument und fasse die wichtigen Erkenntnisse zusammen, geordnet nach Themen."
Beste Anwendungsfälle für Claude Fable 5.1
Für Entwickler: Fable 5.1 eignet sich am besten für lange Coding-Sitzungen mit Debugging, Refactoring und Projekten über mehrere Dateien hinweg, bei denen das Modell den Kontext über viele Schritte hinweg behalten muss.
Für SEO-Autoren: Der größere Kontext und die mehrstufige Bearbeitungsfähigkeit sind ideal für Langform-Inhalte, Content-Audits, die auf mehrere bestehende Seiten gleichzeitig Bezug nehmen, und Briefings, die Keyword-Recherche mit Markenstimmen-Richtlinien kombinieren.
Für Studenten: Die Fähigkeit des Modells zur Dokumentenhandhabung ist nützlich, um lange Texte zusammenzufassen, Aufgabenstellungen mit mehreren Schritten durchzuarbeiten und klare Erklärungen zu erhalten.
Für Unternehmensteams: Die Fortschritte bei AutomationBench deuten auf einen echten Nutzen für repetitive Workflow-Aufgaben hin, wie das Verarbeiten strukturierter Daten, das Erstellen von Standarddokumenten oder das Bearbeiten mehrstufiger Genehmigungslogiken.
In all diesen Gruppen besteht die Rolle von ChatGoat AI einfach darin, die Reibungsverluste beim Wechsel zwischen Plattformen oder bei der Verwaltung separater API-Konten für verschiedene Aufgaben zu beseitigen. So können Sie mit demselben Modell und derselben Benutzeroberfläche zwischen Schreib-, Coding- und Recherchearbeit wechseln.
Claude Fable 5.1 Preise und Verfügbarkeit
Fable 5.1 wird zu denselben Token-Preisen für Input und Output angeboten wie Fable 5, sodass es keine direkte Preiserhöhung für die Standardnutzung gibt. Die bedeutende Preisänderung betrifft die Cache-Lesevorgänge, die etwa 75 Prozent günstiger sind – ein Detail, das vor allem Entwicklern und Unternehmen zugutekommt, die hohe Volumina oder wiederholte Kontext-Workloads über die API ausführen.
Ein direkter API-Zugang ist sinnvoll, wenn Sie eine Anwendung entwickeln, programmatische Kontrolle benötigen oder automatisierte Aufgaben mit hohem Volumen ausführen, bei denen es auf Kosteneffizienz pro Token im großen Maßstab ankommt. Für gelegentliche oder moderate Nutzung, insbesondere beim Schreiben, Recherchieren und für alltägliche Coding-Fragen, ist eine Chat-Plattform wie ChatGoat AI eine einfachere und oft kostenlose oder kostengünstige Möglichkeit, dasselbe Modell zu erleben, ohne die API-Abrechnung direkt verwalten zu müssen.
Lohnt sich ein Upgrade auf Claude Fable 5.1?
Wer upgraden sollte:
- Entwickler, die lange, mehrstufige Coding-Sitzungen durchführen, bei denen Fable 5 zuvor den Kontext verloren hat oder mitten in einer Aufgabe stehen geblieben ist.
- Forscher, die mit umfangreichen Quelldokumenten arbeiten und das erweiterte Kontextfenster benötigen.
- Content-Ersteller, die Langform-Projekte mit mehreren Entwürfen verwalten und vom größeren Kontext sowie der anpassbaren Aufwandseinstellung profitieren.
- Unternehmen, die repetitive Workflows automatisieren, angesichts der gemeldeten Verbesserungen im AutomationBench.
Wer ein Upgrade eventuell nicht benötigt:
Nutzer, die hauptsächlich einfache Fragen stellen, kurze Fakten abfragen, kurze Erklärungen oder einfaches Korrekturlesen benötigen, werden wahrscheinlich keinen signifikanten Unterschied zwischen Fable 5 und Fable 5.1 bemerken, da die größten gemeldeten Zuwächse speziell bei langen, mehrstufigen Aufgaben und nicht bei der Qualität von Kurzantworten liegen.
Nutzermeinungen und Community-Feedback
Die frühen Diskussionen über diese Version konzentrieren sich eher auf einige konsistente Themen als auf ein einzelnes Urteil.
Was Nutzer schätzen. Die Preissenkung für Cache-Reads stößt auf deutliche Zustimmung bei Entwicklern, die Sitzungen mit großem oder wiederholtem Kontext ausführen, da sie direkt die Kosten für genau die Art von Langkontextarbeit senkt, für die Fable 5.1 gedacht ist. Die Funktion zur Aufwandskorrektur mitten in der Konversation wird ebenfalls allgemein begrüßt, da man eine Sitzung nicht mehr neu starten muss, nur um zu ändern, wie intensiv das Modell an einem bestimmten Schritt arbeitet.
Häufige Bedenken. Ein Teil der Diskussion konzentriert sich weniger auf Fable 5.1 selbst als vielmehr auf das allgemeine Muster schneller Modellveröffentlichungen in der gesamten Branche. Nutzer fragen sich, ob ein neues Flaggschiff alle paar Monate es schwieriger macht, echte Verbesserungen von inkrementellem Marketing zu unterscheiden. Zudem gibt es laufende Diskussionen über das Wasserzeichen-Feature zur Herkunft von Inhalten, wobei einige Nutzer Transparenzmaßnahmen unterstützen und andere unsicher sind, wie der Zugang zur Erkennung künftig verwaltet wird.
Reale Erwartungen. Der allgemeine Tenor ist, dass Fable 5.1 als ein solides, praktisches Update und nicht als dramatischer Sprung angesehen wird. Es ist besonders stark für Coding und agentenbasierte Workflows, hat aber geringere Auswirkungen für Nutzer, die Claude meist für einfache Konversationsaufgaben verwenden.
FAQ-Bereich
Was ist Claude Fable 5.1?
Claude Fable 5.1 ist das Flaggschiff-Modell von Anthropic für Coding, Recherche und Wissensarbeit. Es wurde am 1. September 2026 als Update für Claude Fable 5 veröffentlicht und bietet stärkere langfristige agentenbasierte Fähigkeiten sowie ein größeres Kontextfenster.
Ist Claude Fable 5.1 besser als Claude Fable 5?
Für lange, mehrstufige Aufgaben wie Coding-Projekte, die Automatisierung von Geschäfts-Workflows und dokumentenintensive Recherche zeigt Fable 5.1 deutlich höhere Benchmark-Ergebnisse als Fable 5. Bei kurzen, einfachen Fragen ist der Unterschied weitaus weniger spürbar.
Was ist Claude Mythos 5.1?
Claude Mythos 5.1 basiert auf demselben Modell wie Fable 5.1, verfügt jedoch über eine andere Sicherheitskonfiguration. Es ist ausschließlich für geprüfte Cybersicherheits- und Biowissenschaftsorganisationen über das Project Glasswing-Programm von Anthropic zugänglich.
Wie kann ich Claude Fable 5.1 online nutzen?
Sie können über die eigenen Claude-Produkte von Anthropic, über die Claude API oder über Chat-Plattformen von Drittanbietern wie ChatGoat AI darauf zugreifen, die einen browserbasierten Zugang ohne API-Einrichtung bieten.
Kann ich Claude Fable 5.1 ohne API-Zugang nutzen?
Ja. Chat-Plattformen wie ChatGoat AI ermöglichen es Ihnen, Fable 5.1 auszuwählen und direkt zu chatten, ohne API-Schlüssel oder Abrechnungen konfigurieren zu müssen.
Ist Claude Fable 5.1 kostenlos?
Der direkte API-Zugang ist kostenpflichtig und basiert auf der Token-Nutzung. Einige Chat-Plattformen bieten jedoch kostenlosen oder kostengünstigen Zugang zu Fable 5.1 über ihre eigenen Abonnements an, was oft der einfachste Weg ist, das Modell auszuprobieren, bevor man eine direkte API-Integration in Erwägung zieht.