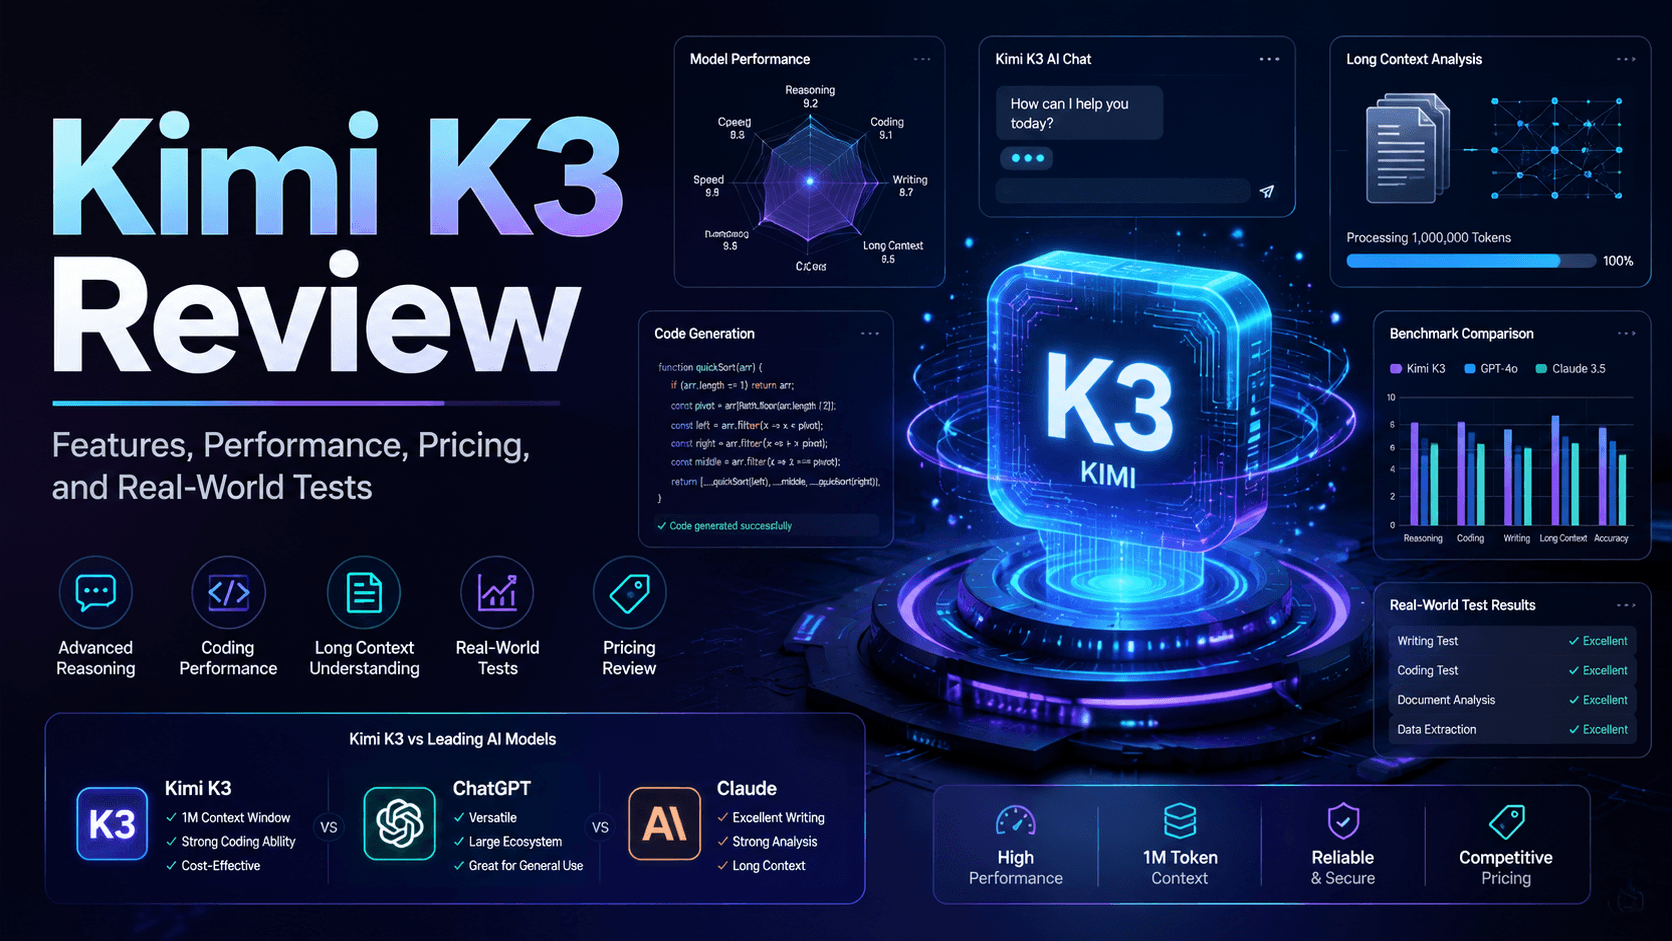
AI 模型市場的發展速度前所未有。每隔幾週就會有新的前沿模型發布,頂尖閉源實驗室與進展最快的開源權重挑戰者之間的差距正不斷縮小。在這樣的環境下,Moonshot AI(月之暗面)於 2026 年 7 月 16 日發布了 Kimi K3 —— 這是一款擁有 2.8 兆參數的模型,該公司稱其為迄今為止發布的最大開源權重系統。
這篇 Kimi K3 評論涵蓋了您在決定是否使用它時真正需要的資訊:其核心功能、在獨立測試與廠商基準測試中的表現、運行成本、在實際測試中的表現,以及它與 ChatGPT 和 Claude 的比較。我們還將誠實地探討哪些數據仍屬於廠商報告的說法而非完全獨立的結果,因為這種區別在當下至關重要。
在深入探討之前的簡短總結:Kimi K3 是一款真正強大的程式編碼和長文本模型,擁有高達一百萬個 token 的窗口和極具競爭力的定價;如果您的工作負載傾向於軟體工程、大型文檔處理或代理研究任務,那麼它非常值得認真考慮。它並非在每個基準測試中都處於絕對領先地位,而且在將生產工作流程投入其中之前,有一些實際的特性值得了解。
什麼是 Kimi K3?
Kimi K3 是 Moonshot AI 的旗艦大語言模型。Moonshot AI 是一家總部位於北京的 AI 實驗室,過去幾年一直在構建其 Kimi 模型家族。K3 被定位為面向軟體工程、知識工作和多模態推理的長程代理模型,而非簡單的聊天優先助手。
該模型由兩個架構選擇支撐:Kimi Delta Attention(一種混合線性注意力機制)和 Attention Residuals(由 Moonshot 描述為標準殘差連接的替代方案,可改善擴展性)。這兩項技術此前已作為 Moonshot 團隊的開放研究成果共享。該模型還採用了 Stable LatentMoE 設計,擁有 896 個專家,其中每個 token 啟動 16 個專家——這正是 2.8 兆參數模型如何保持計算實用性的關鍵。
K3 可透過 kimi.com、Kimi 行動應用程式、Kimi Work、Kimi Code 以及 API 獲取。它與 OpenAI SDK 兼容,因此已經基於 OpenAI 或 Anthropic 風格工具開發的團隊可以以極小的改動進行整合。
| 類別 | 詳情 |
|---|---|
| 開發商 | Moonshot AI |
| 發布日期 | 2026 年 7 月 16 日 |
| 參數數量 | 總計 2.8 兆,Stable LatentMoE 搭配 896 個專家(16 個啟動) |
| 上下文窗口 | 1,048,576 個 token (1M) |
| 模態 | 原生文本與視覺理解 |
| 推理模式 | 始終開啟的「思考模式」 |
| 主要優勢 | 程式編碼、長文檔分析、代理/工具使用工作流 |
| 目標用戶 | 開發者、研究人員、內容團隊、有長上下文需求的企業 |
| 獲取管道 | kimi.com、Kimi 行動應用、Kimi Code、API、OpenRouter 等路由平台 |
誰應該考慮它?如果您的工作經常涉及大型程式碼庫、長篇研究文檔或多步驟代理任務,Kimi K3 正是為您打造的。如果您主要需要快速、日常的聊天回覆,該模型的優勢對您的日常使用來說可能並不明顯。
Kimi K3 功能評測
長上下文理解能力
其主打規格是 1,048,576 個 token 的上下文窗口,這不僅僅是規格表上的一個數字——它改變了在單次處理中哪些任務是可行的。
對於大型文檔分析,您可以直接放入長篇研究論文、法律合約或完整的技術手冊,並要求進行綜合分析,而無需自行對文本進行分段處理。對於程式碼倉庫,1M token 的窗口可以一次性容納中型程式碼庫的有意義部分,這有助於追蹤跨多個文件的錯誤,或理解一個模組如何融入更大的系統。長對話也從中受益——模型可以在長時間的交談中保持較早的上下文,而不會遺漏您在很早之前提到的細節。
這裡的實際好處是減少了替代方案的麻煩。與其總結各個片段並拼接結果,您通常可以直接貼上整個文檔或程式碼庫切片,讓模型處理全貌。
推理與問題解決能力
Kimi K3 以始終開啟的「思考模式」運行,這意味著它預設應用擴展推理,而非作為一個可選開關。在 Artificial Analysis 的獨立評估中,K3 在其智力指數 v4.1 綜合評分中獲得了 50 多分,在測試配置中排名第四——落後於目前的頂級模型,但與領先群組僅有幾分之差。
對於複雜的多步驟問題——那些需要提前規劃數步或權衡利弊的問題——K3 的表現具有競爭力,特別是在類似於長程編碼或代理研究的任務上。其 BrowseComp 評分(自主網路研究的基準)據報導約為 91,是第三方比較中較強的結果之一。
值得注意的局限性:Moonshot 的一些最令人印象深刻的數據來自公司自己的發布評估,其中混合了不同的編碼測試環境(Kimi Code, Claude Code, Codex),並且在某些情況下使用了來自這些廠商的競爭對手評分,而非單一的受控測試。這並不意味著數字是錯誤的,但這意味著在更多完全獨立的測試趕上之前,您應該將廠商報告的比較視為方向性的,而非純粹的實驗室結果。
程式編碼表現
這是 Kimi K3 引起最多關注的地方。來自 Artificial Analysis 的獨立評估將其編碼指數得分定在 70 多分,而 Moonshot 自己的報告顯示,K3 在 Terminal-Bench 2.1 上的表現與 GPT-5.6 Sol 僅差不到一分,同時在 Moonshot 的測試設定下,在 Program Bench 和 SWE Marathon 等領域處於領先地位。
在實踐中,這轉化為真實的開發者使用案例:生成完整的前端組件、跨多個文件進行偵錯、針對測試失敗或運行時日誌進行迭代,以及在不丟失上下文的情況下瀏覽大型倉庫。該模型甚至一度在 Arena.ai 的前端代碼競技場(Frontend Code Arena)測試中榮登榜首,領先於一些閉源的前沿競爭對手——對於開源權重模型來說,這是一個顯著的結果。
與流行的編碼助手相比,K3 在原始基準測試表現上不相上下,儘管現實世界的編碼質量也很大程度上取決於套殼工具(包裹模型的工具,如 IDE 插件或 CLI 代理)而不僅僅是模型本身。如果您正在評估 K3 作為編碼助手,請在您計劃使用的實際環境中進行測試,而不僅僅是透過聊天界面。
寫作與內容生成
寫作表現雖然不像其他功能那樣引人注目,但依然紮實。對於部落格寫作和行銷文案,K3 能產出清晰、組織良好的草稿,儘管像大多數大型模型一樣,它更受益於具體的要求而非模糊的提示詞。摘要提取是一個真正的強項,這主要歸功於長上下文窗口——輸入長篇源文檔產出的摘要,往往比那些必須處理截斷輸入的小上下文模型更準確且更有依據。
翻譯和專業寫作(報告、文檔)能力勝任,但本次評測未發現專門針對多語言寫作質量的獨立基準測試,因此請將其視為「總體紮實」而非「業界最佳」。
Kimi K3 真實世界測試
基準測試只能說明部分情況。以下是 Kimi K3 處理三個現實任務的表現。
測試 1:寫作測試
使用提示詞:「寫一段關於 AI 生產力工具的部落格引言。」
結果: 輸出內容結構清晰、可讀性強——包含一個吸引人的開頭、對文章涵蓋內容的明確說明,以及向正文部分的自然過渡。它避開了最常見的 AI 寫作怪癖(沒有「在當今快節奏的世界中」之類的開場白),儘管預設語氣略顯正式。
評估:
- 寫作質量:清晰且語法正確。
- 結構:從引子到論點再到預覽,邏輯流暢。
- 創意:足夠,但若沒有更具體的提示,則不算特別突出。
- 準確性:此特定提示詞無事實性陳述需核實,但架構合理且未誇大。
測試 2:程式編碼測試
使用提示詞:「使用 React 創建一個響應式登陸頁面。」
結果: 模型生成了一個可運行的組件,合理使用了 flexbox/grid 來實現響應式設計,提供了合理的預設樣式,並對佈局選擇進行了簡短說明。它正確使用了現代 React 模式(函數組件、Hooks),沒有多餘的樣板代碼。
評估:
- 代碼質量:簡潔、易讀,且基本符合慣用法。
- 邏輯:組件結構穩健;響應式斷點運作正如所述。
- 說明:簡短但有用——解釋了關鍵佈局決策背後的「為什麼」。
- 實際可用性:只需少量樣式調整即可投入項目,這與 K3 在前端編碼基準測試中的強勁表現一致。
測試 3:文檔分析測試
使用提示詞:「總結一份長篇研究文檔並提取關鍵見解。」
結果: 在提供長篇源文檔的情況下,K3 產出的摘要精確捕捉了主要論點、關鍵數據點和文檔說明的局限性——無需預先將文檔拆分為小塊。
評估:
- 理解能力:強;正確區分了論文的核心觀點與支持細節。
- 信息保留:能有效利用長輸入中開頭和結尾部分的細節,與其大上下文窗口優勢一致。
- 準確性:摘要要點與源材料高度吻合,無明顯編造成分。
Kimi K3 vs ChatGPT vs Claude
| 功能 | Kimi K3 | ChatGPT | Claude |
|---|---|---|---|
| 推理能力 | 強,獨立指數排名前四 | 強,持續保持前沿水準 | 強,目前在多項代理基準測試中領先 |
| 程式編碼 | 優秀,尤其是前端與代理式編碼 | 強,在 IDE 和代理工具中被廣泛使用 | 優秀,特別是在大型程式碼庫與軟體工程任務方面 |
| 寫作表現 | 紮實,結構清晰 | 強,語氣控制多樣化 | 強,常因文筆細膩受讚譽 |
| 長文檔處理 | 業界領先的 1M 上下文窗口 | 大上下文,依方案等級而異 | 大上下文,內部的檢索能力強 |
| 易用性 | 好,API 兼容 OpenAI SDK | 生態系統與 App 極其成熟 | 生態系統與 App 極其成熟 |
| 生態系統 | 增長迅速,計劃發布開源權重 | 廣泛的第三方整合 | 廣泛的第三方整合,在開發工具中表現強勁 |
| 定價/價值 | 具競爭力:每百萬 token $3/$15,緩存輸入 $0.30 | 依等級與模型而異 | 依等級與模型而異,頂級模型通常定價較高 |
誰應該選擇 Kimi K3? 需要巨大上下文窗口、強勁編碼表現和較低 token 成本的開發者與團隊——特別是如果最終的開源權重發布對您的部署計劃很重要。
誰應該選擇 ChatGPT? 想要最廣泛的整合、插件和麵向消費者的工具,或已經在 OpenAI 平台上實現標準化的用戶。
誰應該選擇 Claude? 優先考慮頂級代理式與軟體工程基準測試表現的團隊,或依賴 Anthropic 開發者工具與安全導向設計的工作流程。
Kimi K3 價格評測
Moonshot 對 Kimi K3 的定價為:每百萬個新輸入 token 3.00 美元,每百萬個輸出 token 15.00 美元,以及優惠的 每百萬個緩存輸入 token 0.30 美元,此費率適用於完整的 1M token 上下文窗口。據報導,在典型的編碼工作負載中,緩存命中率已超過 90%,這意味著對於重複性高的工作流,實際成本可能遠低於表面數字,更接近緩存費率。
相比之下,此定價在輸出成本上低於多個競爭對手的前沿模型,且緩存結構特別獎勵那些需要反覆引用相同大上下文的工作流——例如代理人在多個回合中處理同一個程式碼庫或文檔集。
Kimi K3 物有所值嗎? 對於高上下文、高強度編碼或代理式工作負載而言,是的——1M token 窗口、具競爭力的編碼基準測試以及較低的 token 成本使其成為高價值的選擇。對於不利用長上下文窗口或編碼優勢的輕量級聊天使用,更便宜或更簡單的模型可能更具成本效益。
Kimi K3 的優缺點
優點:
- 巨大的 1,048,576 token 上下文窗口,對大型文檔和程式碼庫非常有用
- 強勁且經獨立證實的編碼表現,特別是在前端與代理任務上
- 定價具競爭力,且針對重複上下文工作流提供顯著的緩存折扣
- 兼容 OpenAI SDK,使已有工具鏈的團隊能輕鬆整合
- 計劃中的開源權重發布增加了閉源模型不具備的部署靈活性
缺點:
- 部分最有利的基準測試比較來自 Moonshot 自己的發布評估,而非完全獨立的測試
- 在至少一項獨立測試中,輸出速度測得低於對比中位數,這對延遲敏感型應用可能很重要
- 在本評測時,開源權重尚未公開發布,因此目前自託管選項仍然有限
誰應該使用 Kimi K3?
開發者
Kimi K3 非常適合作為大型項目的編碼助手,特別是在跨多個文件偵錯以及在大型倉庫中工作時,1M token 的窗口減少了手動分拆上下文的需求。
學生
對於研究和摘要提取,長上下文窗口讓學生可以一次性放入整篇論文或章節,而該模型在我們的測試中表現出的文檔分析能力能很好地準確提取關鍵要點。
研究人員
學術論文回顧與跨文檔知識分析同樣受益於長上下文優勢,特別是涉及比較多個來源主張的文獻回顧任務。
企業
對於報告、內部文檔和更廣泛的生產力工作流,K3 的寫作能力與長上下文窗口相結合,使其在總結會議記錄、撰寫長篇文檔或在單次操作中處理大量記錄方面非常實用。
最終裁決:Kimi K3 值得使用嗎?
Kimi K3 在目前的前沿 AI 模型中佔有一席之地,特別是在程式編碼、長上下文處理和代理式研究工作方面。它並非在每個基準測試中都是最強的模型——獨立評分顯示它在通用智力指標上落後於最頂級的模型一小步——但它已經足夠接近且價格足夠低廉,使其成為一個嚴肅的選擇而非僅僅是小眾替代方案。
最適合的用戶: 在大型程式碼庫中工作的開發者、處理長篇文檔的研究人員與學生,以及追求高性能且不希望支付溢價定價的企業。
主要優勢: 1M token 的上下文窗口、強勁且部分經獨立驗證的編碼表現,以及極具競爭力且對緩存友好的定價。
主要局限: 某些基準測試說法仍依賴廠商自行運行的評估而非完全獨立的複製實驗,輸出速度落後於部分競爭對手,且評測時開源權重尚未公開。
如果您的工作負載符合它的強項,Kimi K3 非常值得與您目前的配置進行對比測試。
常見問題解答
1. 什麼是 Kimi K3?
Kimi K3 是 Moonshot AI 於 2026 年 7 月 16 日發布的旗艦大語言模型,擁有 2.8 兆參數、100 萬 token 的上下文窗口,並具備原生視覺理解能力。
2. Kimi K3 是免費的嗎?
用戶可以透過 kimi.com 和 Kimi 行動應用程式免費直接使用;而 API 訪問是付費的,定價為每百萬輸入 token 3 美元,每百萬輸出 token 15 美元,緩存輸入享有 0.30 美元的優惠費率。
3. Kimi K3 比 ChatGPT 更好嗎?
兩者處於競爭狀態,而非絕對的誰優誰劣——K3 在上下文窗口大小和某些編碼基準測試中領先,而 ChatGPT 在生態系統成熟度和整合度方面仍保有優勢。更好的選擇取決於您的具體工作負載。
4. Kimi K3 適合寫程式嗎?
是的。獨立與廠商基準測試均顯示其具備強大的編碼表現,特別是在前端開發、偵錯以及跨大型倉庫的代理式編碼任務上。
5. Kimi K3 用於什麼?
它被定位於軟體工程、長文檔分析、研究以及代理式知識工作——這些任務能從其大上下文窗口和編碼強項中受益。
6. Kimi K3 值得使用嗎?
對於注重上下文、側重編碼或以研究為導向的工作流,是的。對於不需要利用其特定優勢的簡單日常聊天,與替代方案相比,它是一個紮實但非必選的選項。